
写在前面。 这是我开发 PandaForce 时随手记的一篇。文里说的 develop,是 GitHub 仓库的开发分支,不是发布版本。这批功能还在做,离正式发布还早。
摘要
上一次写 PandaForce,讲的是人离开电脑之后,怎么接着用 Codex。最近 develop 分支又往前走了一段:项目资料、文档、知识检索、技能,还有从外部系统提交进来的 Bot 任务,现在能放在同一个工作台里了。企业可以把它装在自己的机器上,数据留在自己手里,再把 AI 接到现有的业务系统上。
我真正在意的,是这些东西凑到一起能省掉哪些事。老员工一遍遍解释的判断标准,新人每次重新翻找的资料,运营每天在几个系统之间复制粘贴的任务——这些才是我一直做这个开源项目的理由。
第一部分 · 从一个人用,到一个团队一起用
01develop 分支最近在做什么
一个人用 AI,挑个顺手的模型,备几段提示词,就能办不少事。到了公司里,事情没这么简单:资料散在不同人手上,判断凭什么得讲清楚,做出来的东西还要交给下一个人,最后往往还得回到业务系统里去。模型写出一段漂亮的文字,常常只是整件事的开头。
PandaForce 这轮更新,补的就是「开头之后」那一截。原来的会话和编程没动,管理员照样能看到工具执行了什么、文件改了哪里,也能卡在审批那一步把关。新东西是工作台,它把内容和业务任务一起接了进来。
一个项目里,工作目录、文档、会话、创作产物都能放在一起。文档能改、能回退到旧版本,也能让 AI 校对、改写、翻译——改完先摆在那儿,你看过了再决定要不要应用。自己的东西可以先单独存着,等要交出去了再塞进项目。几天后再打开,你手里还是一份能接着用的成果,而不是一段聊完就散的对话。
资料攒多了,可以在项目里搜,也可以把现成的 Markdown、Hexo、Docusaurus 内容接进来,再挑其中几份作为知识任务的依据。「怎么做」这件事则交给技能:起草需求、评审技术方案、整理会议记录,各自有一套相对固定的步骤。至于那些得由业务系统来发起的活儿,就交给 Bot 接着处理。
这些都已经在公开的 develop 分支上了,仓库里也有一份中英文完整功能清单。本文以 2026 年 11 月 16 日的源码为准——旧的 Docker 镜像,不会因为 develop 往前走了就自动长出这些功能。[1]
02团队交接时,少重新解释一遍
拿一份产品需求来说。一开始可能就是几段会议记录,后来陆陆续续补进接口约束、页面说明、几次讨论的结论。到最后,产品经理要的是一份能拿去评审的需求稿,研发想知道哪些约束已经敲定,测试还得从里面抠出验收条件。同一堆材料,三种人想从里面拿走不一样的东西。
在 PandaForce 里,这些资料可以归到一个项目里,挑好来源和技能先起个草,再在文档上接着改。AI 的改动你能一条条看过再决定;已经定稿的正文也存得住、找得回。下一个接手的人有了明确的起点,不用再从谁的聊天记录里一点点把背景拼回来。
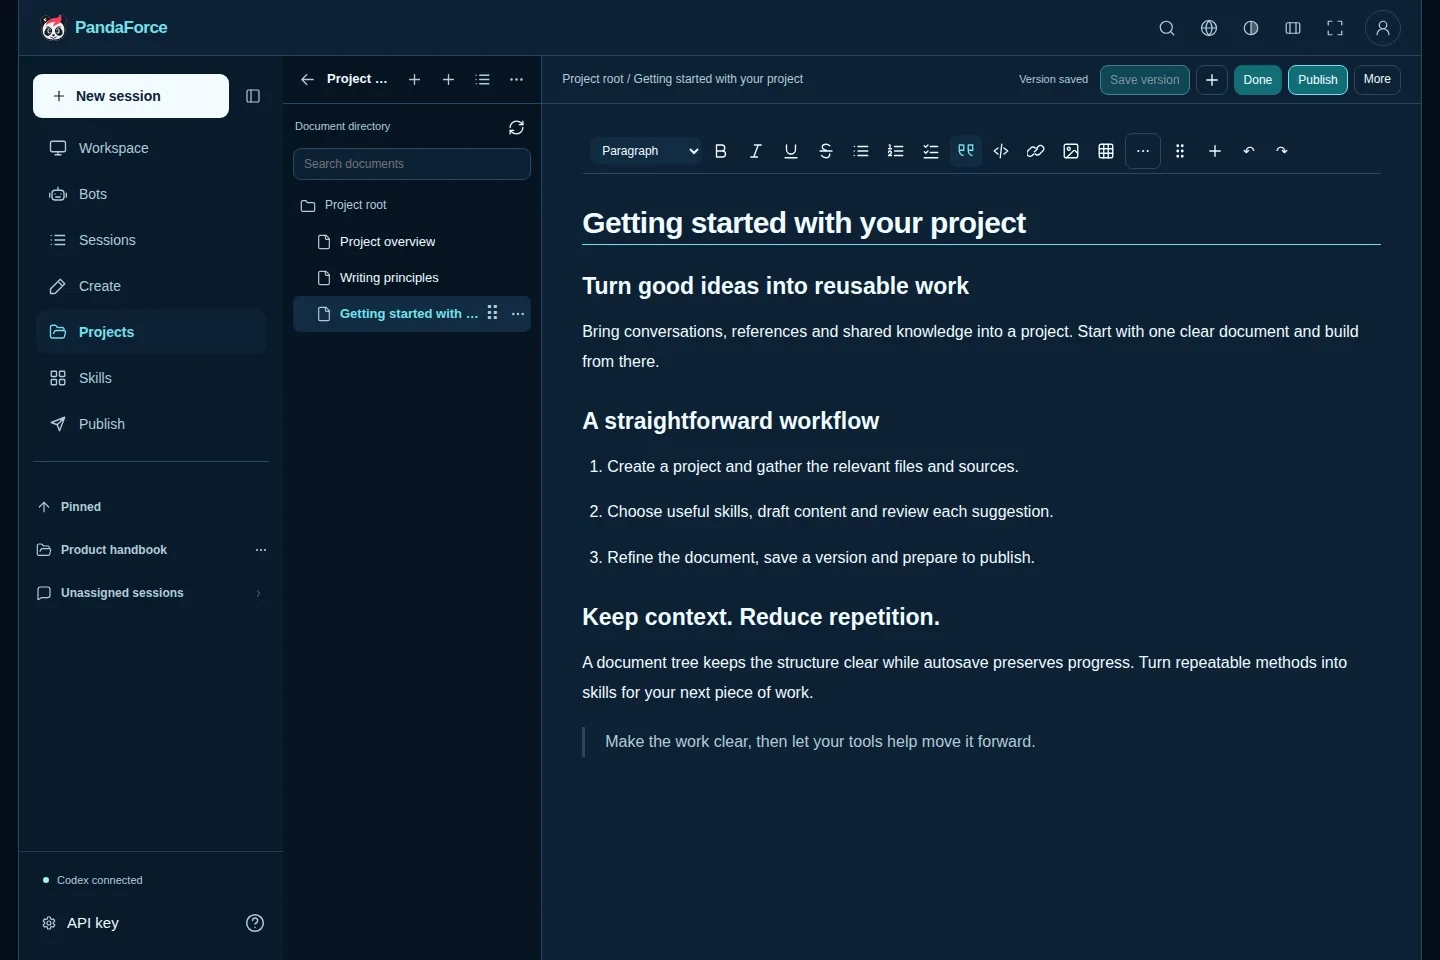
图 1 · 资料和成果都留在项目里。 截图是当前前端的文档工作区,内容为虚构的演示数据。AI 的改动都是在已有内容上接着做,不是另起炉灶。
眼下的协同,是围着有权限的业务内容转的:一个人整理资料,一个人借 AI 起草,最后由真正要拍板的人审一遍、交出去。多人光标那种实时同屏编辑,还有组织架构同步,这次都还没做。
账号可以在本地管起来。管理员第一次初始化,不用先准备邮箱;等要拉人进来了,再配 SMTP,成员收到邮件自己设密码。电脑和手机是同一套工作台,人不在工位上也能看任务、回个问题。对一个要担责的人来说,少说一句「等我回到电脑前再弄」,就已经值了。
东西做完了总要交出去。现在支持的导出、建站和发布流程,能把文档变成能读、能交付的材料。已有的知识站点也不用推倒重来:支持的来源能导进来,导入过程中原件保持只读,之后按你自己的节奏发布。
第二部分 · 把熟练做法留下来
03从老同事的判断,到可以复用的技能
公司里有很多知识,落在文档上就一句话,真做起来全靠经验撑着。
拿「商品卖点必须有依据」这一句来说。熟手心里门儿清,这句话背后其实藏着一串判断:面料描述,可以拿材料成分表来佐证;样衣只是按某一个尺码做的,称出来的克重只能代表那个尺码,不能当成整个系列都这么轻;照片上看着像刷了层涂层,也不等于真做过防水测试、能写上「防水」两个字。这些门道,新人是看不出来的——他只读到「要有依据」几个字,多半不知道该去查什么、凭什么下判断、材料不全时又该怎么办。
这种藏在经验里的判断,特别适合整理成一个技能。所谓整理,说白了就是把熟手脑子里那套检查顺序,一步一步落到纸面上。拿「商品卖点提炼」举例,一份能先拿来试用的技能,可以这么约定:
先读本次提供的属性、检测信息和使用限制。每个候选卖点都要给出依据;依据不足的,单独列成待确认项。输出时保留适用尺码和使用条件,不给没有证明的性能添话。最后检查标题、卖点和详情之间有没有自相矛盾。
说到底,知识资料管的是「事实」,技能管的是「做法」,两样都得有人常年照看。指望把一整本规章制度一股脑丢给 AI 就万事大吉,是行不通的——「把那些没写明的判断讲清楚」这道工序,绕不过去。
我在之前那篇 Lattice 文章里写过,怎么把架构经验整理成一个 Skill:动手写代码之前,先核对业务身份、模块归属、依赖方向。这回在 PandaForce 里做技能管理,走的还是同一条路。商品运营有商品运营的判断,技术评审有技术评审的查法,与其让它们留在某个人脑子里,不如明明白白写下来、传下去。
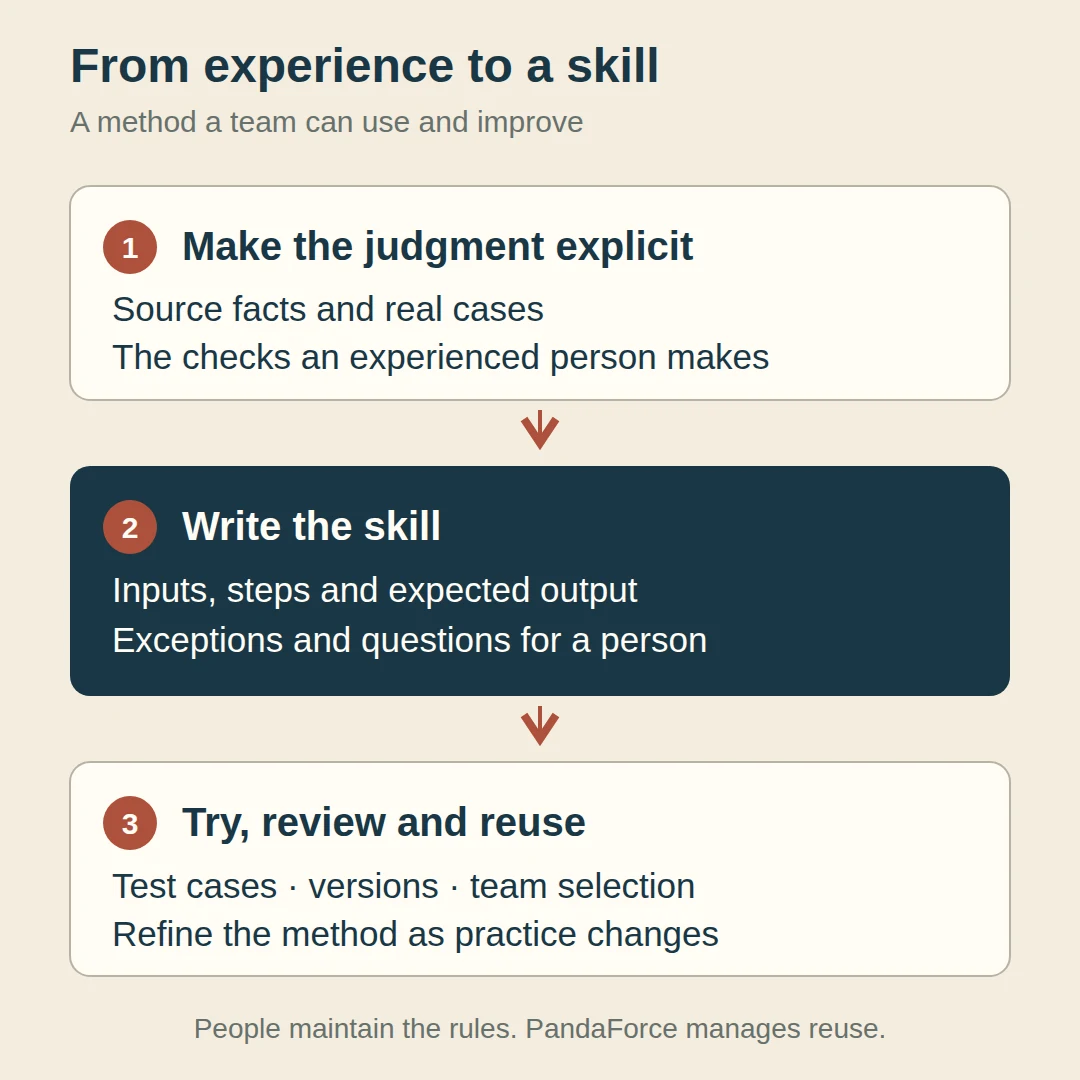
图 2 · 从经验到技能,中间得有人认真整理一遍。 安装、挑选、版本管理这些 PandaForce 管;规则怎么写、拿案例验证、好不好用,还是人说了算。它不是悄悄帮你训一个专属模型。
04同一件事,少从头教几次
develop 分支里,技能能按分类找,来源、版本、许可证、需要什么权限都看得到;从支持的技能包里挑着装,还能组合起来用、配上参数。要升级得先审一遍,版本能按流程切换,也能回滚。那些停用了、删掉了、或者授权不够的技能,不会再混在真正能用的候选里。
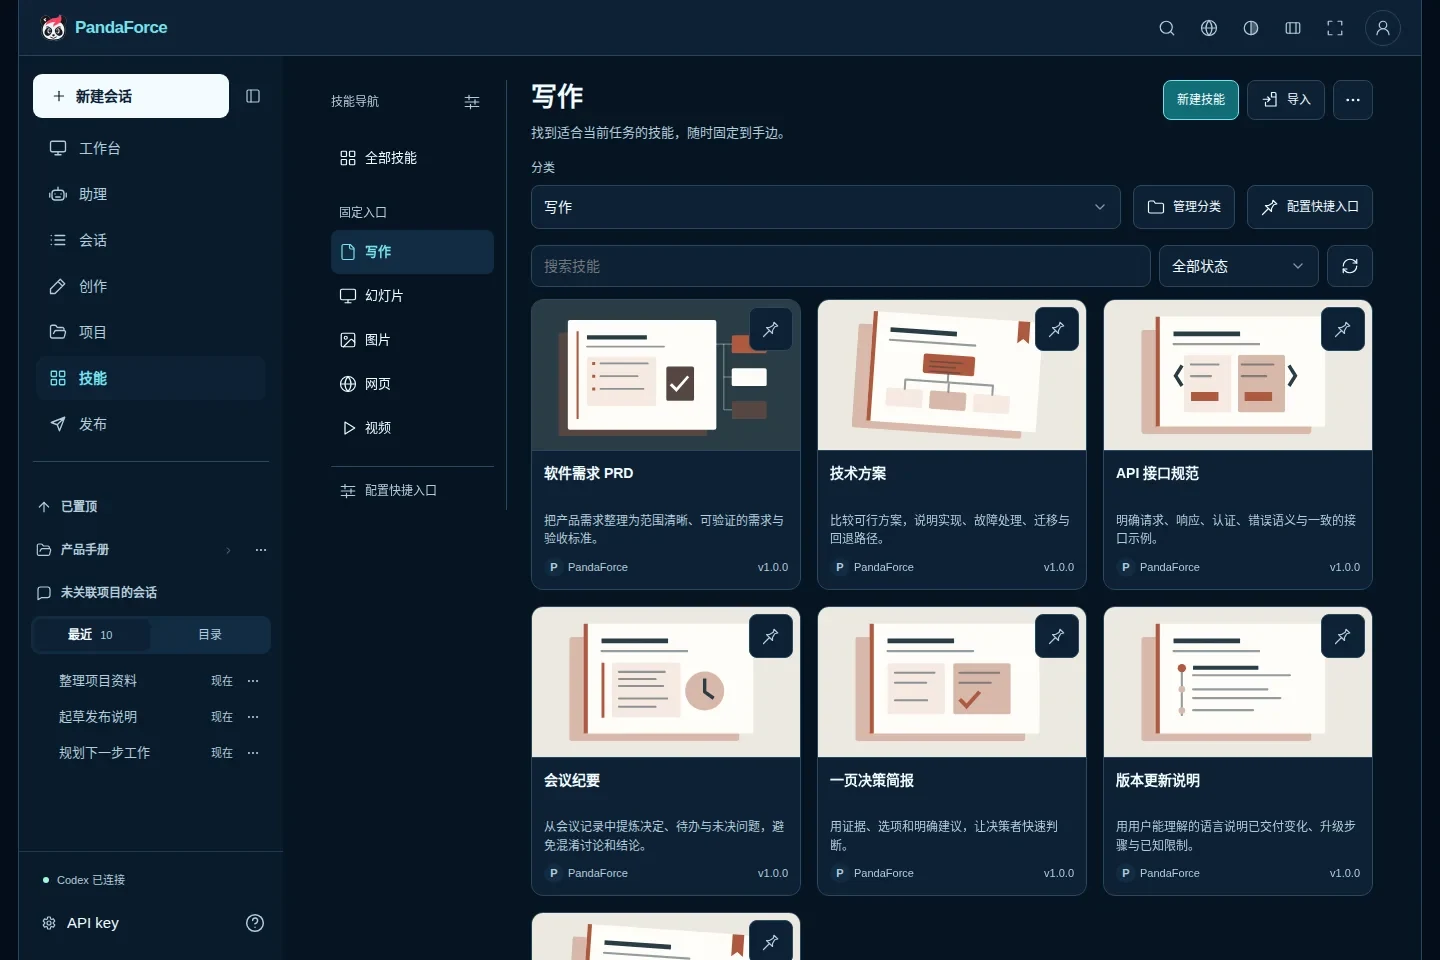
图 3 · 团队复用的,是一套能持续维护的做法。 每个技能有名字、用途、版本号;用的人挑着用,管的人有地方更新、停用。截图为演示内容。
这种复用省在哪,放到具体活儿里一看就懂。新人头回写需求,不用先满世界找老同事讨一整段提示词;同一类报告,不用每个人各自重新搭一遍章节;检查规则变了,维护那一个技能就行,不用追着每个人去改他们各自收藏的那段话。
技能写得好,审的人也能把力气花在真要动脑子的地方——事实够不够、这个例外成不成立,而不是一遍遍补漏掉的章节、改同一种别扭的措辞。技能到底省不省事,拿几份过去的任务跑一遍就知道:少问了哪些翻来覆去的问题,少改了哪些老毛病,还剩哪些风险非得人来盯。
对公司来说,这种积累有个更长远的好处。一件事做完,团队拿到的不只是结果,还有一套更成熟的做法。等人换了、活儿交出去了,这些经验还能接着用,而不是跟着某个人的聊天记录一起没了。
第三部分 · 让现有业务系统也用起来
05Bot:把 AI 接进企业的日常运营
企业运营里有一类活儿,天天都在干,步骤还几乎一模一样:打开一批资料,读文字、看图、核对信息,再换个格式整理出来,递给下一个人、下一个系统。商品上新、工单处理、内容审核,走的都是这个套路。单拎一件出来不难,架不住量大——一天攒下来,就是实打实的一大块时间。
这些活儿背后,往往早有业务系统在管着。商品系统清楚哪批素材刚进来,客服系统清楚哪些工单还压着,需求系统清楚哪份文档进了评审。我的想法很简单:把 PandaForce 的 Bot 接到这些环节上,让业务事件自己把 AI 叫起来干活。员工照旧在熟悉的系统里操作,只是后台悄悄多出一段能自动跑完的处理。
多模态模型让这段处理能把文字和图片搁一块儿看。比方说,把商品照片、标签、属性说明对到一起,挑出站得住脚的卖点,理成一份商品详情草稿;再比如把用户的文字描述和报错截图一起读,归纳出问题、补上摘要、给个分类建议。原来得一项项打开、抄录、改写的东西,现在能成批地过一遍。
而且 Bot 做完一单,交出来的不是一段聊天式的文字回复,而是能直接往下用的东西:认出来的那些事实,可以变成文案、主题方案、图文说明或审查意见,接着送进后面的业务环节。真到了生成图、修图、做最终排版那一步,把整理好的要求交给企业现成的设计或渲染服务就是了。Bot 管的是读图读字、做判断、把内容理顺;真正的素材制作,还是落在接进来的那些服务上。
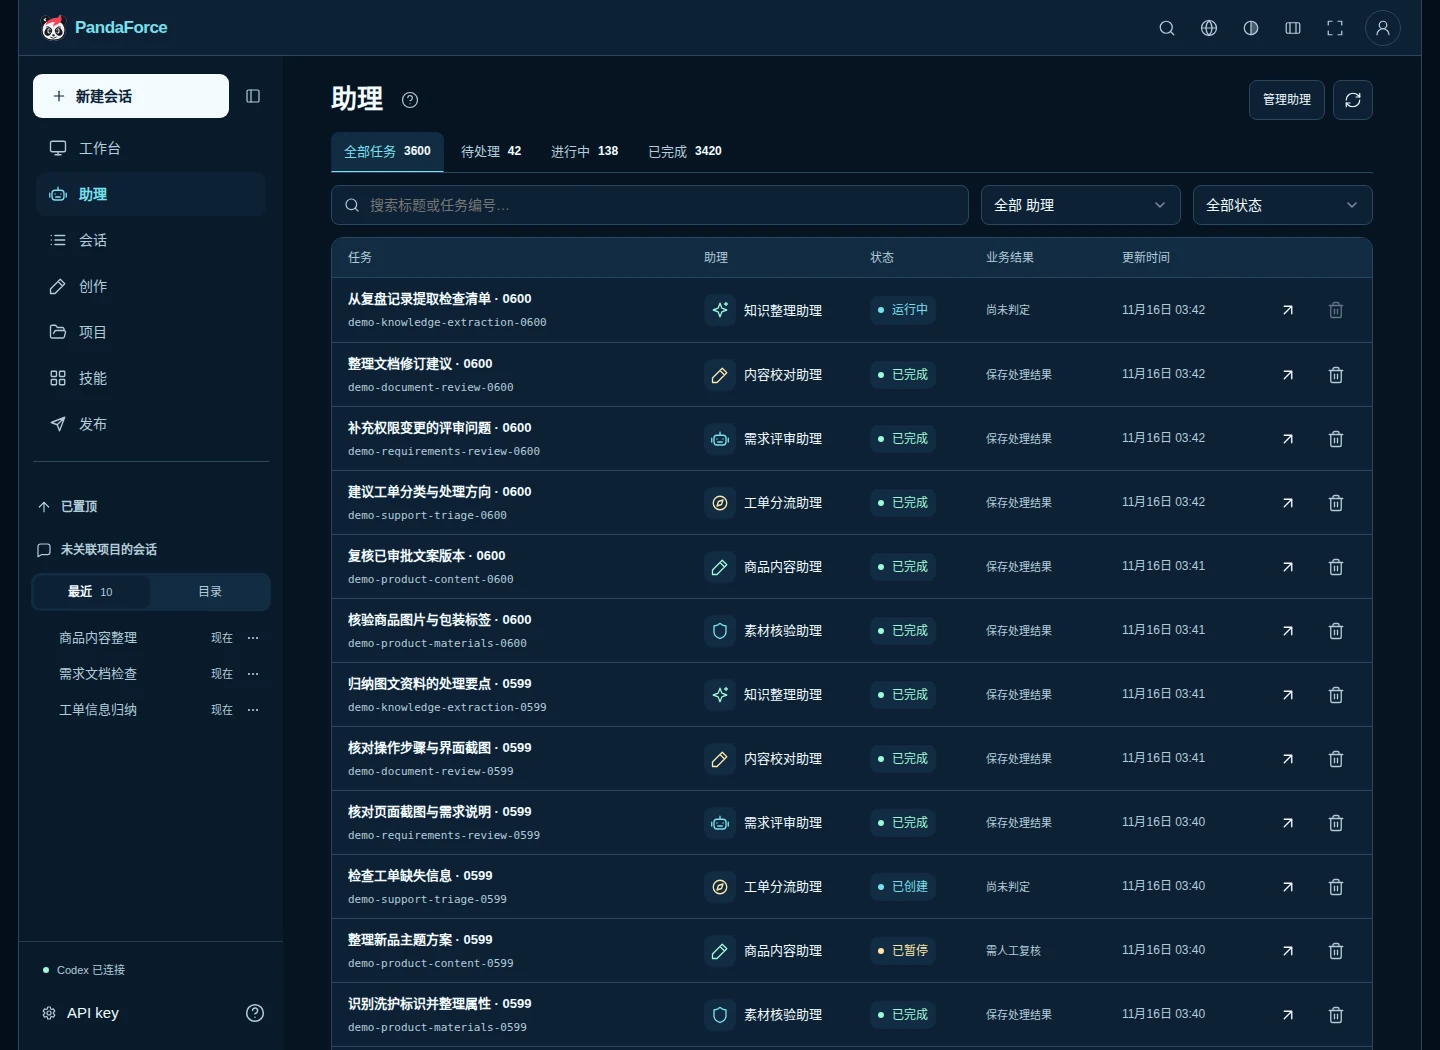
图 4 · 各种业务任务,在同一个列表里管。 为了演示界面,我在隔离环境里造了 3,600 条虚构任务,分给 6 个 Bot。这些统计数字来自演示库,既不代表真实业务量,也不是并发能力的测试结果。看完整截图。
任务一多,运营最先要的就是看得清:哪些做完了,哪些还排着,哪些卡在资料不全、或者拿不准。任务列表能按助理、状态、关键词筛,点进任意一条,都能看到它的处理记录。碰上要复核的,Bot 会把问题留在那条任务上,等人补了料再接着往下走。人主要盯着存疑和例外的那部分,用不着每条都从头读、从头写。
说完它干的活,再说说一个 Bot 是怎么配出来的。接一类活儿进来,核心就是给它配一个 Bot:写清处理要求、挑好模型、圈定允许回调的域名。一类活儿对一个 Bot,要求全写在它自己的配置里;往后规则改了,在这一处动一下就行,用不着挨个去碰下游的业务系统。
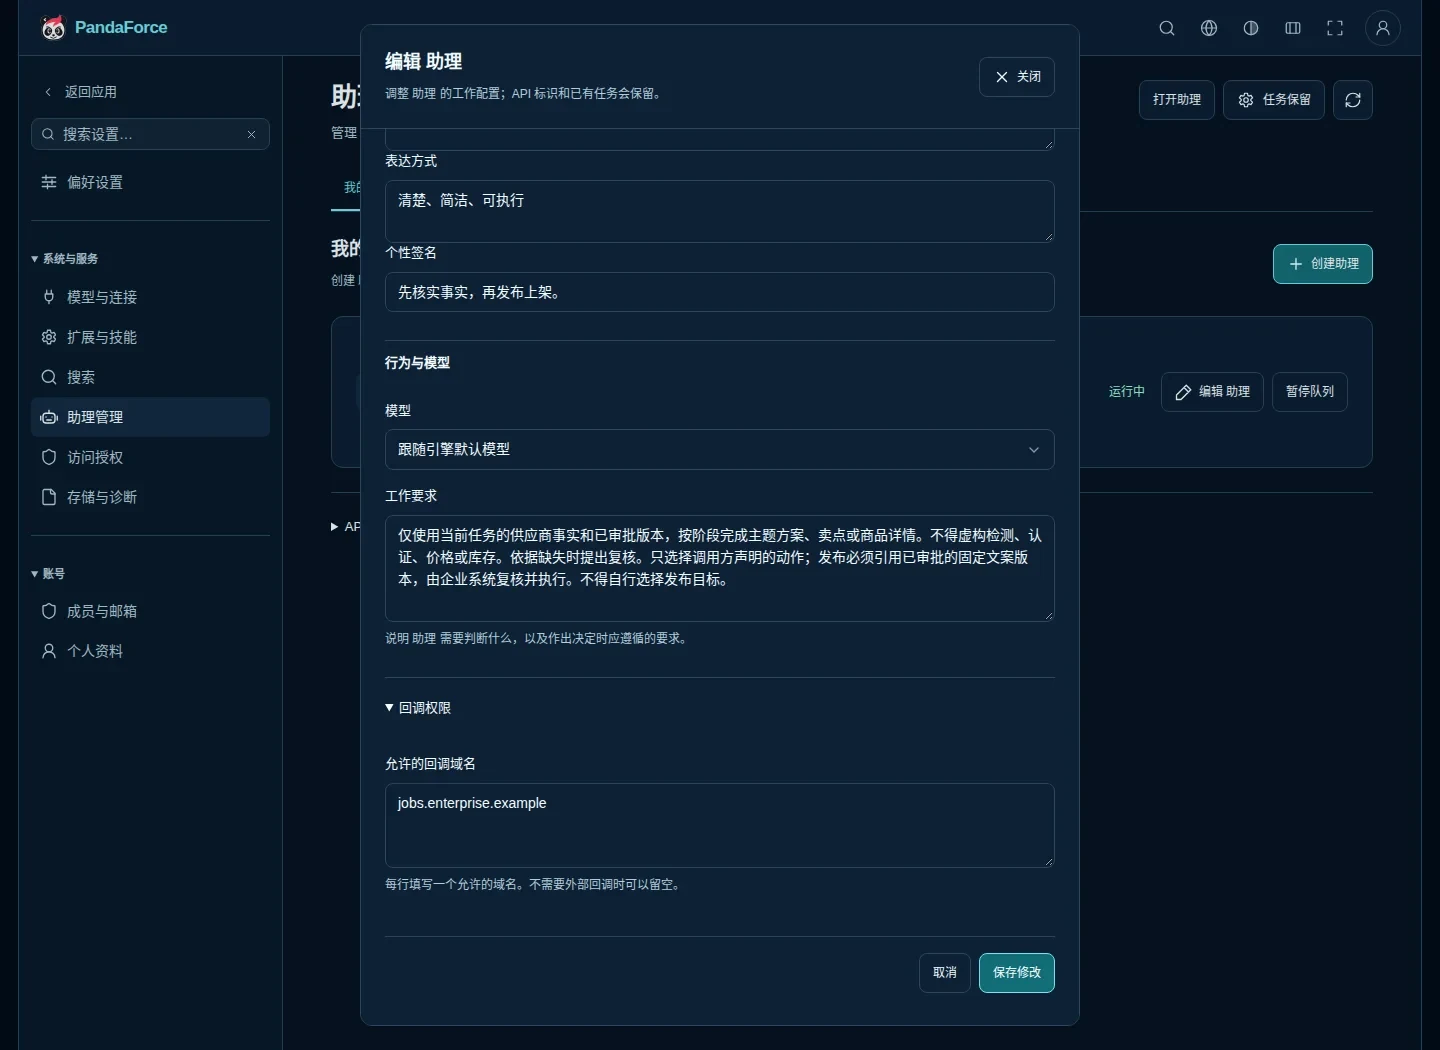
图 5 · 把一类活儿的要求,写在 Bot 的配置里。 这个示例要求助理只按素材里的事实处理商品任务,不许编检测数据;接口地址用的是占位域名,没放任何真实配置和密钥。
配好之后,业务系统就能调 POST /api/v1/bots/{code}/tasks,把当前材料、自己那头的任务号,连同允许 Bot 做哪些动作,一起提交过来。排队、处理、记结果这些归 PandaForce 管;接入方想主动查就查,想等回调也行。权限、审批、库存、发布照旧在企业系统里跑,Bot 用不着再自己搭一套业务数据库。[2]
这么接下来,好处挺实在。接入的团队可以把劲儿都使在数据怎么转、结果怎么用上,不必再自己搭一套任务管理和人工复核的界面;运营那头少搬点资料、少做些重复初审,把时间留给真正要经验的判断。这套接法值不值得再往下铺,也能从具体的活儿里看出来:人工改了多少初稿,回头补问了多少缺项,原先那些复制粘贴的步骤还剩多少。
06Bot 集成实战:商品发布流程
下面拿一个匿名的商品发布例子讲讲。里面的任务和截图都是演示数据,没真上过架,也不牵扯任何品牌或销售渠道。
供应商发来一包外套素材:正反面照片、属性表、尺码表、洗护说明。企业现成的素材服务先把包解开,原件存好,把该提的文字提出来,再标上素材版本。真正递给 Bot 的,是这次任务用得上的那些事实和图片;那个原始 ZIP 怎么处理,还是接入方自己的事。
接下来,可以按企业自己的流程,一段一段交给 Bot:
- 核对素材。 哪些事实是齐的,哪些缺着,图片和属性对不对得上。
- 提主题和卖点。 就着已经确认的事实,给出主题方向、文案角度和站得住的卖点,交给设计和运营。
- 写商品详情。 把标题、面料、尺码、洗护这些整理成一份能审的草稿。
- 处理复核。 要是冒出没依据的功能描述,就要么补材料,要么改草稿。
- 交给企业的发布流程。 等真审批过了,提交定好的版本,上架由企业系统来完成,最后那张业务回执也留着。
举个例子:素材里写着这件外套 M 码样衣重 260g,却没有防水测试报告。「轻」这个说法得带上尺码前提,「防水」这种性能,则不能自己脑补出来。碰上这种缺口,Bot 会提一个具体的问题,把需要人来拍板的部分单拎出来。
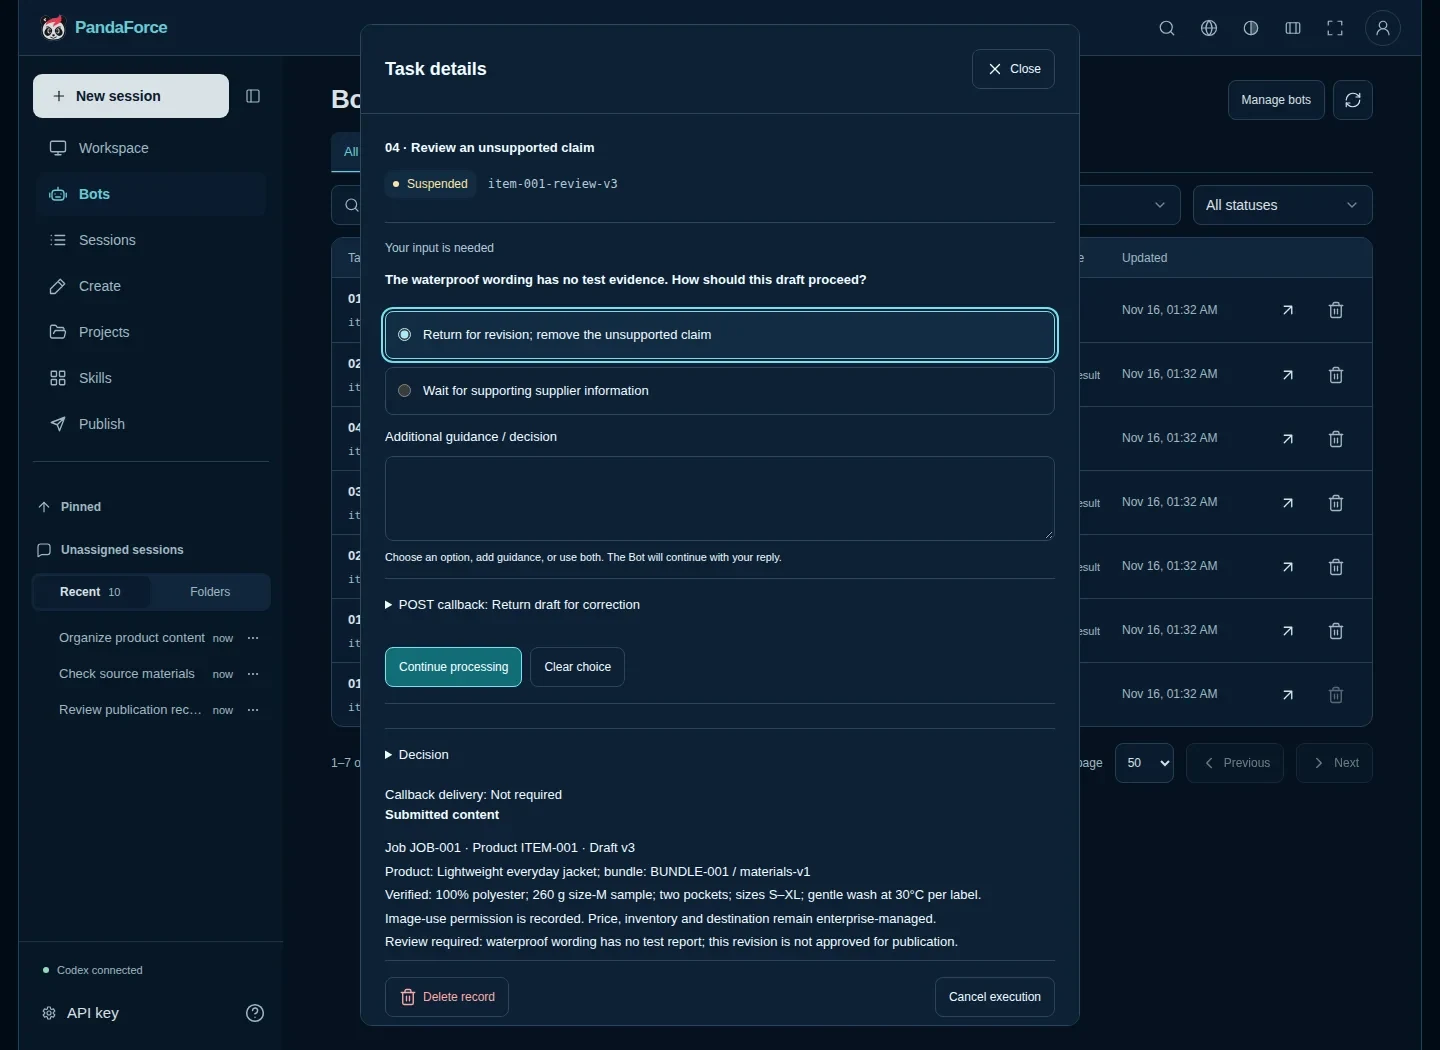
图 6 · 人只管需要判断的那一小段。 这条演示任务,要的是核实防水说法有没有依据。人回了之后就能接着走,整个来回都留在任务记录里。
主题图真要做,还是走企业现成的设计或渲染服务;商品库、价格、库存也照旧归原系统管。PandaForce 接的是中间那段 AI 的活儿和复核的来回,前后怎么串,由企业自己编排。这么接进来,原来的商品团队用不着为了用 AI,再多养一套平行的商品数据。
这么一来,一次商品处理省在哪也就看得清了:运营不用把同一组事实在几个窗口之间来回搬,初稿照固定要求生成,检查的人只碰有疑问的地方,审批过的版本再进现成的发布流程。接口收到了,不等于已经上架——最后到底成没成,还得以企业系统那张回执为准。仓库里的完整案例给了配置、请求、复核和回执的示例。
07需求初审和工单分流,也可以用同一套接法
商品只是一个例子。下面这两种场景,用现在的 Bot 接口一样做得出来——前提是企业得自己补上各自的接入逻辑,它可不是已经带好了某款业务软件的现成连接器。
需求初审。 产品经理一提交需求,需求系统就把正文、已知的约束、这次的检查规则一并丢给 Bot。它先看目标、使用场景、异常分支、验收条件齐不齐,把「暂时判断不了」的都列成问题。产品经理补完再往下走。最终评审还是团队的事,但开会之前,那些翻来覆去的基础问题可以先消化掉一批。
工单分流。 客服系统把用户的描述、产品版本、以及能给的上下文交给 Bot。信息够了,它就建议个分类、理个摘要;少了复现步骤,就回头要;有冲突、或者超出能处理的范围,转人工。真正派单、回复客户,还是走企业现有的权限。这里头最先省下来的,是读长描述、理背景、追问那些基础信息的时间。
这两种场景,都不用员工先学一套新的聊天习惯。日常进去的还是那个熟悉的业务系统,PandaForce 在后台接住 AI 任务,需要的时候给一个能动手的复核页面。团队可以先接一条线,觉得行再往外铺。
第四部分 · 企业自己部署,也自己掌握选择
08私有化部署,对企业的价值在哪
做企业系统这些年,有件事几乎是共识:数据是企业的命根子,没人愿意把它交到外面去。客户手里本就有自己的服务器、存储和一整套在跑的业务系统,接 AI 这件事,最好是接到自己家里,而不是把一摞资料往别人的平台上搬。PandaForce 就是按这个前提做的——装在你自己的环境里,项目、文档、任务记录都落在自己的机器上,账号和权限也由自己说了算。私有化部署最实在的价值,就是这份「东西始终在自己手里」的踏实。
更要紧的是模型这一层。Codex CLI 本身只是个命令行工具,负责跑 agent 流程——规划、读写文件、调用工具,一步步把活儿做完;真正做推理的大模型是单独配上去的。把它指向企业内网的 Ollama、或是别的自建大模型,从资料进来到结果出去,推理全程待在自己的网络里,一步都不出门。对那些把数据看得极重的行业,这几乎是唯一能放心用 AI 的方式:能力用上了,敏感内容却一点没往外漏。[4]
再往底下,是开源给的底气。PandaForce 用的是 MIT 许可,能商用、能照自己的需要改、能自己部署;整套实现你可以从头翻一遍,留住属于自己的版本,接入代码也自己写。对企业来说,这意味着不被哪一家供应商绑死——系统在自己手上,数据在自己手上,往后怎么走,也由自己定。[3]
09可以先选一件每天都在重复的工作
想试试本文讲的这些还在开发中的功能,得从 develop 分支的源码自己构建。仓库里给了一个 Compose 构建的覆盖文件:
git clone --branch develop https://github.com/hiforce/panda-force-free.git |
起来之后,先建一个本地管理员,再给真正跑的那个 Codex 配上模型认证。要拉成员进来就配 SMTP;要跟业务系统连,再建一个范围划清楚的 Bot。具体的环境和认证步骤看分支 README——别把普通的工作台账号,当成模型账号用。
第一件事可以挑得很小。找一类经常重复、材料比较清楚、结果又好检查的任务,把最懂这件事的人拉进来。一块儿把规则理出来,拿过去的例子跑一跑,看哪些步骤值得交给 AI,哪些问题还是得留给人。等要跟系统对接了,再把提交和结果处理补上。
我希望 PandaForce 能让这样的尝试更容易起步。企业现成的资料接着用,人的经验慢慢整理成技能,业务系统通过 Bot 来调这些 AI 的能力。每做完一批任务,都能攒下下回用得上的内容和方法。
项目还在接着做。源码、安装说明、案例都在 PandaForce 开源仓库。也欢迎把具体的使用问题拿回来跟我说:哪一步接不进去、哪个技能不好使、哪个任务还得让人反复搬资料——这些反馈会直接决定接下来做什么。
项目资料
- PandaForce develop 分支:完整功能清单(本文对应源码)。包含协同、创作、技能、知识、账号及部署条件。
- Bot 商品发布集成案例。包括任务接口、受限密钥、人工复核、回调和业务回执。
- README:源码构建、部署与 MIT 许可。
- 模型服务配置。模型认证、运行环境和本地服务需要分别配置与验证。