<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>Rocky Yu</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://ryu.xin/zh/</id>
  <link href="https://ryu.xin/zh/" rel="alternate"/>
  <link href="https://ryu.xin/zh/feed.xml" rel="self"/>
  <rights>All rights reserved 2026, Rocky Yu</rights>
  <subtitle>关于软件工程、人工智能、组织与人的长篇思考</subtitle>
  <title>软件、AI 与人</title>
  <updated>2026-08-08T16:00:00.000Z</updated>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Books" scheme="https://ryu.xin/zh/tags/Books/"/>
    <category term="Programming" scheme="https://ryu.xin/zh/tags/Programming/"/>
    <content>
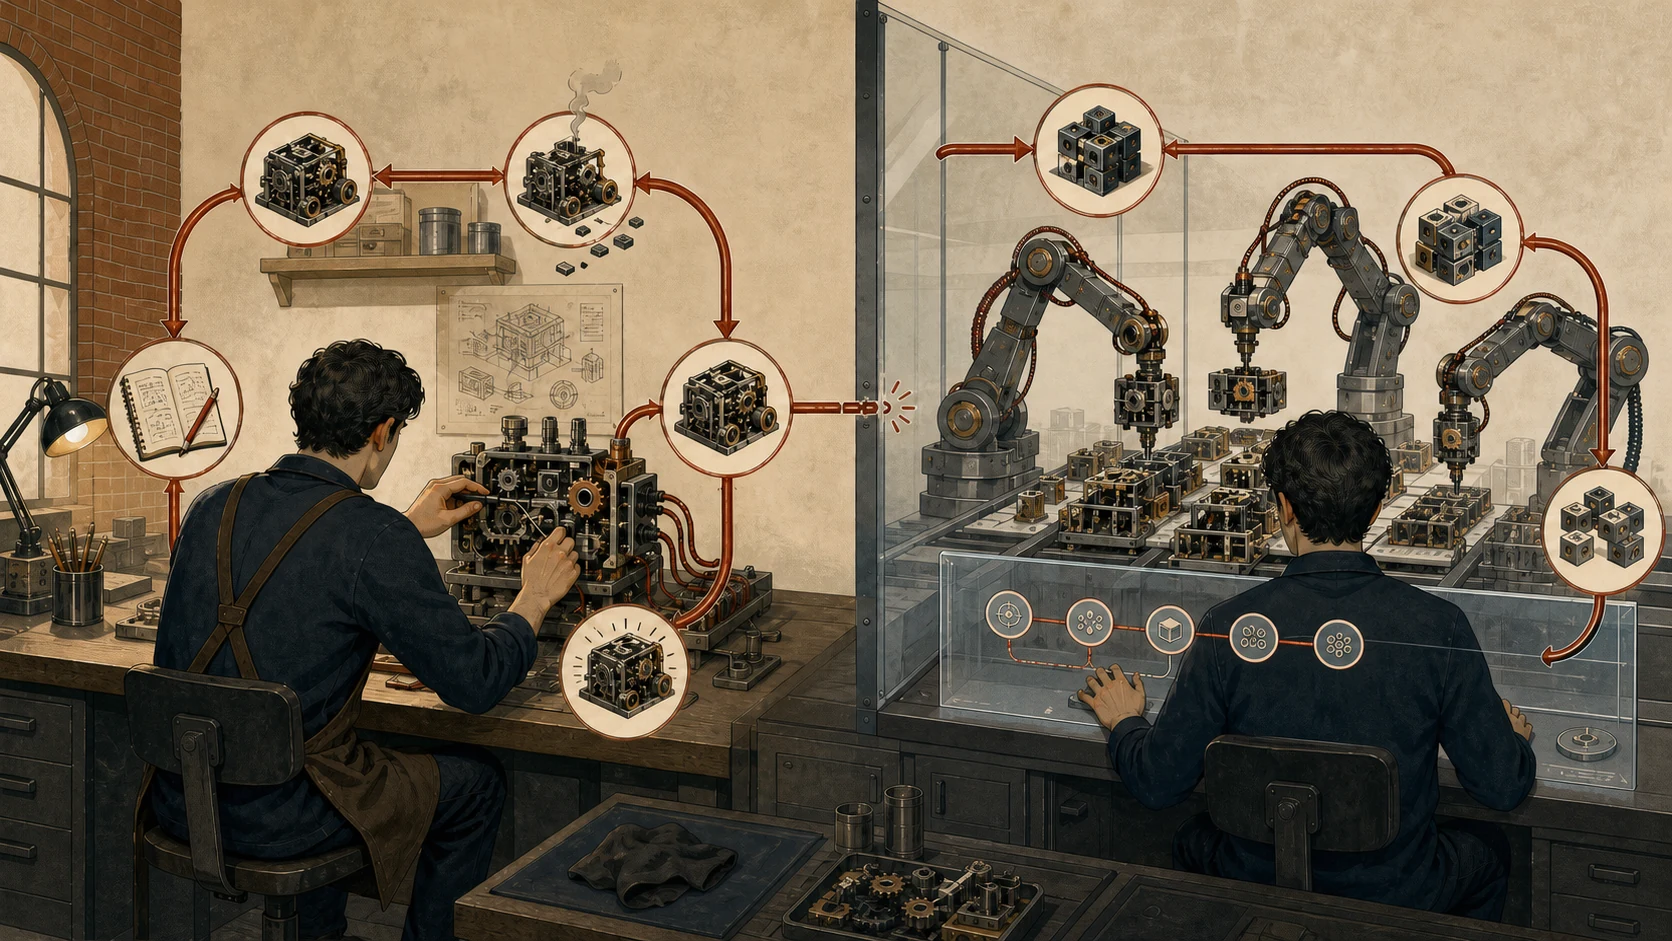
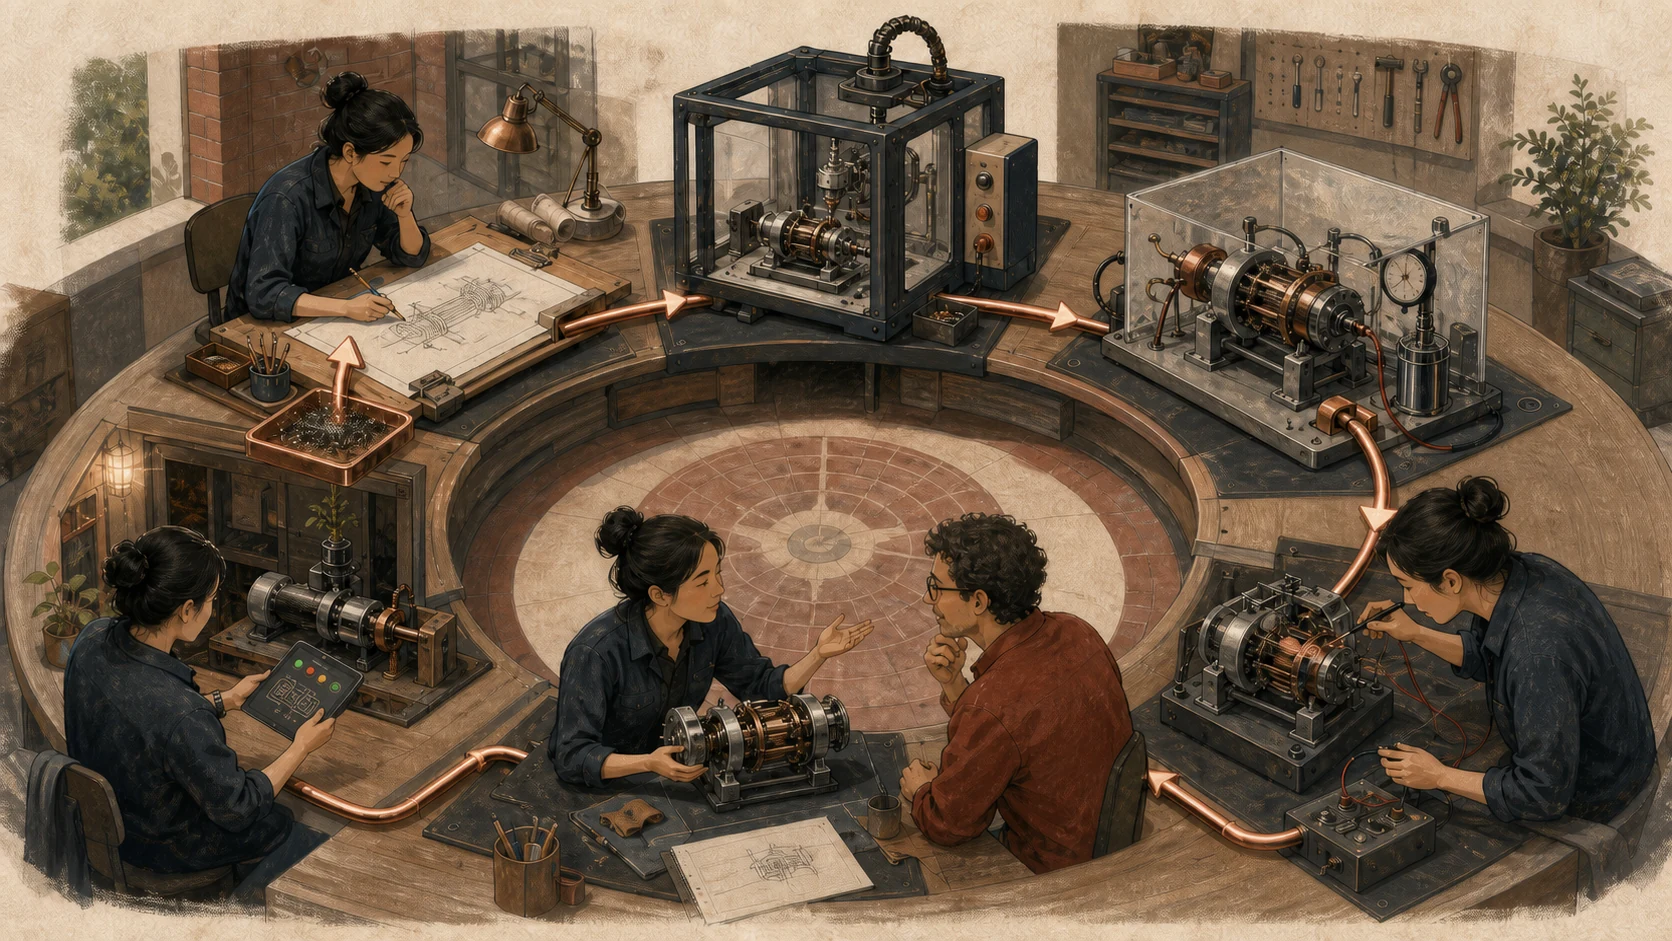
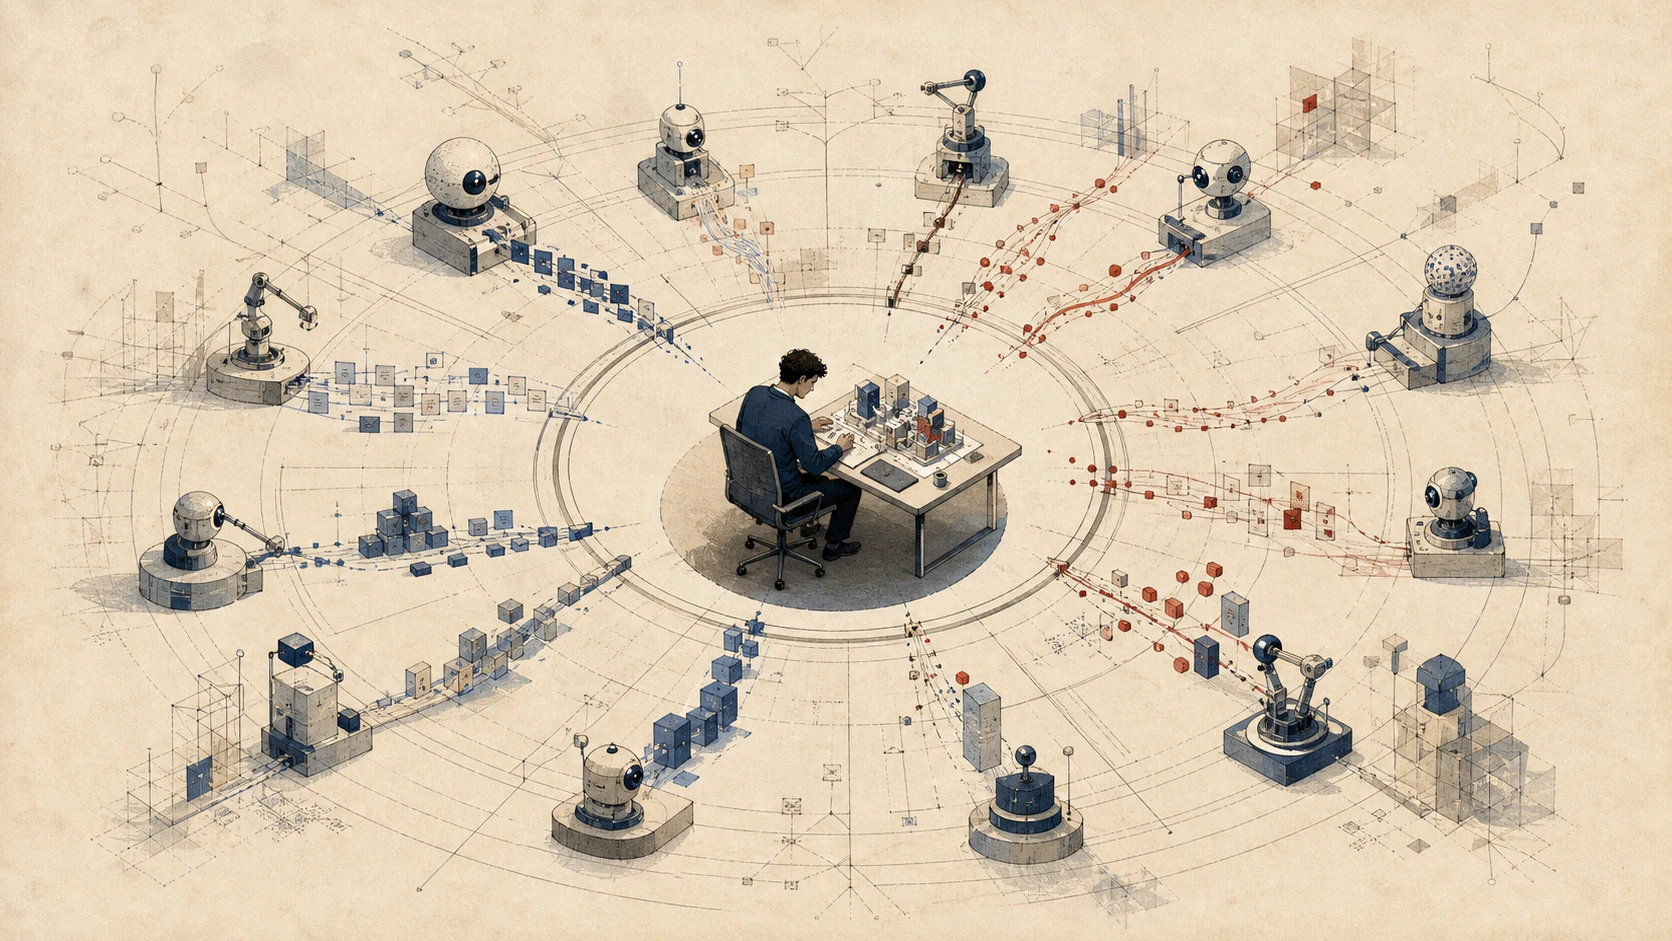
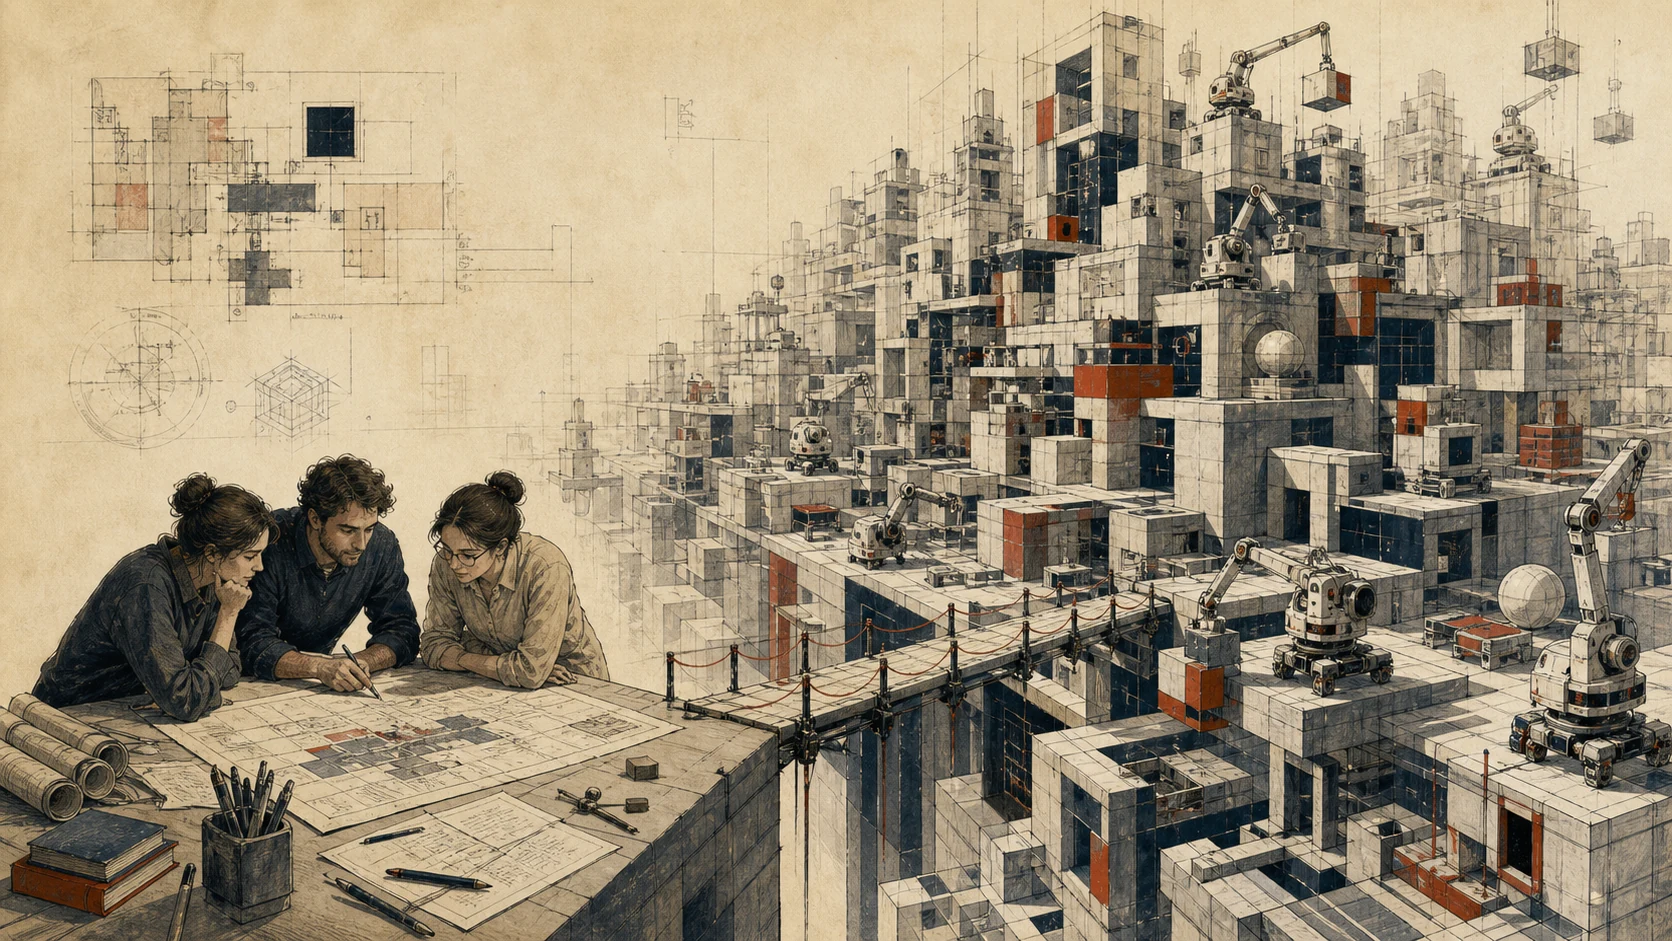
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>《计算机程序设计艺术》《代码大全》《重构》《设计模式》《人月神话》不会因为 AI 能写代码就失去价值。真正的风险在别处：程序员过去通过亲手实现、排查故障、维护旧系统和承担后果，把书中的概念变成工程直觉；AI 却可能让人越过这些过程，直接抵达一份看似完成的结果。</p><p>因此，经典知识面临的不是内容过时，而是传承路径断裂。我们不必把下一代赶回纯手工编程，也不应把痛苦浪漫化。需要保留的是另一组东西：对结果作出预测，进入实现细节，观察因果反馈，解释设计选择，并长期承担系统后果。只有把这些环节重新嵌入 AI 工作流，经典才不会从实践智慧退化成提示词。</p></header><p class="thesis">程序员文化真正需要传承的，不是手工敲代码的仪式，而是与复杂性保持直接接触的能力。经典著作是被压缩的经验；AI 时代的任务，是重建一条能让这些经验重新展开的学习回路。</p><p class="part-label">第一部分 · 经典保存的不是答案</p><h2 id="从“这些书还有用吗”说起"><span class="section-no">01</span><a href="#从“这些书还有用吗”说起" class="headerlink" title="从“这些书还有用吗”说起"></a>从“这些书还有用吗”说起</h2><p class="lead dropcap">最近我问自己一个听起来很实际的问题：《代码大全》《重构》《设计模式》这些书，在 AI 时代还有多大作用？最顺手的回答是，它们当然有用，因为人仍要判断 AI 写出的代码好不好。这个回答没有错，却避开了更难的部分：一个没有亲手被坏代码折磨过的人，凭什么获得这种判断力？</p><p>我们这一代人对“坏味道”的认识，往往先于术语。那种不舒服，是身体先知道的。改一个几千行的方法，修好了 A，B 却在另一个文件里悄悄裂开；你盯着屏幕，隐约觉得这段代码“不对劲”，却一时说不出到底哪里不对。沿着十几层调用去追一个含义暧昧的字段，越往下越像走进一栋不断加盖的老楼，每一层都留着上一任住户的隔断和走线，谁也不敢先拆哪一堵墙。面对没有测试保护的共享状态，你在深夜按下发布键，手指会有一瞬间的迟疑——那点迟疑本身，其实已经是一种知识。等到后来翻开书，才知道那些说不清的别扭各有名字：职责混乱、发散式变化、隐式耦合。书没有凭空制造这些感觉，它只是把你身体里早已积攒的经验一一点名，让模糊的直觉第一次有了可以说出口、也可以传下去的词。</p><p>AI 时代的年轻程序员可能走上另一条路：描述需求，生成实现，运行测试；失败后把日志交给模型，修不好就再生成一版。问题仍然发生，复杂性仍在那里，但它不一定直接作用在人的手上。就像每天坐车经过崎岖山路的人，能熟记沿途每一处景色，却未必知道路基为什么会塌；等到某天山体真的滑下来，他既说不清成因，也找不到自己能下手的地方，只能站在原地，等另一个懂路的人来抢修。委派掉的不只是敲键盘的动作，还有“出事时我知道该往哪看”的那份底气。</p><p>所以问题已经从“经典是否过时”变成了“经典赖以生效的经验从哪里来”。</p><h2 id="一整面书架，其实保存着不同层次的手艺"><span class="section-no">02</span><a href="#一整面书架，其实保存着不同层次的手艺" class="headerlink" title="一整面书架，其实保存着不同层次的手艺"></a>一整面书架，其实保存着不同层次的手艺</h2><p>把所有经典都归为“教人写好代码”会低估它们。它们覆盖的是从计算到组织的一整条链。</p><div class="table-wrap"><table><caption>经典工程知识保存了什么</caption><thead><tr><th>层次</th><th>代表性著作与文章</th><th>它们训练的不是</th></tr></thead><tbody><tr><td>计算与抽象</td><td>《计算机程序设计艺术》、SICP、《谦卑的程序员》<sup class="ref"><a href="#ref-1">[1]</a></sup><sup class="ref"><a href="#ref-2">[2]</a></sup><sup class="ref"><a href="#ref-3">[3]</a></sup></td><td>背出算法，而是知道时间、空间、状态与抽象从不免费</td></tr><tr><td>软件构造</td><td>《代码大全》《程序员修炼之道》<sup class="ref"><a href="#ref-4">[4]</a></sup><sup class="ref"><a href="#ref-5">[5]</a></sup></td><td>统一格式，而是把可读性、防御性和个人责任落实到局部选择</td></tr><tr><td>安全演进</td><td>《重构》《修改代码的艺术》<sup class="ref"><a href="#ref-6">[6]</a></sup><sup class="ref"><a href="#ref-7">[7]</a></sup></td><td>把旧代码写得更漂亮，而是在反馈保护下改变仍在工作的系统</td></tr><tr><td>设计语言</td><td>《设计模式》及后来的模式著作<sup class="ref"><a href="#ref-8">[8]</a></sup></td><td>收集类图，而是描述上下文、变化压力与取舍</td></tr><tr><td>系统与组织</td><td>《人月神话》《人件》《没有银弹》、“Programming as Theory Building”<sup class="ref"><a href="#ref-9">[9]</a></sup></td><td>管理口号，而是理解概念完整性、沟通成本与共同心智模型</td></tr></tbody></table></div><p>这些书里，有的厚得让人望而生畏，注定不适合从第一页读到最后一页；有的例子带着上个时代的包浆，讲的是早已退役的机器和语言；还有的观点，本就该被今天的类型系统、框架和工程实践大方地修正甚至推翻。承认这些，丝毫不影响它们的分量。它们至今重要，不是因为每一页都能原样搬进下一次提交，而是因为它们像地层一样，保存了整个行业“如何一步步学会思考”的那段历史——哪些坑是前人替我们踩过的，哪些教训是用真金白银、宕机和加班换来的。读它们，某种意义上是在和几代人对话，听他们说：这条路我走过，别再摔在同一个地方。</p><p>Donald Knuth 把编程称为“艺术”，强调的并非神秘天赋，而是把积累的知识、技巧和创造力用于真实世界。TAOCP 甚至用虚构机器的汇编语言逼读者看清算法在机器上如何付出成本。SICP 则让人反复经历另一种震动：同一个问题，因为求值模型、状态表示和抽象边界不同，会长成完全不同的程序。高级工具可以替我们完成实现，却无法取消这些差异。它只是把差异藏得更深——藏进一份看起来完美运行的输出里，然后在某个规模、某个边界条件上，把当初省下的代价一次性讨回去。</p><h2 id="模式是被压缩的事故史"><span class="section-no">03</span><a href="#模式是被压缩的事故史" class="headerlink" title="模式是被压缩的事故史"></a>模式是被压缩的事故史</h2><p>今天让 AI “用 Strategy 模式优化代码”，几秒钟后就能得到接口、实现类、工厂和测试。形式太容易出现，以至于我们忘了模式原本从哪里来。</p><p>一个模式之所以成立，通常是因为人们在不同系统里反复遇到同一种张力：某个行为确实独立变化；某个外部依赖不断污染核心；一组条件分支本质上表达状态迁移。名称只是压缩后的索引。它背后还有适用上下文、冲突力量、已知后果，以及不用它会怎样。</p><p>以 Strategy 为例。它很少诞生于“我想要一个优雅的接口”，更多是从一个不断膨胀的计费函数里长出来的：普通用户、VIP、限时促销、跨境税率、退款回滚逐项叠加，直到几百行分支没人敢动，改一处就可能破坏另一处。最终，有人把“如何计算价格”这个会独立变化的部分从主流程中分离出来。模式为这种反复出现的变化压力提供了名字。生成一个 Strategy 只需复刻它的结构；理解它，则要判断眼前的代码是否真的承受着同一种压力。</p><p>这也是为什么读懂模式和生成模式不是一回事。生成只需要复现形状；判断则要回答：这里真的存在稳定的变化轴吗？新增间接层带来的理解成本，是否小于未来变化的成本？这个抽象在什么条件下应该被删除？</p><div class="pullquote"><p>经典不是标准答案的仓库，而是一代代工程师把昂贵失败压缩之后留下的索引。</p></div><p>这句话也解释了传承的困难。索引可以复制，索引指向的经验却不能靠下载获得。</p><p class="part-label">第二部分 · AI 改变了经验形成的路径</p><h2 id="旧的反馈回路，既低效又有效"><span class="section-no">04</span><a href="#旧的反馈回路，既低效又有效" class="headerlink" title="旧的反馈回路，既低效又有效"></a>旧的反馈回路，既低效又有效</h2><p>传统的成长路径并不优雅，甚至有点狼狈。程序员亲手写下代码，也亲手在里面埋下雷；过一阵，一个需求变更或者一次半夜的线上告警，让雷炸开。于是他被迫俯下身：追踪状态在哪一行被改写，翻阅一个自己从没打开过的模块，给一段裸奔的逻辑补上第一个测试，再用一系列小到几乎不出错的改动，把系统一点点拉回安全区。这样的循环走过几轮，他身上会长出一种东西——还没动手，指尖就先替他发凉，提前感到“这里危险”。代码评审借给他另一双眼睛，让他看见自己看不见的盲区；长期维护则像一张迟到的账单，让当初图省事的短期选择，连本带利地显出真实价格；经典著作最后出场，把这些零散的、带着体温的遭遇，整理成可以迁移、可以命名、可以传给下一个人的概念。这条回路很慢，却每一步都在往人身上刻东西。</p><p>Peter Naur 在 1985 年提出“编程即理论建构”：程序员真正建立的不只是一份文本，而是一套关于现实问题如何被程序解决的理论。当原团队离开，代码和文档可能还在，这套理论却会消失；接手者必须重新建构它。<sup class="ref"><a href="#ref-9">[9]</a></sup></p><p>这个观点在今天尤其刺眼。凡是接手过“文档齐全、代码尚在、写它的人却已离职”的系统的人，都懂那种无力：每个函数你都读得懂，合在一起却猜不透当初为什么要这样切分；改一个看似无害的默认值，三天后在一个毫不相干的角落引发事故——因为那套把种种权衡串起来的理论，已经随着某个人的离开一起蒸发了。AI 把这件事推到了新的极端。它可以比任何人都快地产出文本，还能对着每个文件侃侃而谈，却不等于团队真的拥有了一套能应对新问题的共同理论。解释，是模型面对当下这个问题、当场生成的一个答案；理论，是维护者在证据不足、约束互相打架时，依然能做出前后一致判断的那种底气。前者可以随时召唤，后者只能慢慢长成。</p><figure class="article-figure"><img src="/assets/articles/software-craft-after-ai/figure-01-broken-learning-loop.webp?v=f0a362254ede0442" width="1672" height="941" loading="lazy" alt="两条程序员成长路径的对照：一侧的人在故障、追踪、修复和维护中形成完整反馈环，另一侧的人隔着透明界面指挥自动机械，反馈环在交付与理解之间断开"><figcaption><p><strong>图 1 · 被 AI 缩短的，不只有交付路径。</strong> 旧回路迫使人从行动进入因果，再从后果回到判断；AI 回路如果只优化“尽快得到可运行结果”，交付可以完成，理解却可能停在环外。</p></figcaption></figure><h2 id="“完成”与“理解”第一次可以大规模分离"><span class="section-no">05</span><a href="#“完成”与“理解”第一次可以大规模分离" class="headerlink" title="“完成”与“理解”第一次可以大规模分离"></a>“完成”与“理解”第一次可以大规模分离</h2><p>AI 辅助编程的速度收益是真实的，也高度依赖任务。2022 年的一项受控实验中，使用早期 GitHub Copilot 的参与者完成一个标准化 JavaScript HTTP 服务器任务快了 55.8%；研究者同时明确说明，它没有测量大型项目中的协作和代码质量。<sup class="ref"><a href="#ref-11">[11]</a></sup> 2025 年 METR 让熟悉自己仓库的资深开源开发者处理真实任务，却观察到早期工具让完成时间增加了 19%；到 2026 年，更新实验出现可能提速的信号，但研究团队认为选择偏差使结果不足以可靠估计幅度。<sup class="ref"><a href="#ref-16">[16]</a></sup></p><p>这些数字不必被拼成一场“AI 到底更快还是更慢”的擂台赛，那是个问错了的问题。把它们放在一起，真正有用的提醒是：答案高度取决于任务的边界、你对这个代码库有多熟，以及手里工具是哪一代；换任何一个前提，结论都可能改变。而比“快慢”更要紧的一点是，完成速度和理解深度，本就是量在两根不同轴上的东西。一个人可以在一小时内交付一个能跑的功能，同时对它为什么能跑、会在什么情况下不跑一无所知。过去这两根轴多少还绑在一起：你写得快，通常也意味着你想得清；如今 AI 让“又快又不懂”第一次成为一种寻常、甚至高效的状态。</p><p>一项对 21 名编程初学者的观察发现，20 人借助生成式 AI 完成了任务。但对原本就不善于判断自己是否真正理解问题的学生，AI 并没有自动补上这种能力；有些人甚至因为任务做完了，误以为自己已经掌握了方法。<sup class="ref"><a href="#ref-12">[12]</a></sup></p><p>另一项实验让 15 名计算机专业研究生在已有代码库中修改功能。使用 Copilot 时，他们完成得更快，通过的测试更多，但对原有代码的整体理解没有相应提高。两项研究的样本都很小，不能据此下普遍结论。它们共同提示的风险更具体：完成任务，不等于理解系统。<sup class="ref"><a href="#ref-13">[13]</a></sup></p><p>这种分离过去也存在。复制 Stack Overflow 上的答案、套一个框架、调一次云服务，同样可能让人跳过底层。但那些跳跃都是短的、局部的——你至少还得自己把这块拼图嵌进整幅画里，接缝处的别扭会逼你多看两眼。AI 的不同在于跨度：理解需求、选择架构、落地实现、补齐测试、解释报错，整条认知链可以在一句提示里被一次性委派出去。抽象层不再是往上挪了一格，而是像一张幕布，可以临时把整条路径盖住。你按下回车，另一头递回来一份看似完成的东西，中间那段本该由你走一遍、也本该在你身上留下脚印的路，被悄悄跳过了。省下的是时间，隐形扣掉的，是你原本会在这段路上长出来的判断。</p><h2 id="三种能力会在无痛中变薄"><span class="section-no">06</span><a href="#三种能力会在无痛中变薄" class="headerlink" title="三种能力会在无痛中变薄"></a>三种能力会在无痛中变薄</h2><p><strong>第一种是因果地图。</strong> 亲手追踪故障的人会知道状态在哪里改变、异常如何传播、某个“多余判断”其实挡着三年前的一次线上事故。只看最终 diff 的人，会把这行判断当成噪声顺手删掉，代码更干净了，测试也照样通过——直到同一个故障在某个凌晨重新回来。他知道系统里有什么，却不知道每一样东西是被什么按住的；地图上画满了地名，却没有一条标着“此处水深”。</p><p><strong>第二种是校准能力。</strong> 工程嗅觉不是列出“长方法、重复、耦合”这些词，而是判断坏味道是否值得现在处理；两段相似代码是真共性还是偶然相似；一层抽象是在隔离变化，还是提前设计。判断依赖预测与结果之间的多次对照：你先押一个注，“我猜这里改下去会崩”，再看它到底崩不崩。一次次对账，直觉才逐渐有了刻度。而 AI 恰恰最擅长替人跳过“押注”这一步：它直接端出一个看起来就对的结果，你来不及先判断，也就收不到“我判断错了”这条最有价值的反馈。</p><p><strong>第三种是作者责任。</strong> 自己写下的错误会在心里刻一道印子：“这个坑是我挖的，下次手到这里会先停一下。”当模型生成、模型修复、模型解释，失败就很容易被记成“这次模型没写好”——一句话把自己摘干净。问题是解决了，可那道印子没有留在任何人身上；下一次，同样的坑会由同样放松的手，再挖一遍。</p><p>对 319 名知识工作者的调查，也捕捉到一种相似的张力：一个人对生成式 AI 越信任，他报告出来的批判性思考投入反而越少——仿佛把判断这件事，连同任务一起外包了出去。值得留意的是，研究并没有说思考就此凭空消失，它只是换了个地方发生：从“亲手把东西做出来”，转向了验证、整合和对结果的把关。这不是一项专门针对程序员的实验，也依赖参与者的自我报告，结论要留有余地；但它指出的方向很有用——AI 时代需要我们有意识地设计出新的思考动作，而不能想当然地以为，旧的那些动作会在工具更迭中自动幸存下来。不去主动保留的东西，往往就在无人察觉中悄悄流失了。<sup class="ref"><a href="#ref-14">[14]</a></sup></p><h2 id="当经典从实践智慧退化成提示词"><span class="section-no">07</span><a href="#当经典从实践智慧退化成提示词" class="headerlink" title="当经典从实践智慧退化成提示词"></a>当经典从实践智慧退化成提示词</h2><p>最可能出现的未来，并不是没人再谈经典。相反，SOLID、DDD、Clean Architecture、Strategy、Repository 会充满提示词和代码库。每个名字都很专业，每一层也都能得到合理解释，却没有人说得清它正在抵抗哪一种真实变化。</p><p>于是，“请遵循 SOLID 并使用合适的设计模式重构”成为一句咒语。AI 可能把一个二十行的函数，端端正正地摊成 Factory、Manager、Provider、Handler、Resolver 五层结构；测试全绿，目录比以前整齐得多，评审时也挑不出错——每一层都能自圆其说，每个类名都写在教科书里。可等到真要改一个字段，你会发现自己得在五个文件之间来回跳转，才拼得出原来那二十行做的事。系统没有变简单，只是把复杂度换了个更体面的包装。过去的过度设计至少是人亲手堆的，堆的人多半会在日后的维护里，一点一点把学费交回来；如今抽象可以批量生产，账单却被推迟——推给另一个人、另一个季度、另一次没人记得起因的重构。</p><p>这就是我更担心的文化空心化：术语像潮水一样铺开，孕育这些术语的经验却在退潮。一个程序员可以在架构评审上谈边界、谈内聚、谈依赖倒置，讲得漂亮又自信；可一旦线上冒出一个并发竞争、一处数据对不上、一段莫名其妙变慢的接口，他却在栈的深处停住了脚——因为那些词他是从别人嘴里、从模型口中接过来的，而不是自己在某个凌晨、对着一屏日志一寸寸挣出来的。词还在，词背后那个会疼、会记事的身体，却空了。</p><p class="part-label">第三部分 · 在 AI 时代重读经典</p><h2 id="大部头的价值，是训练对成本的敬畏"><span class="section-no">08</span><a href="#大部头的价值，是训练对成本的敬畏" class="headerlink" title="大部头的价值，是训练对成本的敬畏"></a>大部头的价值，是训练对成本的敬畏</h2><p>TAOCP 显然不是一本日常 Web 开发手册，也不该被当成入行的门槛——今天没有任何理由，要求每位工程师先用 MMIX 手写一遍排序，才有资格去调用一个标准库里的 sort。把大部头供成必须通读的圣经，恰恰误解了它。它真正持久的价值，是一种近乎生理的提醒：一个在你眼里“不就是排个序、查个表”的简单操作背后，其实压着一整套模型、证明、边界和代价，只是平时被库和硬件替你悄悄承担了。读过它的人，面对任何“看起来很简单”的东西时，心里会多一分本能的敬畏，而不是轻慢。</p><p>AI 会把“我能生成一个实现”变成极其廉价的能力，也因此更容易诱导人把“能生成”误认成“已理解”。屏幕上那段代码跑通了、测试也过了，人很自然地以为自己懂了；直到数据量翻了两个数量级，那个悄悄用了平方复杂度的实现，在某个周一早晨把整台机器拖垮。读算法、读计算模型，不是为了在脑子里和模型比谁记得多——那场比赛人从一开始就会输——而是为了给自己配一把尺：输入规模翻十倍、百倍时，会发生什么？正确性到底压在哪几条不变量上，抽掉一条会怎样？把随机性、精度、内存和并发换个前提，原来的结论还站得住吗？什么时候可以放心地信任一个成熟的库，什么时候又必须硬着头皮读进它的实现，甚至读到那篇原始论文？有了这把尺，AI 生成的东西才从“我猜它对”变成“我能说清它为什么对、又会在哪里错”。</p><p>同样，SICP 的意义也不只在 Scheme。它训练人穿过语法看见求值、组合、状态和解释器。一个能生成十种语言的 Agent，反而让这种穿透力更重要，因为表面差异越来越容易消失，语义差异仍会在运行时索要代价。</p><h2 id="《重构》应从“美化术”恢复成实验方法"><span class="section-no">09</span><a href="#《重构》应从“美化术”恢复成实验方法" class="headerlink" title="《重构》应从“美化术”恢复成实验方法"></a>《重构》应从“美化术”恢复成实验方法</h2><p>在所有经典里，《重构》可能比过去更重要。Fowler 对重构的定义很精确：通过一系列保持外部行为的小变化改善内部结构。小步不是审美偏好，而是风险控制；测试也不只是最后验收，它是每一步仍处于已知世界的反馈。<sup class="ref"><a href="#ref-6">[6]</a></sup></p><p>AI 很擅长“重新生成一个更干净的版本”。你让它整理一个模块，它常常一并把接口换了、把依赖升了级、顺手改了某个异常的语义，再补上一组与新实现严丝合缝的测试——绿灯亮起，看起来一切安好。可是等到几周后，一个上游调用方突然报错，你回头翻提交记录，会发现根本分不清：到底是哪一步改动动了外部行为？测试为什么没拦住？因为那一次提交里，重写和重构被搅在了一起，而它们本该泾渭分明。重构的全部安全感，来自“外部行为不变”这个铁律：正因为行为不动，你才敢放心大胆地重排内部结构。一旦把“换个更好的实现”混进来，这条安全绳就断了，团队也随之失去了追溯变化来源的能力——出了事，谁也说不清是哪一刀划的。</p><p>《修改代码的艺术》进一步提醒我们，旧系统最先缺的通常不是漂亮结构，而是可以感知行为、隔离依赖的接缝。<sup class="ref"><a href="#ref-7">[7]</a></sup> AI 时代可以把它变成一份明确契约：重构前列出可观察行为和未知区域；先建立特征测试；限制写入范围；每个小差异独立运行验证；只有证据允许，才进入下一步。Agent 可以执行大部分机械劳动，人仍需定义什么不能改变。</p><h2 id="把设计模式当作可证伪的假设"><span class="section-no">10</span><a href="#把设计模式当作可证伪的假设" class="headerlink" title="把设计模式当作可证伪的假设"></a>把设计模式当作可证伪的假设</h2><p>模式不应被禁用，也不应被默认启用。更好的用法，是把每个模式写成一项可以被现实推翻的设计假设：</p><div class="diagnostic"><h3>一个模式在进入代码前应回答的问题</h3><ul><li><strong>上下文：</strong> 当前哪一组职责或依赖正在造成真实摩擦？</li><li><strong>变化压力：</strong> 哪个维度已经变化过，或有可靠证据会独立变化？</li><li><strong>最小方案：</strong> 不引入完整模式时，最小可行隔离是什么？</li><li><strong>代价：</strong> 新的间接层会增加哪些导航、调试和测试成本？</li><li><strong>反证：</strong> 出现什么证据说明抽象选错了？</li><li><strong>删除条件：</strong> 如果变化没有发生，何时合并或移除这一层？</li></ul></div><p>这样一来，Strategy 就不再是四个整整齐齐的类名，而是一句需要被证据支持的断言——“这里确实有一根会独立变化的轴”；Adapter 也不再是随手套上的统一外壳，而是一道边界，专门拦住外部的语义，不让它渗进核心；Observer 更不是天生就比一次直接调用高级，它只是拿“调用链变得不那么一目了然”这个代价，去换时间和依赖上的松绑，值不值得，要看具体处境。在这套用法里，AI 反而如虎添翼：它可以在几秒内生成好几种候选结构，摆出对照方案，甚至主动造出让某个模式露馅的反例。人不必再亲手敲这些样板，人要做的是那件机器做不了的事——当那个把模式拉上被告席、逼它拿证据说话的法官。</p><h2 id="组织类经典提醒我们：代码之外还有共同理论"><span class="section-no">11</span><a href="#组织类经典提醒我们：代码之外还有共同理论" class="headerlink" title="组织类经典提醒我们：代码之外还有共同理论"></a>组织类经典提醒我们：代码之外还有共同理论</h2><p>《人月神话》《人件》和 Naur 的文章，讨论的范围各不相同，却共享一个常被忽略的前提：软件从来不是一份孤立的文本。它同时是一套概念、一张人与人之间的沟通网、一种工作环境，以及一个说得清“谁对什么负责”的结构。当 AI 把局部实现的速度拉高之后，这些因素非但不会随之缩小，反而会因为对比更悬殊而浮上水面，成为真正卡住整体的那道瓶颈——代码几分钟就生成好了，可到底该不该合、由谁拍板、出了事找谁，这些老问题一个都没被自动回答，只是被衬托得更刺眼。布鲁克斯当年那句“没有银弹”，说的正是这件事：真正的难，从来不在造出代码，而在想清楚要造什么、以及一群人如何就此达成共识。</p><p>DORA 2025 把 AI 描述成组织能力的一个放大器：它会放大既有的优势，也会同样忠实地放大既有的毛病；真正的收益不在工具本身，而藏在它接入的那套组织系统里。<sup class="ref"><a href="#ref-15">[15]</a></sup> 这与经典的判断并不冲突，反而像隔了几十年的一次互相印证。一个概念完整、边界清楚的仓库，会给 Agent 一批稳定可依的范例，让它照着既有的纹理往下写；一个测试快、反馈紧的团队，能安全地吸收比过去多得多的变更；一个责任清晰的组织，遇到风险时知道该由谁点头。反过来，边界含混、知识过期、谁也说不清系统为什么长成这样的团队，只会更快地量产出一堆彼此矛盾的“局部正确”——每一块单独看都对，拼在一起却谁也接不上谁。AI 不创造这些差距，它只是把差距拉得更快、更明显。</p><p>所以，AI 时代的经典阅读不能停在个人修养。它必须进入代码评审、任务设计、事故复盘、架构决策和团队培养，否则读完的知识仍然找不到附着点。</p><p class="part-label">第四部分 · 建立 AI 时代的新学徒制</p><h2 id="不要恢复稀缺，要恢复反馈"><span class="section-no">12</span><a href="#不要恢复稀缺，要恢复反馈" class="headerlink" title="不要恢复稀缺，要恢复反馈"></a>不要恢复稀缺，要恢复反馈</h2><p>要求年轻程序员放弃 AI、先老老实实手写几年代码，听上去像是在守护基本功，其实既不现实，也犯了一个更根本的错误：把手工劳动本身当成了学习。可过去那些痛苦，很多只是在纯粹地消耗时间——翻文档查一个记不住的语法，一行行抄写千篇一律的样板，把同一段逻辑机械地从旧框架搬到新框架，对着进度条等编译。这些苦从没让谁变得更聪明，它们消失，一点都不可惜，该庆幸才对。</p><p>但不是所有摩擦都该被抹平。真正值得留下的，是那些能改变“下一次判断”的经历：动手前先预测结果，再观察它是否兑现；亲自追踪一次关键的状态变化；向别人解释为什么选择这个抽象；几个月后再回来维护自己曾经接受的代码。它们的价值不在于制造痛苦，而在于把判断与后果连接起来。我们要去掉的是消耗，保留的是反馈。</p><p>认知学徒制的经典模型讲究一整套动作：先示范，再辅导，搭起脚手架，让学徒把思路说出来、回头反思、放手探索，然后随着他越来越稳，一根一根地把脚手架抽走。<sup class="ref"><a href="#ref-10">[10]</a></sup> 这套模型天然适合 AI，甚至 AI 可能是它有史以来最理想的脚手架：它可以当着你的面演示一位专家会怎样追一个故障，可以按你卡住的程度一级一级地给提示，可以随手造出一个反例逼你重新想，可以把三种方案摊在一起让你比较取舍。问题在于，最省事、也最危险的用法恰好把这套顺序整个倒了过来——在学徒连问题的模样都还没看清时，就把一份完整、漂亮、可直接运行的答案塞到他手里。脚手架本该最后才撤，这里却让人的参与第一个消失；扶手还在，学步的人却已经被抱到了终点，从来没有真正自己走过一步。</p><h2 id="把学习模式与生产模式分开"><span class="section-no">13</span><a href="#把学习模式与生产模式分开" class="headerlink" title="把学习模式与生产模式分开"></a>把学习模式与生产模式分开</h2><p>团队不需要在每个任务上牺牲交付速度。更实际的做法，是承认“完成工作”和“培养能力”是两种不同模式，并为后者保留明确预算。</p><div class="table-wrap"><table><caption>同一套 AI 工具，两种不同工作模式</caption><thead><tr><th>维度</th><th>生产模式</th><th>学习模式</th></tr></thead><tbody><tr><td>目标</td><td>在风险边界内高效交付</td><td>建立可迁移的因果模型与判断力</td></tr><tr><td>AI 角色</td><td>实现者、搜索者、验证执行者</td><td>教练、反方、提示提供者、模拟故障者</td></tr><tr><td>人的动作</td><td>定义约束、评审证据、承担发布</td><td>先预测、亲自追踪、解释取舍、比较结果</td></tr><tr><td>任务选择</td><td>低风险机械工作尽量自动化</td><td>选择代表性故障、旧代码和边界问题</td></tr><tr><td>完成标准</td><td>功能、测试、性能、可回滚</td><td>能解释、能修改、能识别错误迁移</td></tr></tbody></table></div><p>对新人，与其划一片笼统的“禁用 AI 区”（既难执行，也容易被当成惩罚），不如设一份更精确的 <strong>困难预算</strong>：明确规定哪些地方必须先由人尝试。关键练习中，AI 不应一开始就给出完整方案；调试时，先由人画出调用链，写下状态假设，再去验证；算法题则先写清复杂度和不变量，让 AI 按需逐级提供提示。等这些基础真正建立起来，再逐步放开生成能力。让自动化程度适应人的能力，而不是让人被工具为交付设计的默认设置牵着走。</p><p>对资深工程师，学习同样没有到站。他们要练的，是一批手工时代根本不存在的新手艺：怎样把一个大任务切成 Agent 接得住、也交得清的小块；怎样在一片看起来无比整洁的代码里，嗅出那种正在悄悄发生的架构漂移——它不报错，只是让系统一点点偏离原本的构想；怎样设计出信息量足够高的验证，让一次通过真的说明点什么，而不只是让灯变绿；以及怎样审阅比过去多出数倍、且不再由人逐字写下的代码产出，还不被它的体量冲垮判断。经典在这里提供的是一套判断的坐标系，新实践要做的，是把这套坐标重新焊到已经变样的生产方式上。老手也在重新当学徒，只是这一次，没有前人趟过完全一样的路。</p><h2 id="六个可以进入团队日常的反馈装置"><span class="section-no">14</span><a href="#六个可以进入团队日常的反馈装置" class="headerlink" title="六个可以进入团队日常的反馈装置"></a>六个可以进入团队日常的反馈装置</h2><div class="principles"><div class="principle"><strong>生成前先预测。</strong> 在提示词前写下受影响模块、风险最高的行为、预期测试和不变量。没有预测，就没有校准。</div><div class="principle"><strong>把重构写成契约。</strong> 明确外部行为、允许修改的范围和每一步验证，拒绝用一次大规模重写伪装小步重构。</div><div class="principle"><strong>保留人工故障解剖。</strong> 对生产事故、并发问题和数据错误，由人先画时间线、调用链和状态转换，再让 AI 补充反例。事故不是只需关闭的工单，也是稀缺教材。</div><div class="principle"><strong>给抽象留下案底。</strong> 记录引入模式的真实压力、未选方案、预期收益和删除条件。评审“为什么存在”，而不只评审命名是否漂亮。</div><div class="principle"><strong>让理解成为交付物。</strong> 重要变更除代码与测试外，还要能由负责人不用 AI 解释关键路径、失败模式和回滚方式。答不出时，任务尚未完成。</div><div class="principle"><strong>让所有权穿过时间。</strong> 让开发者维护自己与 AI 共同生成的系统，参与值班、复盘和下一次变更。只有后果能跨越季度，短期选择才会变成长期经验。</div></div><figure class="article-figure"><img src="/assets/articles/software-craft-after-ai/figure-02-ai-apprenticeship-loop.webp?v=3b8b3246dcce7a23" width="1672" height="941" loading="lazy" alt="程序员与 AI 位于一个循环工作台中，依次经过预测、受限生成、压力测试、人工追踪、解释和长期维护，运行证据不断返回下一轮判断"><figcaption><p><strong>图 2 · AI 时代的新反馈回路。</strong> AI 不必退出工作台，但它不能把人送到因果链之外。预测、受限行动、验证、解释和长期所有权共同把一次交付转化为下一次可复用的判断。</p></figcaption></figure><h2 id="未来的高级程序员，仍然要能闻到味道"><span class="section-no">15</span><a href="#未来的高级程序员，仍然要能闻到味道" class="headerlink" title="未来的高级程序员，仍然要能闻到味道"></a>未来的高级程序员，仍然要能闻到味道</h2><p>团队也得改一改自己丈量事情的尺子。如果考核只盯着关掉多少工单、写了多少行、合并得有多快，那么最聪明的做法，就是把理解的成本悄悄推给未来——反正账不会记在这个季度、这个人头上。人会诚实地朝着被测量的方向生长。所以除了交付指标，还值得盯住另外几件更难量化、却更接近真相的事：返工总是扎堆出现在哪几个模块？一个关键模块，全队到底有几个人能不看文档、不问 AI 就把它讲清楚？三个月前那批 AI 生成的改动，如今想动一动要付多大代价？一次事故过后，除了关掉告警，有没有沉淀出一条可复用的测试或规则？代码评审里，人究竟是在挑出真正的语义问题，还是只是把变量名和缩进抹得更顺眼？这些问题没有漂亮的仪表盘，却比任何速度曲线都更早地告诉你，一支团队是在积累理解，还是在借未来的债。</p><p>这并不意味着人人都得啃完整套 TAOCP，也不意味着资深工程师就该逞能手写每一个函数。一种健康的工程文化，从来不是全体成员背诵同一份书单、说同一套黑话。它更像一组心照不宣的共同习惯：对复杂度保持敬畏，不把“测试通过”轻易当成“我已经理解”；发现一个抽象错了，愿意亲手把它删掉，而不是再糊一层上去；动系统之前，先把“哪些行为绝对不能破坏”摆到台面上说清楚；故障来临时，第一反应是走进现场，而不是转身甩锅给模型；以及最朴素、也最难的一条——真心接受“上线之后的结果，我有份”。这些习惯不写在任何书里，却是一本本经典真正想教会人的东西。</p><p>经典著作仍会参与这套文化，但读法会改变。《计算机程序设计艺术》可以和性能剖析、模型生成的算法对照着读；《重构》可以变成 Agent 修改协议；《设计模式》可以变成设计假设的审查表；《人月神话》和《人件》则帮助团队抵抗“更多 Agent 自然等于更多产出”的简单想象。书不再等待某一天从头读完，而是在人遇到真实问题时，提供更长的历史和更准确的语言。</p><div class="pullquote"><p>我们不必让下一代重新踩完所有坑，但必须让他们看见坑是怎样形成的，并真正负责把路修好。</p></div><p>AI 正在让“写出来”变得越来越便宜，也因此让另一些能力更加重要：知道为什么这样写，知道什么不该写，知道出了问题由谁负责。手艺不会因为键盘敲得少了就自然消失，也不会因为经典仍在书架上，就自动传到下一个人手里。它能否延续，取决于我们是否把“理解”重新设计进工作流程，把“反馈”留在回路里，并把“责任”交给具体的人。</p><p>一个没有经历过所有旧式苦役的程序员，仍然可以形成可靠的工程判断。但有一个前提不能少：他不能始终被隔在系统之外，只做结果的旁观者。他需要亲自进入现场，追踪故障，解释原因，作出修复，并继续承担修复后的结果。把人留在因果回路里，或许就是 AI 时代传承这门手艺最重要的事。</p><section class="references" id="references"><h2 data-no-number="true">参考资料与延伸阅读</h2><ol><li id="ref-1">Donald E. Knuth, <a href="https://cs.stanford.edu/~knuth/taocp.html"><em>The Art of Computer Programming</em></a>, Stanford University.</li><li id="ref-2">Harold Abelson, Gerald Jay Sussman, Julie Sussman, <a href="https://mitpress.mit.edu/9780262543231/structure-and-interpretation-of-computer-programs/"><em>Structure and Interpretation of Computer Programs</em></a>, MIT Press.</li><li id="ref-3">Edsger W. Dijkstra, <a href="https://www.cs.utexas.edu/~EWD/transcriptions/EWD03xx/EWD340.html">“The Humble Programmer”</a>, ACM Turing Award Lecture, 1972.</li><li id="ref-4">Steve McConnell, <a href="https://www.microsoftpressstore.com/store/code-complete-9780735619678"><em>Code Complete, Second Edition</em></a>, Microsoft Press, 2004.</li><li id="ref-5">David Thomas and Andrew Hunt, <a href="https://pragprog.com/titles/tpp20/the-pragmatic-programmer-20th-anniversary-edition/"><em>The Pragmatic Programmer, 20th Anniversary Edition</em></a>, 2019.</li><li id="ref-6">Martin Fowler, <a href="https://www.martinfowler.com/books/refactoring.html"><em>Refactoring: Improving the Design of Existing Code</em></a>, second edition, 2018.</li><li id="ref-7">Michael Feathers, <a href="https://www.informit.com/store/working-effectively-with-legacy-code-9780132931779"><em>Working Effectively with Legacy Code</em></a>, 2004.</li><li id="ref-8">Erich Gamma, Richard Helm, Ralph Johnson, John Vlissides, <a href="https://www.pearson.com/en-us/subject-catalog/p/design-patterns-elements-of-reusable-object-oriented-software/P200000009480/9780321700698"><em>Design Patterns: Elements of Reusable Object-Oriented Software</em></a>, 1994.</li><li id="ref-9">Peter Naur, <a href="https://gwern.net/doc/cs/algorithm/1985-naur.pdf">“Programming as Theory Building”</a>, 1985.</li><li id="ref-10">Allan Collins, John Seely Brown, Susan E. Newman, <a href="https://eric.ed.gov/?id=ED284181">“Cognitive Apprenticeship: Teaching the Craft of Reading, Writing, and Mathematics”</a>, 1987.</li><li id="ref-11">Sida Peng, Eirini Kalliamvakou, Peter Cihon, Mert Demirer, <a href="https://arxiv.org/abs/2302.06590">“The Impact of AI on Developer Productivity: Evidence from GitHub Copilot”</a>, 2023.</li><li id="ref-12">James Prather et al., <a href="https://arxiv.org/abs/2405.17739">“The Widening Gap: The Benefits and Harms of Generative AI for Novice Programmers”</a>, ICER 2024.</li><li id="ref-13">Yunhan Qiao et al., <a href="https://arxiv.org/abs/2511.02922">“Code Comprehension with GitHub Copilot: Performance Gains, Comprehension Trade-offs, and Behavioral Predictors in Brownfield Programming”</a>, preprint, revised 2026.</li><li id="ref-14">Hao-Ping Lee et al., <a href="https://www.microsoft.com/en-us/research/publication/the-impact-of-generative-ai-on-critical-thinking-self-reported-reductions-in-cognitive-effort-and-confidence-effects-from-a-survey-of-knowledge-workers/">“The Impact of Generative AI on Critical Thinking”</a>, CHI 2025.</li><li id="ref-15">DORA, <a href="https://dora.dev/research/2025/dora-report/"><em>State of AI-assisted Software Development 2025</em></a>, Google Cloud, 2025.</li><li id="ref-16">METR, <a href="https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/">early-2025 experienced open-source developer study</a> and <a href="https://metr.org/blog/2026-02-24-uplift-update/">2026 experiment-design update</a>.</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/software-craft-after-ai/</id>
    <link href="https://ryu.xin/zh/posts/software-craft-after-ai/"/>
    <published>2026-08-07T16:00:00.000Z</published>
    <summary>从《计算机程序设计艺术》《重构》《设计模式》到《人月神话》，讨论 AI 如何改变程序员形成工程直觉的路径，以及我们应当怎样重建传承的反馈回路。</summary>
    <title>手艺会失传吗？AI 时代，程序员的工匠精神何以为继</title>
    <updated>2026-08-08T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Low-Code" scheme="https://ryu.xin/zh/tags/Low-Code/"/>
    <category term="Platform Engineering" scheme="https://ryu.xin/zh/tags/Platform-Engineering/"/>
    <content>
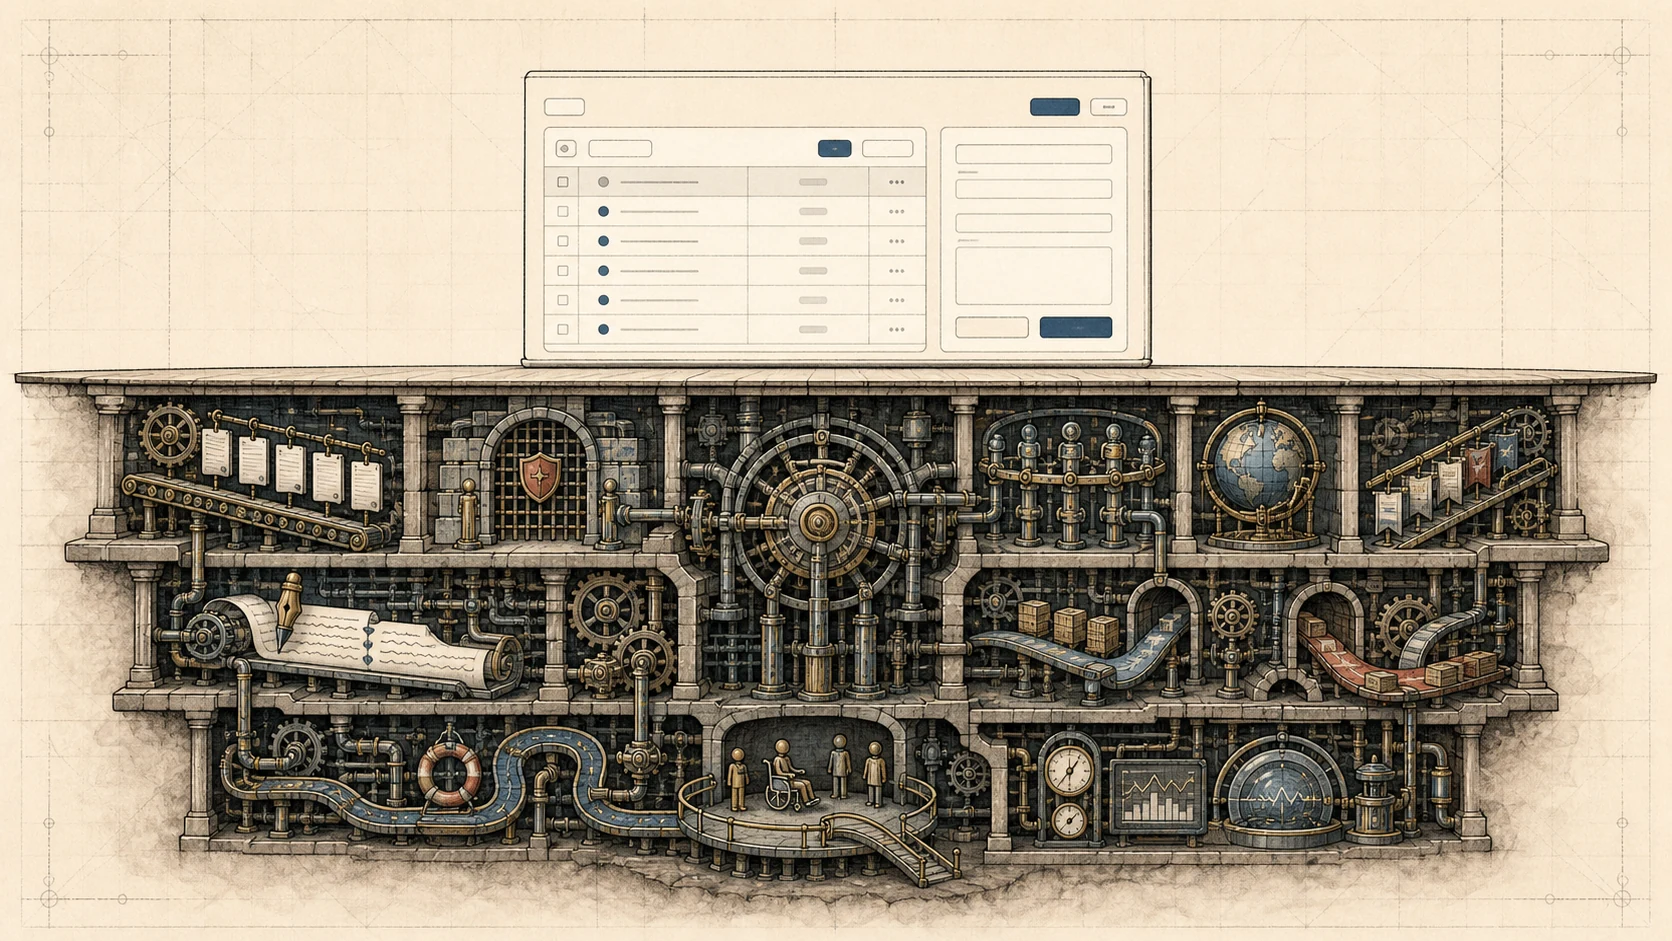
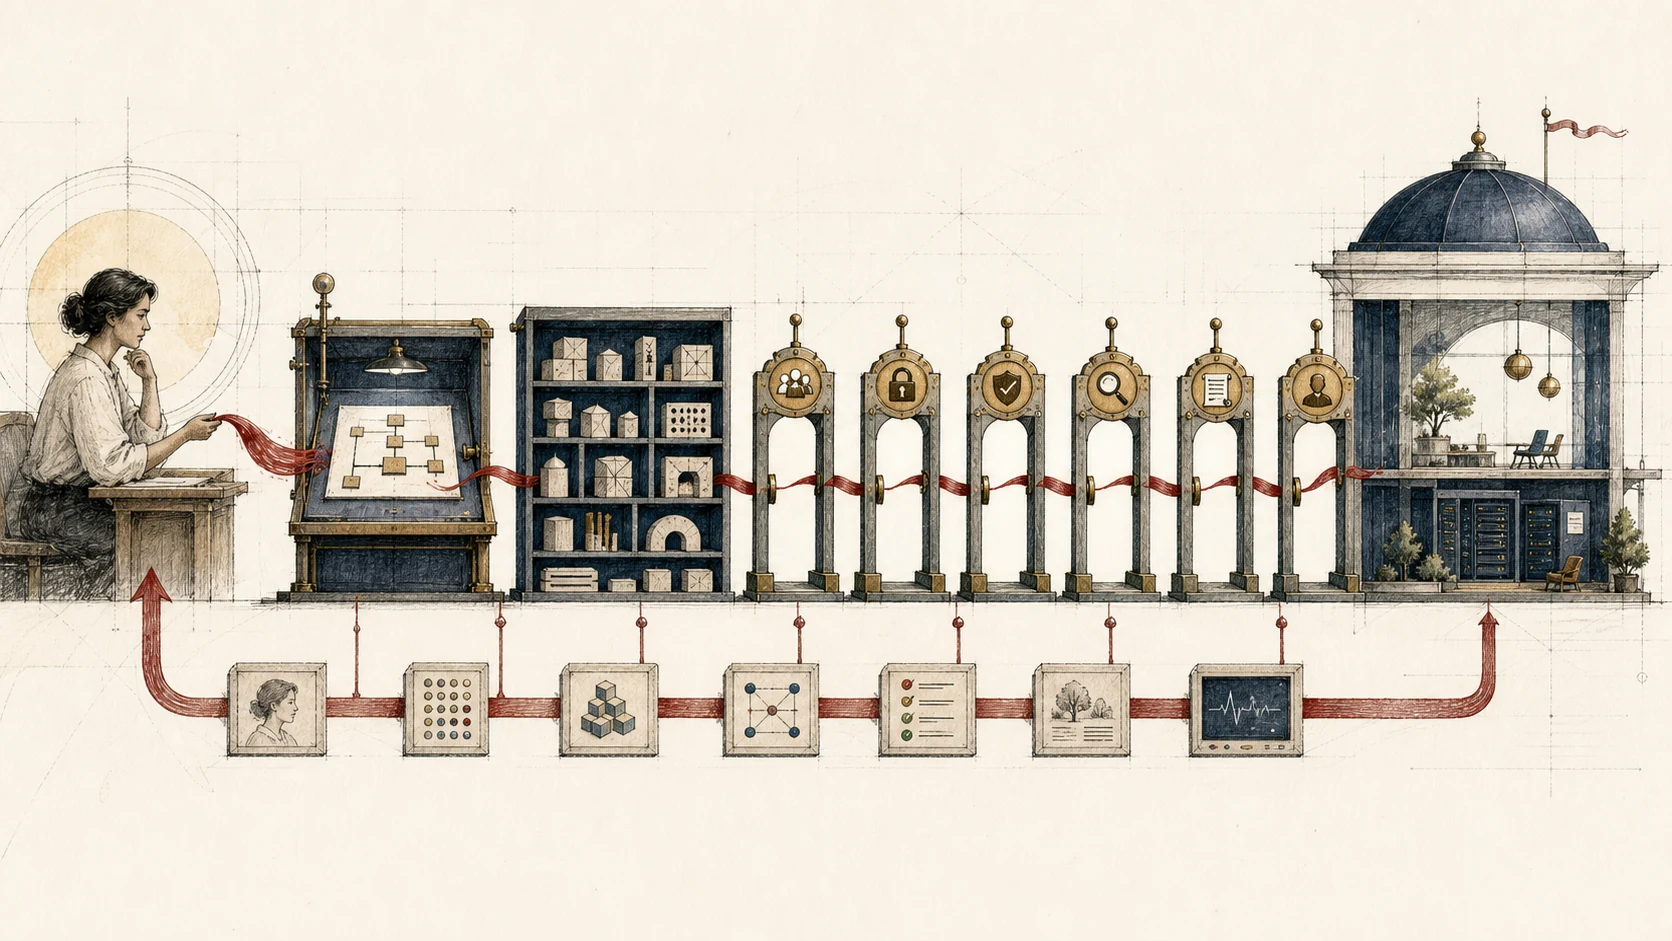
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>AI Coding 让一个人用几句话搭出完整原型，也让传统低代码最醒目的卖点开始失效。自然语言比拖拉拽更接近业务意图，生成代码也比学习一套平台专有表达式更自由。如果低代码仍然只是在画布上减少几次编码，它确实很可能被淘汰。</p><p>但“生成一个能运行的应用”与“把持续运转的业务交给一个系统”之间，隔着权限、数据一致性、异常恢复、性能、审计、升级和责任归属。成熟低代码平台真正稀缺的资产，不是画布，而是经过生产验证的组件、模型和运行时契约。AI 负责理解意图与生成候选方案，平台负责约束和复用，工程体系负责验证与交付。自然语言加 CLI，可能不是低代码的终点，却很像它进入下一阶段的入口。</p></header><p class="thesis">AI Coding 淘汰的首先是“用拖拉拽替代手写代码”这套旧价值主张。下一代低代码若能成为机器可理解、可验证、可回滚的企业应用底座，它得到的不是一次续命，而是一项更难也更重要的新职责：让生成速度不以失控为代价。</p><p class="part-label">第一部分 · 当代码突然变得很便宜</p><h2 id="为什么“AI-会杀死低代码”听起来如此合理"><span class="section-no">01</span><a href="#为什么“AI-会杀死低代码”听起来如此合理" class="headerlink" title="为什么“AI 会杀死低代码”听起来如此合理"></a>为什么“AI 会杀死低代码”听起来如此合理</h2><p class="lead dropcap">过去谈低代码，最常见的演示是把一个表格拖到画布上，绑定数据源，再配置一张表单。十几分钟后，一个管理应用已经可以打开、查询和提交。它之所以令人兴奋，是因为我们默认另一条路更慢：找开发人员，搭工程，选框架，写页面和接口，然后等待部署。今天，这个比较的前提变了。</p><p>现在，用户可以直接对 AI 说：做一个供应商准入应用，供应商提交资质，采购初审，法务审合同，财务核验账户；高风险供应商增加合规审批，所有操作必须留痕。几分钟之后，页面、接口、数据表和登录入口都可能已经出现。它未必可靠，却足够像一个产品。</p><p>Andrej Karpathy 在“Software Is Changing (Again)”的演讲中，把大模型看成一种新的计算形态：人开始用自然语言“编程”，软件的入口也随之改变。<sup class="ref"><a href="#ref-1">[1]</a></sup> 沿着这个判断继续推演，拖拉拽确实显得绕远。业务人员真正想表达的不是“在第二列放一个下拉框”，而是“高风险供应商需要多一道合规判断”。如果自然语言能够直接承载后者，低代码画布作为主要入口的优势就会迅速缩水。</p><p>这不是低代码第一次被更高层抽象挑战。代码生成器、第四代语言、模型驱动开发和云服务都曾试图减少手工实现。AI 的不同之处在于，它不要求用户先学会一种精确语法，就能处理模糊意图、解释反馈并连续修改。这让过去属于低代码的“低门槛”不再独占。</p><p>所以我基本同意悲观判断的前半句：<strong>如果一个低代码平台最重要的能力仍然是少写代码，它的护城河正在消失。</strong> 固定模板未必比动态生成灵活，专有表达式未必比自然语言容易，受限组件也未必比普通代码自由。AI 没有必要先打败整个平台，它只要让平台原来的购买理由不再成立。</p><h2 id="从零到一个能跑的版本，真的便宜了"><span class="section-no">02</span><a href="#从零到一个能跑的版本，真的便宜了" class="headerlink" title="从零到一个能跑的版本，真的便宜了"></a>从零到一个能跑的版本，真的便宜了</h2><p>AI Coding 最明确的改变，是把软件的起点从“提交需求”改成“先做一个出来看看”。产品经理可以自行验证交互，运营可以生成一次性工具，创业者可以在一天内比较多个方向。大量过去进不了研发排期的想法，第一次获得了可运行的表达。</p><p>Addy Osmani 把这种体验概括为“70% 问题”：AI 可以很快把人带到一份令人惊讶的初版，剩下那段通往可维护、可用于生产的距离，却需要架构判断、边界处理和持续验证。<sup class="ref"><a href="#ref-2">[2]</a></sup> 这里的 70% 不是测量所有项目的统计常数，更像一个有用的工程隐喻。前半程之所以显得快，是因为最容易展示；后半程之所以显得慢，是因为大量工作只会在失败、增长和变化中暴露。</p><p>一个投诉管理原型可能已经有登录、列表、详情和状态流转。真正上线前，问题会变成另一组：</p><ul><li>同一客户重复提交时，系统如何识别并合并？</li><li>客服只能看本产品线，质量负责人可以跨产品线查看，这个限制是在每个页面里分别判断，还是由统一的数据权限执行？</li><li>“24 小时未响应”按自然时间还是工作日历计算，节假日和暂停状态如何处理？</li><li>通知发送成功、状态更新失败时，下一次重试会不会造成重复升级？</li><li>一条投诉涉及客户隐私时，导出、搜索、日志和备份分别遵守什么规则？</li><li>半年后修改流程，正在处理的旧实例继续走旧版本还是迁移到新版本？</li></ul><p>这些问题很少出现在第一张演示截图里，却决定企业敢不敢把客户关系和服务责任交给系统。</p><div class="table-wrap"><table><caption>从原型到企业应用，证据发生了什么变化</caption><thead><tr><th>阶段</th><th>“完成”的常见证据</th><th>尚未回答的问题</th></tr></thead><tbody><tr><td>原型</td><td>页面可打开，主流程可演示</td><td>需求是否值得做，交互是否可理解</td></tr><tr><td>可用应用</td><td>真实用户能完成任务，数据能够保存</td><td>边界条件、权限和异常是否正确</td></tr><tr><td>生产系统</td><td>测试、监控、审计与发布记录齐全</td><td>在真实负载和故障下是否仍可托付</td></tr><tr><td>长期资产</td><td>可升级、可迁移、可恢复，知识可交接</td><td>下一次变化能否继续保持可控</td></tr></tbody></table></div><h2 id="最危险的不是原型粗糙，而是原型太像产品"><span class="section-no">03</span><a href="#最危险的不是原型粗糙，而是原型太像产品" class="headerlink" title="最危险的不是原型粗糙，而是原型太像产品"></a>最危险的不是原型粗糙，而是原型太像产品</h2><p>粗糙原型反而容易让人保持警惕。真正危险的是一个界面完整、动画顺滑、还能部署到云端的原型。视觉完成度会替工程完成度背书，人很自然地认为“再修几个问题就能上线”。</p><p>然而，企业级能力通常不是在原型末尾依次安装的插件。数据模型是否能表达历史状态，决定了审计和迁移的上限；权限是在服务端统一执行还是散落在前端，决定了越权风险；事务边界如何划分，决定了中途失败后能否恢复；依赖是否可替换，决定了系统扩展时要不要推倒重来。这些选择在第一版里已经发生，只是当时没有人要求它们接受检验。</p><p>AI 让代码生产得越快，这种误判越容易扩大。一个 Agent 生成页面，另一个补接口，第三个修改数据库，第四个处理部署配置。每个局部都可能看起来合理，整个系统却没有人真正理解。代码数量增长十倍，并不会让审查、测试和架构理解自动增长十倍。瓶颈只是从“谁来写”移动到了“谁能证明”。</p><div class="pullquote"><p>当每个人都能生成软件，稀缺的就不再是第一版，而是让第十版仍然值得信任的能力。</p></div><p class="part-label">第二部分 · 企业购买的是可控变化</p><h2 id="企业级不是规模形容词，而是责任声明"><span class="section-no">04</span><a href="#企业级不是规模形容词，而是责任声明" class="headerlink" title="企业级不是规模形容词，而是责任声明"></a>企业级不是规模形容词，而是责任声明</h2><p>“企业级”经常被误解成更多功能、更复杂的技术栈，仿佛只要上了微服务、容器和 Kubernetes，系统就自然完成了升级。其实，一个只有三张页面的审批工具，只要承载真实资金、客户数据或合规责任，就可能需要企业级保障。反过来，一个有几十张页面的演示项目，只要没人依赖它持续工作，依然只是原型。</p><p>我更愿意把企业级理解成一句责任声明：<strong>组织愿意把一段持续运转的业务交给这个系统，并且知道出问题时由谁发现、谁解释、谁恢复。</strong></p><p>这份责任至少包含六种确定性：</p><ul><li><strong>结果的确定性。</strong> 相同业务条件得到一致结果，重复请求和并发操作不会悄悄制造不同事实。</li><li><strong>边界的确定性。</strong> 身份、角色、租户和数据权限在所有入口保持一致，不能靠某个页面记得隐藏按钮。</li><li><strong>运行的确定性。</strong> 依赖超时、网络抖动和流量波动出现时，系统能够隔离、降级或恢复。</li><li><strong>变化的确定性。</strong> 模型、流程和接口升级时，影响范围可以分析，历史数据可以迁移，失败可以回退。</li><li><strong>证据的确定性。</strong> 谁在何时依据什么信息做了什么，能够被审计、复盘和解释。</li><li><strong>所有权的确定性。</strong> 业务语义、技术风险和生产发布分别有人负责，AI 不是责任主体。</li></ul><p>这些要求与功能多少没有直接关系，却决定了软件能否从一次性产物变成组织资产。</p><h2 id="AI-提高的是产量，工程系统决定它会放大什么"><span class="section-no">05</span><a href="#AI-提高的是产量，工程系统决定它会放大什么" class="headerlink" title="AI 提高的是产量，工程系统决定它会放大什么"></a>AI 提高的是产量，工程系统决定它会放大什么</h2><p>2025 年 DORA 关于 AI 辅助软件开发的研究给了一个比“AI 有用”或“AI 有害”更准确的结论：AI 更像放大器。它会放大组织已有的优势，也会放大薄弱环节；研究同时观察到更高的交付吞吐和仍然承压的交付稳定性。<sup class="ref"><a href="#ref-3">[3]</a></sup> 这并不能直接证明某个团队使用 AI 后一定更快或更不稳定，但它提醒我们，不应把局部编码速度等同于端到端交付能力。</p><p>如果团队已经有清晰边界、快速测试、短反馈环和可靠发布，AI 可以把成熟做法复制得更快。如果需求经常口头变化、权限规则散落、测试长期欠账、发布依赖人工记忆，AI 同样会更快地产生不一致。生成能力本身没有方向，工程系统决定它放大秩序还是放大混乱。</p><p>这也是低代码可能重新获得价值的地方。它不必与 AI 比赛谁更会生成代码，而可以提供一组已经存在的工程事实：统一身份如何接入，流程状态怎样持久化，哪些组件可以访问敏感字段，任务怎样计时，数据如何审计，应用如何发布和回滚。AI 不需要每次重新发明这些答案。</p><h2 id="低代码最值钱的东西，藏在画布下面"><span class="section-no">06</span><a href="#低代码最值钱的东西，藏在画布下面" class="headerlink" title="低代码最值钱的东西，藏在画布下面"></a>低代码最值钱的东西，藏在画布下面</h2><p>看一个成熟的表格组件，很容易只看到列、筛选、分页和按钮。可它真正积累的内容通常在界面之下：大数据量下如何分页，字段权限如何作用于查询和导出，并发更新如何发现冲突，国际化怎样影响排序与时区，移动端和无障碍如何保持可用，错误发生后如何重试，关键操作如何留下审计记录。</p><p>AI 当然可以现场生成一个表格。现场生成一个外观相似的表格，却不等于现场获得了过去几年中所有故障、修复和取舍。成熟组件的价值不是少写了多少行代码，而是把一段故障史压缩成了可重复使用的默认行为。</p><figure class="article-figure"><img src="/assets/articles/ai-coding-low-code-trusted-build/figure-01-compressed-experience.webp?v=3ea49ca1d30f82a3" width="1672" height="941" loading="lazy" alt="一张看似简单的业务表格与表单，下方是由权限、并发、国际化、审计、恢复和监控机制组成的巨大基础结构"><figcaption><p><strong>图 1 · 组件是被压缩的工程经验。</strong> 水面之上只是一个可见功能，水面之下才是它在真实项目中逐渐学会处理的边界。AI 可以快速重建外形，可信平台提供的是那些不会出现在演示路径里的默认行为。</p></figcaption></figure><p>同样的积累也存在于工作流、权限、文件、消息、任务和集成组件中。一个审批引擎不只是把节点连起来，它还要处理撤回、转交、加签、重复提交、旧版本实例、处理人离职、时区和工作日历。一个文件服务不只是上传按钮，它还涉及病毒扫描、访问控制、生命周期和留存策略。</p><p>这并不意味着“用了成熟组件，应用就一定稳定”。组件可能被错误组合，平台本身也可能有缺陷。真正合理的判断是：<strong>复用经过验证的能力，可以减少每个项目从头犯错的范围，但不能取消架构和验收。</strong></p><h2 id="从开发工具变成运行时契约"><span class="section-no">07</span><a href="#从开发工具变成运行时契约" class="headerlink" title="从开发工具变成运行时契约"></a>从开发工具变成运行时契约</h2><p>如果画布不再是核心，低代码还剩下什么？我认为答案是一套既能被人理解、也能被机器处理的应用模型：</p><ul><li>一个业务对象有哪些字段、唯一性约束、状态和数据生命周期；</li><li>一个流程有哪些节点、转换、条件、校验和失败补偿；</li><li>谁可以执行某个动作，又能看到哪些字段和哪些数据行；</li><li>一个页面组合了哪些语义组件，组件依赖哪些业务能力；</li><li>应用需要怎样的容量、可用性、审计、恢复和部署区域；</li><li>变更会影响哪些运行实例，发布前必须通过哪些检查。</li></ul><p>当这些内容只存在于画布坐标和私有 JSON 里，它仍然是封闭工具的配置。当它们拥有稳定语义、版本、接口、差异比较和验证规则时，就成为运行时契约。AI 可以生成契约，人可以审查契约，平台可以执行契约，流水线可以验证契约。</p><p>Evan Bottcher 在 Martin Fowler 网站讨论数字平台时，把平台定义为一组可自助使用的 API、工具、服务、知识和支持。好的平台不是强制每个团队走同一条路，而是提供一条安全、合规、成本更低的“铺装道路”。<sup class="ref"><a href="#ref-4">[4]</a></sup> 下一代低代码也应该如此。它不能只是更大的共享服务部门，也不能用“治理”替代使用体验。它必须让采用可信默认值，比绕过平台重新实现更容易。</p><p class="part-label">第三部分 · 自然语言加 CLI，不是魔法输入框</p><h2 id="自然语言应该表达业务意图"><span class="section-no">08</span><a href="#自然语言应该表达业务意图" class="headerlink" title="自然语言应该表达业务意图"></a>自然语言应该表达业务意图</h2><p>拖拉拽适合调整局部布局，不擅长承载完整意图。用户说“做一个供应商准入应用”时，真正需要被理解的是业务对象、角色、流程、例外和责任，而不是控件坐标。</p><p>一个有用的 AI 不应立即生成页面。它首先应该把描述整理成一份可讨论的计划：</p><div class="diagnostic"><h3>供应商准入需求的结构化解释</h3><ul><li><strong>业务对象：</strong> 供应商、资质文件、合同、银行账户、风险审查、审批记录。</li><li><strong>角色：</strong> 供应商联系人、采购、法务、财务、合规负责人、平台管理员。</li><li><strong>主流程：</strong> 提交、采购初审、法务审查、财务核验、风险分级、通过或退回。</li><li><strong>条件分支：</strong> 高风险供应商增加合规审批；资质过期触发重新提交。</li><li><strong>非功能约束：</strong> 字段级权限、完整审计、文件留存、工作日历、超时升级、发布回滚。</li><li><strong>待确认问题：</strong> 风险分级由谁维护？旧合同更新时是否重新走全流程？供应商能否看到内部驳回意见？</li></ul></div><p>这一步看似没有“写代码”，却避免了最昂贵的一类错误：AI 用顺畅的交互掩盖了自己替用户做出的假设。自然语言的价值不是让模糊永远保持模糊，而是更快地把模糊变成可以确认的结构。</p><h2 id="CLI-是自然语言与工程交付之间的桥"><span class="section-no">09</span><a href="#CLI-是自然语言与工程交付之间的桥" class="headerlink" title="CLI 是自然语言与工程交付之间的桥"></a>CLI 是自然语言与工程交付之间的桥</h2><p>为什么还需要 CLI？因为一句话可以表达目标，却不适合直接成为生产变更。企业交付需要知道目标环境、当前版本、具体修改、验证结果和回退材料。CLI 把这些动作变成可记录、可复现、可组合的命令，也让 AI 不必操纵像素坐标或猜测内部 JSON。</p><p>Spark CLI 的当前设计提供了一个具体例子。它要求先选择认证配置、App、可编辑版本和工作流，再使用“增加节点”“连接流程”“增加校验”这类业务语义命令。高影响写操作需要明确的 <code>--yes</code>，修改后还可以执行配置检查并导出包。页面继续承担可视化检查和人工治理，CLI 则负责自动化、批处理、结构化输出与 AI 调用。<sup class="ref"><a href="#ref-5">[5]</a></sup></p><p>下面这段是基于真实命令语义整理的说明性案例。它假设应用、工作流、表单和可复用 Step 已经存在；名称用于展示方法，并不声称对应某个生产环境。</p><figure class="highlight bash"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="comment"># 先证明目标上下文，而不是凭聊天记录猜测</span></span><br><span class="line">spark auth use spark-dev</span><br><span class="line">spark-designer task app use customer-service</span><br><span class="line">spark-designer task current</span><br><span class="line">spark-designer task workflow use <span class="string">"Complaint Handling"</span></span><br><span class="line">spark-designer task workflow current</span><br><span class="line">spark-designer task workflow describe --json</span><br><span class="line"></span><br><span class="line"><span class="comment"># 读取服务端实际注册的规则，再形成变更计划</span></span><br><span class="line">spark-designer task workflow rule-types</span><br><span class="line"></span><br><span class="line"><span class="comment"># 人确认计划后，增加重大投诉的质量复核环节</span></span><br><span class="line">spark-designer task workflow add-node \</span><br><span class="line">  --<span class="built_in">type</span> status \</span><br><span class="line">  --name <span class="string">"Quality Review"</span> \</span><br><span class="line">  --step <span class="string">"Quality Review"</span> \</span><br><span class="line">  --<span class="built_in">yes</span></span><br><span class="line"></span><br><span class="line">spark-designer task workflow connect \</span><br><span class="line">  <span class="string">"Product Review"</span> \</span><br><span class="line">  <span class="string">"Quality Review"</span> \</span><br><span class="line">  --name <span class="string">"Escalate Major Complaint"</span> \</span><br><span class="line">  --form qualityReview \</span><br><span class="line">  --<span class="built_in">yes</span></span><br><span class="line"></span><br><span class="line"><span class="comment"># 重新读取结果，执行检查，并留下可恢复材料</span></span><br><span class="line">spark-designer task workflow describe --lang zh-CN</span><br><span class="line">spark-designer task check workflow-config --<span class="built_in">yes</span></span><br><span class="line">spark-designer task package <span class="built_in">export</span> \</span><br><span class="line">  --output complaint-management-backup.json</span><br></pre></td></tr></tbody></table></div></figure><p>这比原稿中虚构一条 <code>platform create</code> 命令更慢一点，也更真实一点。AI 仍然可以把自然语言转成这些操作，但它必须展示目标上下文、实际能力目录和预期差异。用户确认后才写入，写入后重新读取，再交给设计器和运行环境验证。CLI 的意义不只是少敲几次键，而是让一次生成拥有可以追问的证据链。</p><div class="callout"><p><strong>自然语言不是发布权限。</strong> 它负责表达意图；结构化计划负责暴露假设；CLI 负责执行可追踪的动作；平台检查、测试环境和责任人共同决定结果能否进入生产。</p></div><h2 id="从一句需求到可信运行，需要一个闭环"><span class="section-no">10</span><a href="#从一句需求到可信运行，需要一个闭环" class="headerlink" title="从一句需求到可信运行，需要一个闭环"></a>从一句需求到可信运行，需要一个闭环</h2><p>把 AI 与低代码组合起来，一次完整交付大致会经过七个环节：</p><ol><li><strong>表达意图。</strong> 业务人员描述目标、角色、例外和不能失守的约束。</li><li><strong>形成计划。</strong> AI 拆解对象、流程、权限、组件和待确认问题，不立即写生产数据。</li><li><strong>证明上下文。</strong> 工具读取实际 App、版本、环境和组件目录，避免修改错误目标。</li><li><strong>组合能力。</strong> 平台优先匹配统一身份、工作流、SLA、审计和通知等成熟组件。</li><li><strong>生成差异。</strong> AI 只生成平台尚未覆盖的模型、配置或扩展代码，并明确影响范围。</li><li><strong>验证结果。</strong> 自动检查主流程、权限矩阵、重复提交、超时升级、异常恢复和性能基线；人验证业务语义与高风险决策。</li><li><strong>运行与反馈。</strong> 平台提供监控、审计、版本、灰度和回滚，生产证据再进入下一次变更。</li></ol><figure class="article-figure"><img src="/assets/articles/ai-coding-low-code-trusted-build/figure-02-trusted-build-loop.webp?v=9e9074ab42429636" width="1672" height="941" loading="lazy" alt="业务人员的意图经过 AI 规划、可信组件目录、多道验证与人工确认，成为运行中的企业应用，并由运行证据形成反馈回路"><figcaption><p><strong>图 2 · 从意图到可信运行的控制链。</strong> 速度来自意图理解和能力复用，信任来自上下文确认、约束、验证、人工责任与运行反馈。任何一环被省略，所谓“一句话生成企业应用”都只是把成本推迟到了上线以后。</p></figcaption></figure><div class="table-wrap"><table><caption>三种应用构建方式的差异</caption><thead><tr><th>构建方式</th><th>主要入口</th><th>默认产物</th><th>最强优势</th><th>主要风险</th></tr></thead><tbody><tr><td>自由 AI Coding</td><td>自然语言</td><td>任意代码与依赖</td><td>探索快，自由度高</td><td>架构漂移、验证债务、长期所有权不清</td></tr><tr><td>传统低代码</td><td>可视化画布与配置</td><td>平台私有模型</td><td>常见功能复用，交付一致</td><td>入口笨重、表达受限、锁定较深</td></tr><tr><td>AI + 可信平台</td><td>自然语言、CLI、API、画布</td><td>受约束且可验证的应用模型</td><td>意图速度与工程积累结合</td><td>平台能力上限、错误组合、虚假确定感</td></tr></tbody></table></div><p>这里的第三种形态并不是前两种的机械叠加。真正的变化是生成空间不同。自由 AI Coding 可以选择任意框架、依赖和实现；可信平台要求优先使用批准的组件、统一身份和标准连接器，关键操作必须审计，发布必须经过指定门禁。限制减少了一部分自由，也减少了企业每次重新证明同一类基础问题的成本。</p><p class="part-label">第四部分 · 低代码也必须完成一次自我革命</p><h2 id="“又快又好”不是一句自动成立的口号"><span class="section-no">11</span><a href="#“又快又好”不是一句自动成立的口号" class="headerlink" title="“又快又好”不是一句自动成立的口号"></a>“又快又好”不是一句自动成立的口号</h2><p>AI 与低代码结合，确实可能同时提高速度与质量，但原因需要说清楚。</p><p>快，主要来自 AI 对意图的理解，以及对样板配置、文档和差异实现的自动化。质量，主要来自成熟组件和统一运行时，不是因为 AI 突然不犯错。稳定性来自故障边界、监控和恢复机制。可靠性来自约束、测试、审计和发布责任。可维护性来自模型、代码、版本与决策记录共同存在。</p><p>这几件事缺一不可。只有自然语言，没有稳定平台，容易得到快速增长的代码堆；只有封闭平台，没有更好的意图入口，用户仍然困在漫长配置中；两者都有，但没有验证与责任，错误只会以更高速度进入生产。</p><p>所以更准确的关系不是一句整齐的“AI 提供速度，低代码提供稳定”。AI 也能帮助测试和治理，低代码也可能拖慢交付。真正有效的是分工：让概率性的生成负责提出候选，让确定性的系统负责执行约束，让人对不可外包的判断负责。</p><h2 id="下一代平台至少要改变七件事"><span class="section-no">12</span><a href="#下一代平台至少要改变七件事" class="headerlink" title="下一代平台至少要改变七件事"></a>下一代平台至少要改变七件事</h2><p>低代码不会因为拥有多年组件就自动获胜。很多积累如果仍被锁在浏览器点击、私有格式和人工操作里，AI 无法可靠调用，企业也很难验证。</p><div class="principles"><div class="principle"><strong>模型必须可读。</strong> 页面、数据、流程、权限和依赖需要稳定语义，而不是只有画布坐标。</div><div class="principle"><strong>变更必须可比较。</strong> 每次生成都能展示差异、影响范围、破坏性变化和未验证风险。</div><div class="principle"><strong>操作必须可自动化。</strong> CLI 与 API 应覆盖读取、修改、检查、导出和发布，并提供结构化输出。</div><div class="principle"><strong>配置必须可版本化。</strong> 应用模型进入 Git 或等价的版本体系，能够评审、回退和重放。</div><div class="principle"><strong>非功能需求必须是一等公民。</strong> 性能目标、可用性、数据留存、部署区域、恢复目标和成本预算不能留到上线前再补。</div><div class="principle"><strong>扩展与退出必须存在。</strong> 特殊逻辑允许在受控边界内用代码实现，数据、模型和接口也要有迁移策略。</div><div class="principle"><strong>生成必须可解释。</strong> 平台要说明为何选择组件、改了什么、证据在哪里、失败后如何恢复。</div></div><p>Forrester 的 Diego Lo Giudice 与 John Bratincevic 把类似方向称为 AppGen：AI 原生、理解业务的全栈平台，用中间模型连接业务意图与可执行系统，并把领域知识和治理放进平台。<sup class="ref"><a href="#ref-6">[6]</a></sup> 这个名称是否会成为行业共识并不重要，他们关于时间表和“重塑整个开发生命周期”的判断也仍是预测。更值得注意的是，低代码与生成式 AI 的边界正在融合，竞争单位从某个编辑器变成了整条应用交付链。</p><p>安全同样不能靠平台口号。NIST 的 Secure Software Development Framework 要求组织把安全需求、来源、设计决策、发布完整性和漏洞响应纳入整个生命周期。<sup class="ref"><a href="#ref-7">[7]</a></sup> 下一代低代码若想承载企业核心，就要把这类要求变成默认可执行的检查，而不是在采购文档里勾选一次。</p><h2 id="平台越强，越要给边界和退出留位置"><span class="section-no">13</span><a href="#平台越强，越要给边界和退出留位置" class="headerlink" title="平台越强，越要给边界和退出留位置"></a>平台越强，越要给边界和退出留位置</h2><p>并不是所有软件都适合建立在统一低代码平台上。高度创新的交互、极端性能或实时要求、底层基础设施、复杂算法产品，以及平台尚未验证过的监管场景，可能需要更直接的工程控制。即使是常见企业应用，独特业务规则也不应被强行塞进不合适的组件。</p><p>平台锁定也会因为 AI 而加深。过去，开发者至少知道自己点过哪些配置；未来，AI 可能持续调用平台专有语义，应用数量快速增加，团队反而更难看见依赖边界。一个负责任的平台应该提供数据导出、开放接口、版本化模型、可观察的运行行为和明确的扩展边界。最好的“铺装道路”有清楚路标，也允许使用者在承担成本后离开，而不是把护栏修成围墙。</p><p>还要警惕错误的确定感。稳定组件被错误组合，仍会得到不稳定系统。自动生成的权限矩阵可能完整却误解了组织规则；所有测试都通过，也可能只是测试了 AI 自己写下的假设。平台能降低风险，不能替业务负责人定义“正确”，也不能替技术负责人接受生产后果。</p><div class="pullquote"><p>可信不是系统替人承担了责任，而是系统让责任所需的事实、边界和证据不再依赖记忆。</p></div><h2 id="低代码的终局，不是-No-Code，而是-Trusted-Build"><span class="section-no">14</span><a href="#低代码的终局，不是-No-Code，而是-Trusted-Build" class="headerlink" title="低代码的终局，不是 No Code，而是 Trusted Build"></a>低代码的终局，不是 No Code，而是 Trusted Build</h2><p>AI Coding 确实会淘汰一批低代码产品。那些主要依靠模板、拖拉拽和“不会编程也能做应用”生存的平台，很难继续证明学习成本和锁定成本值得付出。自然语言更直接，普通代码更开放，AI 还会继续提高两者之间的转换效率。</p><p>但代码变便宜，不等于企业软件的全部成本变便宜。相反，候选实现越多，经过验证的组件、清晰的运行时契约、自动化的治理和可恢复的交付过程越稀缺。企业不需要更多无法说明来源的代码，它需要更低成本的可信变化。</p><p>未来有竞争力的低代码，用户未必先看到画布。他可能先说出业务目标，由 AI 形成结构化计划；平台从可信能力目录中组合页面、数据、流程和权限；CLI 与 API 把每次修改变成可追踪动作；测试、策略和人工审批共同决定是否发布；运行证据再反过来帮助下一次生成。</p><p>我把这种形态称为 <strong>Trusted Build</strong>，不是为了再造一个市场名词，而是为了改变验收问题。我们不再只问“它能不能生成”，而要继续问：</p><ul><li>它是否准确表达了业务意图和未知假设？</li><li>它是否复用了经过验证的能力，而不是重新发明基础设施？</li><li>它能否证明权限、数据、性能和失败路径符合要求？</li><li>它的变更是否可解释、可回退、可交接？</li><li>当平台不再合适时，组织是否仍然拥有自己的数据和业务知识？</li></ul><p>如果这些问题有答案，AI Coding 与低代码就不是一场简单的替代战争。AI 改变应用的入口，低代码提供经过时间筛选的能力，工程体系把两者约束成可以负责的交付过程。</p><p>真正值得争夺的，不是“谁让不会编程的人也能做软件”。那道门已经被 AI 推开。下一个更难的问题是：<strong>当每个人都能生成软件时，谁能让这些软件值得企业长期托付？</strong></p><section class="references" id="references"><h2 data-no-number="true">参考资料与延伸阅读</h2><ol><li id="ref-1"><a href="https://www.youtube.com/live/LCEmiRjPEtQ">Andrej Karpathy, “Software Is Changing (Again),” AI Startup School</a>, Y Combinator, 2025.</li><li id="ref-2"><a href="https://addyo.substack.com/p/the-70-problem-hard-truths-about">Addy Osmani, “The 70% Problem: Hard Truths About AI-Assisted Coding”</a>, 2024.</li><li id="ref-3"><a href="https://dora.dev/research/2025/dora-report/">DORA, <em>State of AI-assisted Software Development 2025</em></a>, Google Cloud, 2025.</li><li id="ref-4"><a href="https://martinfowler.com/articles/talk-about-platforms.html">Evan Bottcher, “What I Talk About When I Talk About Platforms”</a>, MartinFowler.com, 2018.</li><li id="ref-5"><a href="https://spark.hiforce.ai/docs/spark-cli/overview/">Spark CLI 总体介绍</a>, HiFORCE Spark, 2026.</li><li id="ref-6"><a href="https://www.forrester.com/blogs/appgen-is-here-say-goodbye-to-software-development-as-you-know-it/">Diego Lo Giudice and John Bratincevic, “AppGen Is Here: Say Goodbye To Software Development As You Know It”</a>, Forrester, 2025.</li><li id="ref-7"><a href="https://csrc.nist.gov/projects/ssdf">NIST, <em>Secure Software Development Framework (SSDF) Version 1.1</em></a>, 2022, updated 2026.</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/ai-coding-low-code-trusted-build/</id>
    <link href="https://ryu.xin/zh/posts/ai-coding-low-code-trusted-build/"/>
    <published>2026-08-05T16:00:00.000Z</published>
    <summary>AI Coding 正在削弱传统低代码的效率优势，却也让成熟组件、运行时契约与企业治理变得更重要。本文讨论自然语言、Spark CLI 与低代码如何组成可信的企业应用交付闭环。</summary>
    <title>AI Coding 会杀死低代码吗？</title>
    <updated>2026-08-05T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Organizations" scheme="https://ryu.xin/zh/tags/Organizations/"/>
    <category term="Books" scheme="https://ryu.xin/zh/tags/Books/"/>
    <content>
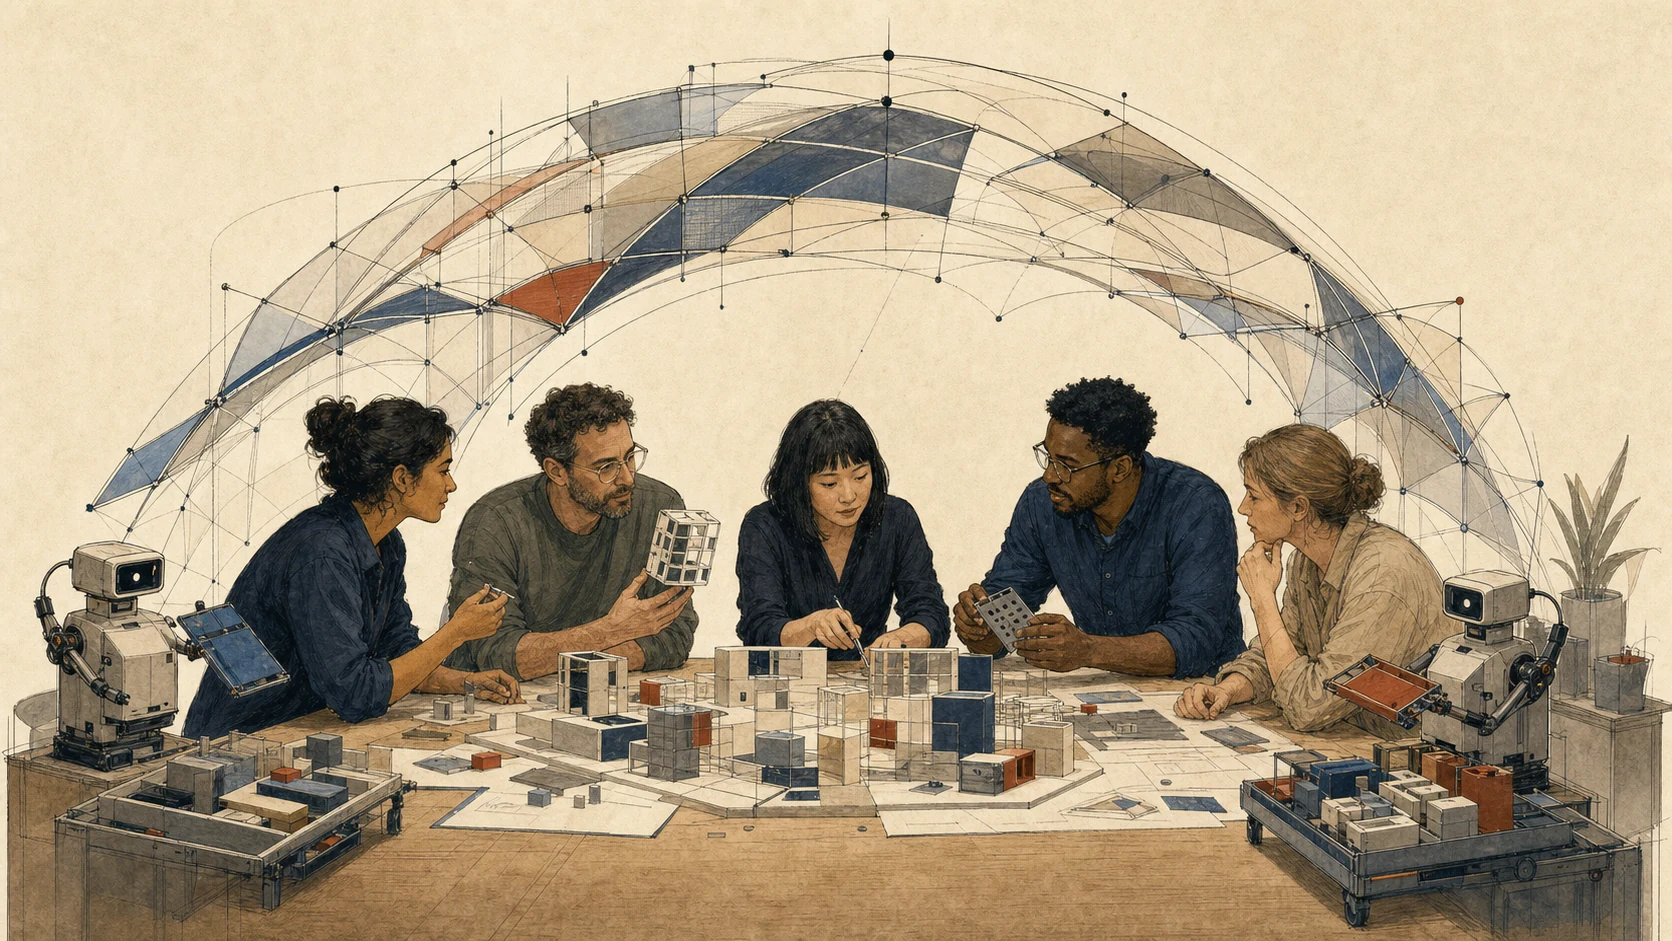
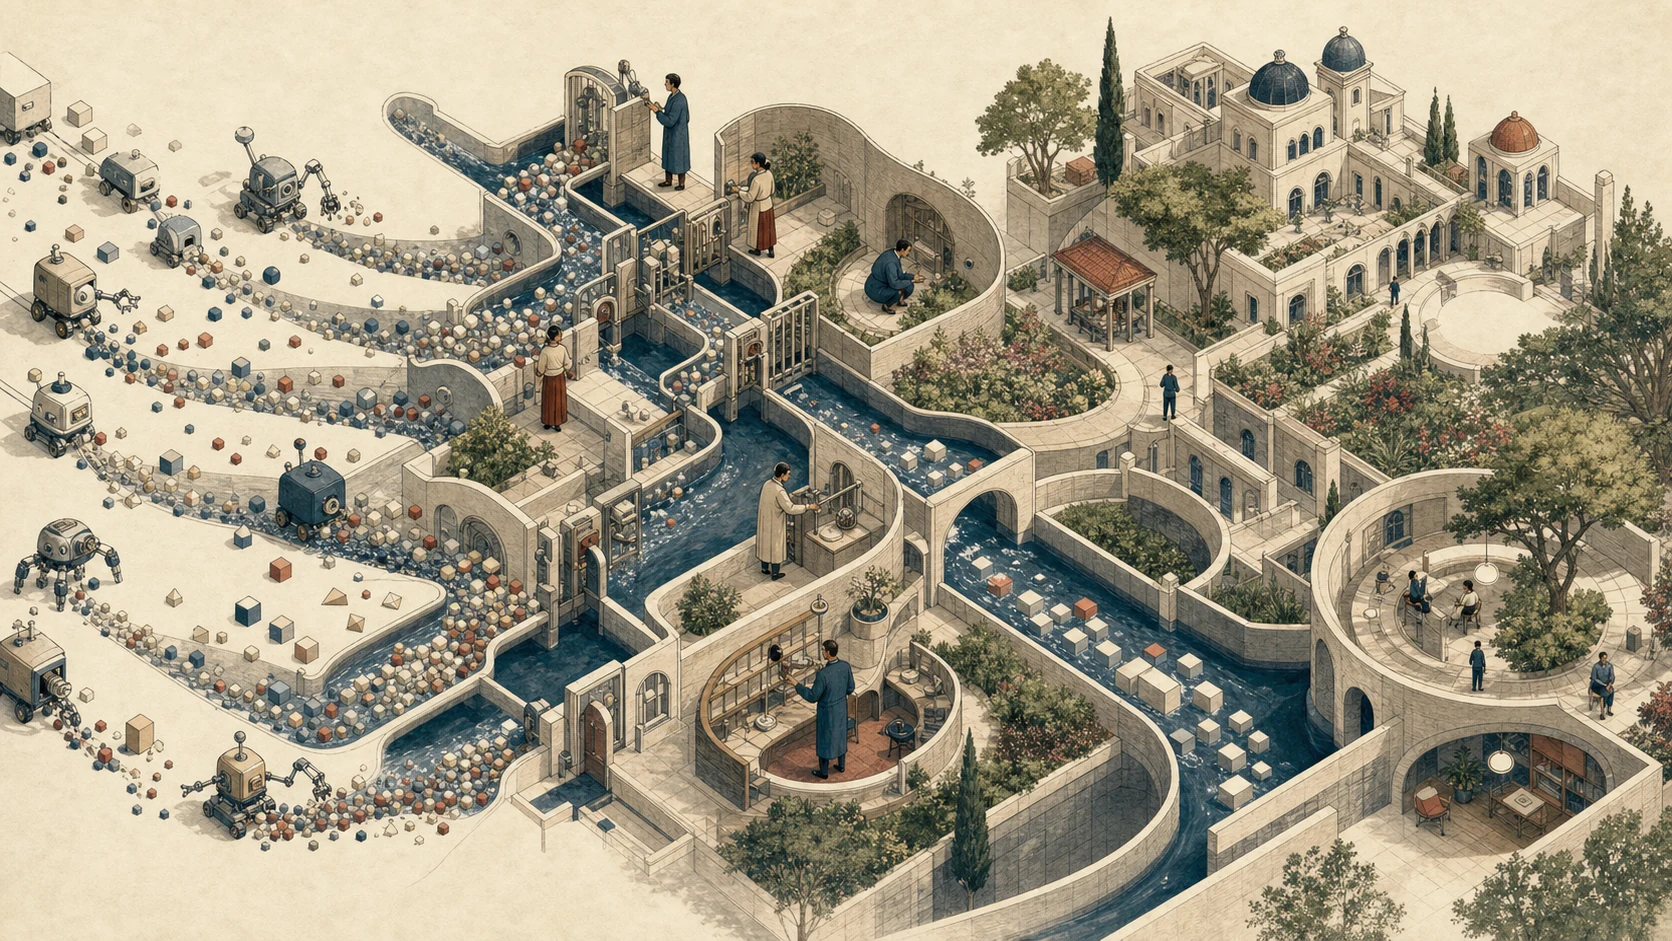
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>AI 把代码生成的速度推到了前所未有的高度，也制造了一个危险错觉：既然实现越来越便宜，软件项目就应该越来越快，团队也可以越来越小。真实情况更接近相反的一面——代码生成得越多，需要理解、验证、协调和长期拥有的内容也越多；Agent 越能并行，人的判断、注意力和责任越容易成为拥堵点。</p><p>《人件》讨论的从来不只是办公室噪声或管理技巧。它关心的是知识工作发生的条件：专注如何形成，团队如何凝聚，信任如何支持学习，管理又如何在不知不觉中摧毁生产力。AI 没有让这些问题过时，只是让干扰源从人扩展到了机器，让组织原有的优点与缺陷都获得了更大的杠杆。</p></header><p class="thesis">AI 改变了软件生产的速度，却没有改变《人件》揭示的事实：软件项目最复杂的部分，从来不是代码，而是置身其中的人。</p><p class="part-label">第一部分 · 被工具掩盖的人</p><h2 id="为什么今天应该重新阅读《人件》"><span class="section-no">01</span><a href="#为什么今天应该重新阅读《人件》" class="headerlink" title="为什么今天应该重新阅读《人件》"></a>为什么今天应该重新阅读《人件》</h2><p class="lead dropcap">第一次读《人件》时，我把它当作一本讲软件团队管理的书。书里那些问题都很具体：嘈杂的办公室、频繁的会议、不合理的工期、人员流动、团队凝聚力，以及管理者如何在不知不觉中毁掉一支原本优秀的团队。</p><p>AI 编程工具普及之后再读，我才意识到，Tom DeMarco 和 Timothy Lister 真正在追问的并不是办公桌应该怎样摆，而是一个更根本的问题：<strong>软件开发的主要瓶颈，究竟是技术，还是人？</strong></p><p>过去，我们很容易把效率问题理解为“程序员写得不够快”。于是行业不断发明更高级的语言、更强的框架、更完善的 IDE、更自动化的流水线。今天，AI 又把这条路推到了新的极限：一个开发者可以同时让多个 Agent 搜索仓库、修改代码、生成测试、分析日志和更新文档。几天的实现工作，几小时就能看到候选结果。</p><p>可是，项目并没有因此获得无限速度。需求仍然会含糊，系统仍然有历史，边界仍然需要取舍，发布仍然可能失败，责任也仍然要落到具体的人身上。《人件》第三版在 2013 年更新时仍把软件开发的核心挑战概括为“人的问题，而非技术问题”；到了 Agent 时代，这个判断没有变弱，反而变得更锋利。<sup class="ref"><a href="#ref-1">[1]</a></sup></p><blockquote><p>当执行变得便宜，定义、判断、验证与承担后果就会显得更昂贵。AI 没有消灭人的瓶颈，它只是把瓶颈从键盘前移到了决策链。</p></blockquote><h2 id="瓶颈没有消失，只是换了位置"><span class="section-no">02</span><a href="#瓶颈没有消失，只是换了位置" class="headerlink" title="瓶颈没有消失，只是换了位置"></a>瓶颈没有消失，只是换了位置</h2><p>在传统开发里，最显眼的稀缺资源是实现时间。产品排期往往围绕“写完需要多久”展开。AI 降低了这部分成本，却没有按相同比例降低其他成本：理解需求、选择方案、评审变更、核对业务规则、证明安全性、处理迁移、观察上线结果，以及在事故发生时恢复系统。</p><p>于是，成本开始向下游移动。过去可能是四小时编码、一小时检查；现在也许是十分钟生成、两小时理解和验证。前者的等待发生在生产之前，后者的拥堵发生在生产之后。只看生成阶段，会觉得速度提高了几十倍；看完整价值流，提升可能很小，甚至变成返工。</p><p>2025 年 DORA 的 AI 辅助软件开发研究把这种现象描述为系统问题：AI 会放大团队和交付系统里已经存在的条件。强平台、松耦合架构、快速反馈能吸收更高的变更量；薄弱测试、缓慢流程和紧耦合系统则会把更高产出转化为不稳定。<sup class="ref"><a href="#ref-6">[6]</a></sup></p><div class="callout"><p><strong>真正需要比较的不是“人工写代码”与“AI 写代码”的速度。</strong></p><p>而是从问题被提出，到价值被安全交付并能长期维护，整个系统的净吞吐是否提高。</p></div><p>这正是重读《人件》的起点：不要把工具的局部速度，误认成组织的整体生产力。</p><p class="part-label">第二部分 · 注意力成为新的生产线</p><h2 id="AI-消除了等待，却制造了更多打断"><span class="section-no">03</span><a href="#AI-消除了等待，却制造了更多打断" class="headerlink" title="AI 消除了等待，却制造了更多打断"></a>AI 消除了等待，却制造了更多打断</h2><p>《人件》中最经久不衰的主题之一，是不被打断的工作时间。对于程序员、设计师和架构师，高质量产出通常不在零散空隙里发生。问题背景、代码结构、业务约束和设计选项需要被同时装进大脑，经过一段连续时间，才会形成足以工作的心智模型。</p><p>进入状态可能要十五分钟，也可能要半小时。一条消息看似只占两分钟，真正损失的却是完整认知现场。心理学中的任务切换研究也反复观察到切换成本：人需要移动目标、重新激活规则，而规则越复杂，切换代价越高。<sup class="ref"><a href="#ref-2">[2]</a></sup></p><p>传统开发的打断大多来自人：产品经理问进度，测试人员反馈问题，领导临时拉会，同事请求协助。AI 时代，打断开始大量来自机器。</p><p>一个开发者同时运行三个、五个甚至更多 Agent：一个重构后端，一个生成前端，一个补测试，另一个分析生产日志。它们不断返回结果、提出问题、申请权限、报告失败或等待确认。于是开发者不再持续写一件事，而是在多个认知现场之间来回跳转：</p><ul><li>检查 Agent A 修改了哪些文件，是否越过任务边界；</li><li>判断 Agent B 的测试失败来自代码还是环境；</li><li>回忆 Agent C 采用了哪条方案、放弃了哪些假设；</li><li>阻止 Agent D 顺手重构并不属于本次任务的模块；</li><li>把相互独立的输出重新合并进同一个系统上下文。</li></ul><p>程序员从代码生产者变成了并发任务调度器。问题是，Agent 可以并行运行，人的理解、判断和责任承担仍然主要是串行的。</p><figure class="article-figure"><img src="/assets/articles/peopleware-ai-era/figure-peopleware-attention-bottleneck.webp?v=43cae87c946f1926" width="1672" height="941" loading="lazy" alt="一名工程师位于圆形工作空间中央，周围多个 AI 工具同时向中心输送任务和结果，象征人的注意力成为并发工作的瓶颈"><figcaption><p><strong>图 1 · 注意力瓶颈。</strong> 机器可以同时生产十条结果，人却必须逐条重建背景、判断风险并承担责任。并发增加的是候选产出，不是人的认知带宽。</p></figcaption></figure><p>这解释了一种很有时代特征的疲劳：一天里没有持续敲键盘，身体看起来也没有高强度劳动，人却异常疲惫。真正消耗他的，是不停重建上下文、判断例外和关闭认知回路。</p><div class="pullquote"><p>过去，管理者用会议打断程序员；今天，程序员可能亲手启动十个 Agent 来打断自己。</p></div><h2 id="真正稀缺的不是代码，而是高质量注意力"><span class="section-no">04</span><a href="#真正稀缺的不是代码，而是高质量注意力" class="headerlink" title="真正稀缺的不是代码，而是高质量注意力"></a>真正稀缺的不是代码，而是高质量注意力</h2><p>AI 编程最容易带来的误判，是把“实现成本下降”理解成“所有成本都下降”。实际上，当上游代码生成能力大幅增加，评审、测试、集成和决策会成为新的排队点。</p><p>代码可以并行生成，评审不能无限并行；方案可以批量产生，团队仍要逐个取舍；测试可以自动执行，失败原因仍需被理解；Agent 可以不断重试，生产事故最终仍由人承担。如果每条工作流都默认把异常抛给人，人的注意力就成了所有自动化共同争抢的单线程锁。</p><p>因此，管理者不能只问“还能再增加几个 Agent”，而要问一组完全不同的问题：</p><div class="principles"><div class="principle"><strong>输入是否值得</strong> — 哪些任务值得启动生成？哪些需求尚未清楚到可以委派？</div><div class="principle"><strong>输出是否可筛</strong> — 哪些结果应自动过滤、合并或拒绝，而不是全部推给工程师？</div><div class="principle"><strong>责任是否清楚</strong> — 谁拥有最终判断，谁验证业务正确性，谁决定合并与发布？</div><div class="principle"><strong>并发是否有上限</strong> — 一个人同时维护多少个活跃上下文，仍能理解系统整体？</div></div><p>如果这些问题没有答案，增加 Agent 就像在一条已经拥堵的流水线上继续提高上游速度：结果不是更高的交付效率，而是评审积压、测试爆仓、架构漂移和线上风险增加。</p><p>当生产能力变得廉价，组织更需要保护注意力，而不是继续透支注意力。</p><h2 id="代码增长了，团队认知却没有同步增长"><span class="section-no">05</span><a href="#代码增长了，团队认知却没有同步增长" class="headerlink" title="代码增长了，团队认知却没有同步增长"></a>代码增长了，团队认知却没有同步增长</h2><p>传统软件管理喜欢用可统计的活动代替难以衡量的价值：代码行数、提交次数、功能数量、任务完成率和迭代速度。AI 让这些指标变得更危险。</p><p>一个 Agent 几分钟就能生成几千行代码，一次建立十几个模块，也能把一个简单问题扩展成一场结构完整的重构。如果仍用产量衡量生产力，几乎每支团队的数据都能迅速变漂亮。</p><p>但代码不是资产本身。只有被团队理解、经过验证、能够演进并确实解决用户问题的代码，才可能成为资产。否则，AI 生成得越快，团队积累的不是能力，而是<strong>认知负债</strong>。</p><p>开发者亲手写代码时，通常经历过为什么这样设计、哪些边界最危险、哪些方案被放弃。就算文档不完整，这些决策至少曾进入某个人的思考。AI 生成的代码则可能绕过这个认知形成过程，直接进入仓库：它能运行、能通过测试，甚至更整洁，但团队中没有人真正拥有它。</p><figure class="article-figure"><img src="/assets/articles/peopleware-ai-era/figure-peopleware-cognitive-debt.webp?v=411f4e0c90bf18ba" width="1672" height="941" loading="lazy" alt="三名团队成员研究一张有限的系统图，狭窄桥梁另一端是由 AI 工具快速扩建的庞大模块化城市，象征系统规模超过团队理解范围"><figcaption><p><strong>图 2 · 认知负债。</strong> 系统在代码层面迅速扩大，团队共享的心智模型却仍停留在桥的另一端。真正的风险不是代码由谁写，而是是否有人能够解释、改变和恢复它。</p></figcaption></figure><p>这会产生一种项目幻觉：功能完成了，演示能运行，仓库也在增长；工程师面对的却是一个越来越陌生的系统。直到线上异常、业务规则变化或跨模块重构时，组织才发现，那些快速生成的代码并没有转化为可控制的软件能力。</p><p>METR 在 2025 年对 16 名熟悉成熟开源项目的开发者做随机对照研究，覆盖 246 个真实任务。在当时特定工具与样本条件下，允许使用 AI 的开发者平均反而多花约 19% 时间，而且主观上仍认为自己变快了。研究团队明确提醒这只是早期 2025 工具和特定人群的快照；到 2026 年，后续实验又受选择偏差影响，无法给出可靠的当前速度结论。它最值得保留的启示不是“AI 让人变慢”，而是：<strong>感觉更快不能替代对完整工作流的测量。</strong><sup class="ref"><a href="#ref-7">[7]</a></sup><sup class="ref"><a href="#ref-8">[8]</a></sup></p><div class="callout"><p><strong>《人件》提醒我们：</strong> 不要把人在座位上的时间当成有效工作时间。</p><p><strong>AI 时代还要补充一句：</strong> 不要把模型输出的数量，当成团队已经获得的能力。</p></div><p class="part-label">第三部分 · 团队不是可压缩的容器</p><h2 id="心理安全不是福利，而是-AI-可靠性的一部分"><span class="section-no">06</span><a href="#心理安全不是福利，而是-AI-可靠性的一部分" class="headerlink" title="心理安全不是福利，而是 AI 可靠性的一部分"></a>心理安全不是福利，而是 AI 可靠性的一部分</h2><p>《人件》反复强调，真正凝聚起来的团队不是靠管理命令组装的。它拥有信任、共同目标、身份认同和一定程度的自主权。这些条件在 AI 时代不是变得次要，而是变得更关键。</p><p>当 AI 可以完成越来越多编码工作，工程师会自然地产生不安：我的经验是否正在贬值？公司引入 AI 是为了帮助我，还是为了减少人？如果我把工作方法沉淀成 Skill 或 Agent，以后还需要我吗？AI 生成的代码出了问题，责任到底算谁的？</p><p>管理者若回避这些问题，只重复“降本增效”，成员就会开始理性地自我保护：有人隐藏工作方法，不愿让经验成为组织资产；有人表面采用 AI，实际拒绝改变；有人制造只有自己能解释的复杂性；也有人对模型输出降低责任感，觉得“反正不是我写的”。</p><p>Amy Edmondson 将团队心理安全定义为一种共同信念：在这个团队里承担人际风险是安全的。她对 51 个团队的研究发现，心理安全与学习行为相关，而学习行为又连接到团队绩效。<sup class="ref"><a href="#ref-3">[3]</a></sup> AI 协作恰好需要更多这种风险承担——成员必须愿意说：</p><ul><li>“我还没有理解这段生成代码。”</li><li>“这个结果虽然通过测试，但我不相信它覆盖了真实风险。”</li><li>“我刚才的提示方向错了，需要推翻重来。”</li><li>“这个任务不适合继续自动化，应该先把需求说清楚。”</li></ul><figure class="article-figure"><img src="/assets/articles/peopleware-ai-era/figure-peopleware-psychological-safety.webp?v=790d147eef7c493b" width="1672" height="941" loading="lazy" alt="五名团队成员围绕共享桌面讨论不完整的系统模型，协作形成保护性的结构穹顶，AI 工具在两侧提供材料"><figcaption><p><strong>图 3 · 安全感形成学习空间。</strong> 团队可以把不完整的模型、疑问和坏消息放上同一张桌子，才有机会在代码进入生产之前发现错误。Agent 提供材料，信任决定材料能否被诚实评估。</p></figcaption></figure><p>如果组织不允许人说“我不知道”，AI 就会放大虚假的确定性：模型自信地给出答案，工程师不敢提出异议，管理者又急于展示成果。三种力量叠加之后，一段无人真正理解的代码便顺利通过所有人的视线。</p><div class="pullquote"><p>心理安全不是温和的企业福利，而是让坏消息能赶在事故之前抵达团队的可靠性机制。</p></div><h2 id="AI-时代的-Teamicide：团队如何被更快地摧毁"><span class="section-no">07</span><a href="#AI-时代的-Teamicide：团队如何被更快地摧毁" class="headerlink" title="AI 时代的 Teamicide：团队如何被更快地摧毁"></a>AI 时代的 Teamicide：团队如何被更快地摧毁</h2><p>《人件》用了一个尖锐的词：<em>Teamicide</em>，团队自毁。很多团队不是能力不足，而是被管理方式逐渐瓦解：不现实的期限、频繁调整成员、内部竞争、过度标准化，以及用流程替代信任。</p><p>AI 又增加了几种新的自毁方式。</p><h3 id="把工程师变成-Agent-操作员"><a href="#把工程师变成-Agent-操作员" class="headerlink" title="把工程师变成 Agent 操作员"></a>把工程师变成 Agent 操作员</h3><p>如果管理者认为模型已经能够完成大部分技术工作，于是逐渐收走工程师的设计空间，只要求接收任务、调用模型、提交结果，短期可能提高产量，长期却会让团队失去判断能力。一个长期不需要做设计决策的人，最终也会失去做设计决策的能力。</p><h3 id="用-AI-强化个人产量竞赛"><a href="#用-AI-强化个人产量竞赛" class="headerlink" title="用 AI 强化个人产量竞赛"></a>用 AI 强化个人产量竞赛</h3><p>谁生成的代码更多、谁关闭任务更快、谁同时运行的 Agent 更多——这些指标看似客观，却会推动成员追求局部产出，减少共同评审、知识共享和集体责任。SPACE 生产力框架早已指出，开发者生产力涉及满意度与福祉、绩效、活动、沟通协作、效率与流动，不能由单一活动指标替代。<sup class="ref"><a href="#ref-4">[4]</a></sup> 当生成成本下降，活动数量与真实价值之间的距离只会更大。</p><h3 id="不断削减人数，直到系统失去组织记忆"><a href="#不断削减人数，直到系统失去组织记忆" class="headerlink" title="不断削减人数，直到系统失去组织记忆"></a>不断削减人数，直到系统失去组织记忆</h3><p>管理者看到部分任务可以自动完成，便推断原来十个人的工作现在只需要三个人。可那十个人承担的不只是编码，还有业务记忆、异常判断、跨部门协调、值班经验、客户语境和风险缓冲。这些能力很少出现在任务统计里，却决定团队在意外发生时能否恢复。</p><p>裁掉的可能是“看起来没有直接产出的人”，失去的却是系统最难重新生成的上下文。</p><div class="table-wrap"><table><caption>AI 时代三种常见的 Teamicide</caption><thead><tr><th>管理动作</th><th>短期表象</th><th>长期损失</th></tr></thead><tbody><tr><td>把工程师降格为操作员</td><td>任务完成更快、流程更统一</td><td>设计判断萎缩，复杂问题无人拥有</td></tr><tr><td>按 AI 活动量排名</td><td>提交、代码和关闭数上升</td><td>局部优化、评审敷衍、知识私有化</td></tr><tr><td>按可自动化任务裁员</td><td>人力成本迅速下降</td><td>组织记忆、风险冗余与恢复能力消失</td></tr></tbody></table></div><h2 id="最好的-AI-团队，不是人最少的团队"><span class="section-no">08</span><a href="#最好的-AI-团队，不是人最少的团队" class="headerlink" title="最好的 AI 团队，不是人最少的团队"></a>最好的 AI 团队，不是人最少的团队</h2><p>AI 时代很容易产生一种极端想象：未来的软件公司只需要一个创始人，加上一群永远在线的 Agent。这种模式确实可以快速产生原型，甚至运营边界清楚的小产品。但复杂系统的长期建设仍然需要团队，因为真正困难的问题很少只是“怎样生成代码”。</p><p>复杂系统需要不同责任视角之间的碰撞。架构师关注长期演进，开发者关注实现与可读性，测试人员寻找失败路径，运维人员关注运行时行为，产品人员判断用户价值，安全人员思考正常流程之外的攻击方式。</p><p>AI 可以模拟这些角色，列出它们可能关心的问题，却很难替代真实责任带来的判断。负责生产稳定性的人，会对一次看似无害的依赖升级保持警惕；经历过资金差错的人，会本能追问幂等性；长期服务某类客户的人，知道需求文档里哪一句话才是不能妥协的约束。这些判断来自经历、责任与后果，不只是来自知识。</p><p>所以，AI 时代优秀团队的目标不应该是无限减少人数，而是把人的时间从机械实现转移到更高价值的工作：定义问题、设计边界、验证事实、处理例外、积累知识、修复系统，以及在不同利益之间做出可以被解释的取舍。</p><div class="callout"><p><strong>AI 的价值不是把团队消灭，而是让团队重新分配注意力。</strong></p><p>减少无意义劳动是手段；保留判断能力、学习能力和恢复能力，才是组织真正得到的回报。</p></div><p class="part-label">第四部分 · 为人和 Agent 共同设计环境</p><h2 id="管理者的新职责：重新设计工作环境"><span class="section-no">09</span><a href="#管理者的新职责：重新设计工作环境" class="headerlink" title="管理者的新职责：重新设计工作环境"></a>管理者的新职责：重新设计工作环境</h2><p>《人件》认为，管理者的主要工作不是让人们忙起来，而是创造一个让人们能够完成工作的环境。到了 AI 时代，这句话依然成立，只是“环境”的边界扩大了。</p><p>它不再只包括安静的空间、合理的会议和稳定的团队，还包括：Agent 能访问什么资源；哪些操作必须由人批准；什么结果必须自动验证；一个任务允许修改多大范围；上下文如何保存与交接；多条工作流怎样避免互相覆盖；失败后系统如何停止、回滚和恢复；谁对最终结果负责。</p><p>这些规则不能靠一句提示词解决。如果组织只是给每个人购买 AI 工具，却不重新设计开发流程，AI 最终只会成为附加在旧系统上的加速器：它让代码更快地产生，却不能让需求更清楚、决策更合理，也不会让测试、发布和恢复能力自动提升。</p><figure class="article-figure"><img src="/assets/articles/peopleware-ai-era/figure-peopleware-human-agent-environment.webp?v=630ce7b744eb3d61" width="1672" height="941" loading="lazy" alt="AI 工具从左侧输送大量模块，系统中的人通过分流、验证、恢复通道和安静工作空间，将其整理为右侧稳定而宜人的共同环境"><figcaption><p><strong>图 4 · 环境就是控制系统。</strong> 管理不是催促上游生成更多，而是设计边界、门禁、反馈、恢复路径与安静空间，让速度最终抵达一个人能够理解和长期拥有的系统。</p></figcaption></figure><p>真正的变化，是把软件流程设计成一个人和 Agent 共同工作的运行系统：机器负责搜索、生成、重复执行和初步验证；人负责定义目标、处理模糊性、判断取舍、识别风险并承担责任。两者之间需要清晰的接口，也需要不耗尽人的节奏。</p><h2 id="把人的注意力当作容量，而不是免费资源"><span class="section-no">10</span><a href="#把人的注意力当作容量，而不是免费资源" class="headerlink" title="把人的注意力当作容量，而不是免费资源"></a>把人的注意力当作容量，而不是免费资源</h2><p>AI 工作流最常见的设计错误，是只计算模型吞吐，不计算人的吸收能力。生成一个补丁的成本可以接近零，但把它变成可信变更，需要评审时间、领域知识、测试证据和发布窗口。任何一项不足，候选结果都会排队。</p><div class="equation"><p><strong>有效交付能力 = min（生成能力，理解能力，验证能力，发布与恢复能力）</strong> 这是管理视角的约束表达，不是严格数学模型：系统吞吐由最窄的瓶颈决定。</p></div><p>这意味着，一个团队即使拥有无限 Agent，有效吞吐仍然不会超过其最薄弱的控制环节。更糟的是，过量在制品会反过来损伤理解能力：未完成的评审、等待回答的问题、并行分支和悬而未决的方案占据工作记忆，增加每次切换的恢复成本。</p><p>因此，限制并行不是落后，而是保护认知完整性的工程措施。实践中可以从几个朴素动作开始：</p><ul><li>给每位工程师设置活跃 Agent 工作流上限，而不是鼓励无限并发；</li><li>把低置信、重复和越界结果先由自动门禁过滤，再请求人的注意；</li><li>要求每个 Agent 交付变更摘要、关键假设、验证证据和未覆盖风险；</li><li>给复杂任务保留连续、无通知的理解与评审时段；</li><li>测量从开始到安全上线的周期，而不是只测模型生成用时。</li></ul><p>生产力研究也支持这种多维视角：SPACE 框架拒绝单指标，DORA 强调平台、流程、架构和价值流对 AI 效果的调节。<sup class="ref"><a href="#ref-4">[4]</a></sup><sup class="ref"><a href="#ref-6">[6]</a></sup> 管理者真正需要优化的不是“每个人调用多少次模型”，而是团队能否以更低认知负担、更稳定的质量，把正确价值交付出去。</p><h2 id="六条面向-AI-团队的《人件》原则"><span class="section-no">11</span><a href="#六条面向-AI-团队的《人件》原则" class="headerlink" title="六条面向 AI 团队的《人件》原则"></a>六条面向 AI 团队的《人件》原则</h2><p>把《人件》带进 Agent 工作流，不需要先发明一套宏大的管理体系。更有效的起点，是把对人的尊重变成具体的系统约束。</p><div class="principles"><div class="principle"><strong>01 · 保护连续专注</strong> — 将深度理解和评审时间视为生产资源；集中处理 Agent 回报，不让每个事件都即时打断。</div><div class="principle"><strong>02 · 限制在制品</strong> — 根据人的理解与验证容量限制并发，而不是根据工具能启动多少任务设置目标。</div><div class="principle"><strong>03 · 让责任跟随决定</strong> — 明确谁定义目标、谁批准风险、谁拥有上线结果；“由 AI 生成”不能成为责任真空。</div><div class="principle"><strong>04 · 奖励共享能力</strong> — 奖励可复用的知识、评审质量和团队结果，不用代码量、提交数或 Agent 数量制造竞赛。</div><div class="principle"><strong>05 · 允许暴露不确定性</strong> — 领导者主动示范提问、承认不知道、感谢坏消息，让质疑模型结果成为正常工程行为。</div><div class="principle"><strong>06 · 保留组织记忆与冗余</strong> — 不要把暂时没有显性产出的经验视为浪费；稳定团队、交叉学习和恢复能力是系统保险。</div></div><div class="diagnostic"><h3>给管理者的五分钟诊断</h3><ol><li>团队能否说出当前最稀缺的是生成、理解、验证还是发布能力？</li><li>一个工程师有多少条活跃 Agent 工作流？这个数字是有意识设定的吗？</li><li>最近一次模型输出被明确拒绝，理由是否被记录并转化为规则或评测？</li><li>成员能否公开说“我不理解这段代码”，而不担心被评价为不会使用 AI？</li><li>AI 节省的时间被重新投入了学习、质量与用户价值，还是立刻变成了更多任务？</li></ol></div><h2 id="AI-越强，《人件》越重要"><span class="section-no">12</span><a href="#AI-越强，《人件》越重要" class="headerlink" title="AI 越强，《人件》越重要"></a>AI 越强，《人件》越重要</h2><p>《人月神话》告诉我们，软件项目不能靠增加人力获得线性加速，因为沟通与协调成本会迅速上升。《人件》进一步提醒我们：即使人数不增加，即使工具更强，只要忽视人的认知、情绪、关系和工作环境，生产力仍会崩溃。</p><p>AI 没有推翻这两本书。它只是让旧问题换了一种形式。</p><p>过去，我们担心给延期项目增加更多程序员；今天，我们要警惕给失控流程增加更多 Agent。过去，管理者用会议、报表和流程占满工程师的时间；今天，工程师可能被模型输出、权限申请、评审请求和并行任务占满注意力。过去，团队因为办公室噪声无法进入心流；今天，团队可能因为永不停歇的 AI 工作流失去完整思考。</p><p>工具越强，人越容易被看成系统里缓慢、昂贵、可以继续压缩的部分。但恰恰在这个时候，人的判断、信任、责任感和创造力变得更珍贵。AI 可以生成代码，却不能替组织决定什么值得建设；可以提供方案，却不能替团队承担选择的后果；可以模拟协作角色，却不会自动创造真正的信任。</p><p>重读《人件》之后，我最大的感受，不是“人仍然不会被 AI 替代”这种简单的乐观判断，而是一个更严肃的结论：</p><p>AI 不会自动让软件组织变得更好。它只会放大组织原本的样子。</p><p>一个信任员工、保护专注、重视质量的组织，会借助 AI 获得巨大的能力提升；一个迷信指标、透支团队、追求短期产量的组织，则会用 AI 更快地制造技术债、认知债和组织债。DORA 在 2025 年把 AI 称为“放大器”，正好给了这个判断一份当代注脚。<sup class="ref"><a href="#ref-5">[5]</a></sup></p><p>未来真正领先的软件团队，未必拥有最多的 Agent，也未必永远使用最强的模型。它们更可能是那些最早明白：当代码不再稀缺，真正需要保护的，是人。</p><section class="references" id="references"><h2 data-no-number="true">参考文献与延伸阅读</h2><p class="note">书名与论文名保留原文。本文关于组织与 AI 的判断以《人件》为主线，研究资料用于校准任务切换、心理安全与生产力测量等关键概念；链接均指向出版机构、论文页或研究团队。</p><ol><li id="ref-1">DeMarco, Tom, and Timothy Lister. <em><a href="https://www.pearson.com/en-us/subject-catalog/p/peopleware-productive-projects-and-teams/P200000000214/9780321934116">Peopleware: Productive Projects and Teams</a></em>, 3rd ed. Addison-Wesley Professional, 2013.</li><li id="ref-2">Rubinstein, Joshua S., David E. Meyer, and Jeffrey E. Evans. “<a href="https://pubmed.ncbi.nlm.nih.gov/11518143/">Executive Control of Cognitive Processes in Task Switching</a>.” <em>Journal of Experimental Psychology: Human Perception and Performance</em>, 27(4), 2001.</li><li id="ref-3">Edmondson, Amy. “<a href="https://doi.org/10.2307/2666999">Psychological Safety and Learning Behavior in Work Teams</a>.” <em>Administrative Science Quarterly</em>, 44(2), 1999.</li><li id="ref-4">Forsgren, Nicole, et al. “<a href="https://www.microsoft.com/en-us/research/publication/the-space-of-developer-productivity-theres-more-to-it-than-you-think/">The SPACE of Developer Productivity: There’s More to It Than You Think</a>.” <em>ACM Queue</em>, 19(1), 2021.</li><li id="ref-5">Harvey, Nathen, and Derek DeBellis. “<a href="https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report">Announcing the 2025 DORA Report: State of AI-Assisted Software Development</a>.” Google Cloud Blog, 2025.</li><li id="ref-6">DORA / Google Cloud. “<a href="https://cloud.google.com/resources/content/2025-dora-ai-assisted-software-development-report">2025 State of AI-Assisted Software Development Report</a>.” 2025.</li><li id="ref-7">Becker, Joel, et al. “<a href="https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/">Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity</a>.” METR, 2025.</li><li id="ref-8">Becker, Joel, et al. “<a href="https://metr.org/blog/2026-02-24-uplift-update/">We Are Changing Our Developer Productivity Experiment Design</a>.” METR, 2026.</li><li id="ref-9">Brooks, Frederick P. Jr. <em>The Mythical Man-Month: Essays on Software Engineering</em>. Addison-Wesley, 1975; Anniversary Edition, 1995.</li><li id="ref-10">Skelton, Matthew, and Manuel Pais. <em>Team Topologies: Organizing Business and Technology Teams for Fast Flow</em>. IT Revolution, 2019.</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/peopleware-ai-era/</id>
    <link href="https://ryu.xin/zh/posts/peopleware-ai-era/"/>
    <published>2026-07-30T16:00:00.000Z</published>
    <summary>重读《人件》：当 AI 让代码生成变得廉价，软件组织真正需要保护的是人的注意力、信任、判断与共同责任。</summary>
    <title>重读《人件》：AI 越强，软件开发越是一场关于人的战争</title>
    <updated>2026-07-30T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Books" scheme="https://ryu.xin/zh/tags/Books/"/>
    <category term="Architecture" scheme="https://ryu.xin/zh/tags/Architecture/"/>
    <content>
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>生成式 AI 把代码生产的边际成本压到了前所未有的水平，也制造了一种诱人的错觉：既然代码可以被迅速生成，软件工程的旧规律就将失效。本文提出相反判断。《人月神话》最值得保留的从来不是对某种编程工具的评价，而是它对复杂性、沟通、组织结构与概念完整性的观察。AI 改变了劳动分工和反馈速度，却没有自动决定产品应该成为什么、系统应承担何种约束、风险由谁负责。</p><p>文章逐章重释 Brooks 的核心思想，并将其延伸到 Coding Agent、多智能体协作、上下文工程、知识库、架构约束、评测与可观测性。结论不是“AI 只是新工具”，也不是“AI 将替代软件工程”，而是：软件工程的控制面正在从代码本身上移到知识、边界与验证系统。</p></header><p class="thesis">AI 没有终结《人月神话》。它把这本书的问题，从“如何组织程序员生产代码”，升级成了“如何组织人和智能体共同控制复杂性”。</p><p class="part-label">第一部分 · 回到 Brooks 的问题现场</p><h2 id="为什么今天应该重新阅读《人月神话》"><span class="section-no">01</span><a href="#为什么今天应该重新阅读《人月神话》" class="headerlink" title="为什么今天应该重新阅读《人月神话》"></a>为什么今天应该重新阅读《人月神话》</h2><p class="lead dropcap">1975 年，《人月神话》首次出版。半个世纪之后，我们用自然语言要求模型写接口、补测试、迁移框架，甚至让多个 Agent 在隔离环境中并行处理问题。表面看，这是 Brooks 所处时代无法想象的生产力跃迁；更深处看，我们又一次站到了他熟悉的泥潭边：产出增加了，系统却未必更容易理解；参与者增加了，项目却未必更快完成。</p><p>这本书经久不衰，是因为它讨论的并非某种语言、流程或工具，而是软件开发中的比例关系：可并行工作与不可并行决策的比例，局部效率与整体吞吐的比例，新增功能与新增认知负担的比例，以及创造速度与验证能力的比例。工具会让这些比例变化，却不会让它们消失。</p><p>AI 时代最容易被放大的，是“可见的产出”：代码行、提交数、原型数量、关闭的任务。最不容易被看见的，则是产出背后的债务：没有被记录的假设、边界条件、隐含耦合、权限漏洞、迁移路径、值班负担和未来维护者需要重新建立的心智模型。Brooks 的价值，恰好是迫使我们把目光从产出移向系统。</p><p>因此，重读不是给旧结论换上 AI 名词，而是重新追问三个问题：第一，AI 究竟消除了哪些成本，又把哪些成本转移到了下游？第二，当执行者从人扩展为 Agent，沟通与协调的结构发生了什么变化？第三，什么样的知识和治理机制，能让更快的生成速度转化为长期可持续的软件能力？</p><h2 id="一场五十亿美元豪赌留下的工程经验"><span class="section-no">02</span><a href="#一场五十亿美元豪赌留下的工程经验" class="headerlink" title="一场五十亿美元豪赌留下的工程经验"></a>一场五十亿美元豪赌留下的工程经验</h2><p>Brooks 的判断不是书斋推演。IBM 在 1964 年推出 System/360，用统一架构替代多条互不兼容的产品线。IBM 将其称为一场耗资五十亿美元、几乎押上公司的豪赌；Fred Brooks 是项目领导者之一。System/360 最重要的商业承诺，是让软件可以跨同一系列机器运行，让客户扩展硬件时不必重写全部程序。<sup class="ref"><a href="#ref-3">[3]</a></sup></p><p>统一的硬件架构创造了平台，却也把前所未有的复杂性推给了 OS/360。硬件兼容、不同配置、交付排期、团队扩张与沟通链路交织在一起。正是在这种大规模工程的压力下，Brooks 看见一个反直觉事实：软件工作无法像搬砖一样，把总量平均分给更多人。许多任务存在顺序依赖；新成员需要学习；接口需要协商；已有成员还要花时间解释和整合。</p><p>今天的相似之处并不是 AI 像 1960 年代的程序员，而是我们也在进行一次平台迁移。过去的软件组织把“人能写多少代码”当成稀缺资源；现在代码供给迅速扩张，稀缺资源开始转向高质量问题定义、领域判断、架构上下文、可信验证和上线责任。生产函数变了，但任何组织如果继续用旧指标管理新稀缺性，都会得到大量看似完成、实际上未被吸收的工作。</p><div class="callout"><p><strong>历史的真正类比：</strong> System/360 通过统一架构释放了软件复用，却让操作系统工程暴露出新的规模问题；AI 通过统一的自然语言接口释放了代码生成，也会让知识一致性、验证容量与责任边界暴露出新的规模问题。</p></div><h2 id="软件工程五十年，到底改变了什么"><span class="section-no">03</span><a href="#软件工程五十年，到底改变了什么" class="headerlink" title="软件工程五十年，到底改变了什么"></a>软件工程五十年，到底改变了什么</h2><p>如果只看技术名词，过去五十年几乎每十年都发生一次“范式革命”；如果看工程目标，变化却高度连续。结构化程序设计减少控制流的任意性，面向对象尝试把数据与行为组织成可理解的单元，敏捷缩短需求与反馈之间的距离，云计算把基础设施变成可编程资源，DevOps 让构建、测试、发布和运维形成闭环，平台工程再把这些能力产品化。AI Coding 与 Agent Engineering 处在这条链的下一段：它们把“产生候选实现”与“执行工具链”变成可委派能力。</p><dl class="timeline"><dt>1968</dt><dd>“软件危机”进入公共讨论；软件工程开始被当作独立学科。</dd><dt>1975</dt><dd>《人月神话》总结大型软件项目中的进度、组织与设计经验。</dd><dt>1987</dt><dd>Brooks 发表《没有银弹》，区分本质复杂性与偶然复杂性。<sup class="ref"><a href="#ref-2">[2]</a></sup></dd><dt>1990s</dt><dd>面向对象、设计模式与开源协作扩大软件复用边界。</dd><dt>2001</dt><dd>敏捷宣言强调个体互动、可工作的软件、客户协作与响应变化。<sup class="ref"><a href="#ref-10">[10]</a></sup></dd><dt>2010s</dt><dd>云、持续交付、SRE 与 DevOps 把反馈和运营纳入日常工程。</dd><dt>2021</dt><dd>自然语言代码补全走向大众化，开发者开始与模型结对。</dd><dt>2024</dt><dd>工具调用、MCP 等协议推动模型连接代码库、数据与外部系统。<sup class="ref"><a href="#ref-28">[28]</a></sup></dd><dt>2025–26</dt><dd>Coding Agent 从补全走向自主读取仓库、修改、运行测试、提交审阅，并出现多 Agent 工作台。<sup class="ref"><a href="#ref-24">[24]</a></sup><sup class="ref"><a href="#ref-25">[25]</a></sup></dd></dl><p>这条时间线说明，AI 并不是凭空降临的软件革命，而是抽象层不断上移的延续。每次上移都会消除一部分手工劳动，同时产生新的控制面：高级语言需要编译器与类型系统，云需要基础设施即代码与可观测性，持续交付需要自动化门禁，Agent 则需要上下文、工具权限、运行轨迹、评测和人工审批。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-01-software-engineering-evolution.webp?v=9911dc6986b6ec1d" width="1672" height="941" loading="lazy" alt="软件工程五十年演进横向时间轴：从 Code、Framework、Platform、Cloud、AI Coding、Agent Engineering 到 Knowledge Engineering，并区分控制层上移与执行层自动化"><figcaption><p><strong>图 1 · 软件工程五十年演进</strong>　从 Code 到 Knowledge Engineering，执行层持续自动化，工程控制面则从实现细节逐步上移到编排、约束与组织知识。</p></figcaption></figure><p class="part-label">第二部分 · 八个经典命题的 AI 时代重释</p><h2 id="AI-改变代码速度，却没有取消本质复杂性"><span class="section-no">04</span><a href="#AI-改变代码速度，却没有取消本质复杂性" class="headerlink" title="AI 改变代码速度，却没有取消本质复杂性"></a>AI 改变代码速度，却没有取消本质复杂性</h2><p>在《没有银弹》中，Brooks 区分了两类困难：<em>essential complexity</em>，来自问题本身必须表达的复杂关系；<em>accidental complexity</em>，来自工具、表示方法和实现过程附加的困难。这个区分经常被粗暴改写成“AI 只能消灭偶然复杂性”，但现实更细腻。</p><p>AI 确实显著压低了许多实现成本。样板代码、数据转换、常见接口、测试脚手架、查询语句、文档初稿和跨语言翻译，都可以更快生成。它也能帮助人探索本质问题：归纳访谈、提出反例、模拟方案、检索代码依赖、解释陌生领域。换言之，AI 不只是在更快地打字，它也可以扩展人的思考带宽。</p><p>然而“帮助理解”不等于“消除本质”。一家银行仍需决定在何种证据下拒绝交易；医疗系统仍需定义何为可接受风险；协作产品仍需处理权限继承、数据保留与合规冲突。模型可以提出候选答案，却不能让这些取舍从现实中消失，也不能自动获得承担后果的授权。</p><p>更值得警惕的是，偶然复杂性的下降会刺激系统规模增长。当新增一个服务、一个配置项或一条自动化流程的成本接近于零，团队更容易选择“再加一个”。局部实现变简单，系统整体可能反而更复杂。这是一种复杂性反弹：节省下来的编码成本，被更多功能、更多依赖和更多运行状态重新消费。</p><blockquote><p>“There is no single development … which by itself promises even one order-of-magnitude improvement.”</p><p>Frederick P. Brooks Jr., “No Silver Bullet”, 1987（短引）</p></blockquote><p>Brooks 反对的不是进步，而是“单一突破带来数量级改善”的幻想。AI 当然可能给特定任务带来数量级提升；但当衡量单位从“生成一个函数”扩大到“把正确系统安全地运行十年”，承诺就必须重新接受检验。</p><h2 id="Brooks-定律：更多-Agent-也会让坏架构更快失控"><span class="section-no">05</span><a href="#Brooks-定律：更多-Agent-也会让坏架构更快失控" class="headerlink" title="Brooks 定律：更多 Agent 也会让坏架构更快失控"></a>Brooks 定律：更多 Agent 也会让坏架构更快失控</h2><blockquote><p>“Adding manpower to a late software project makes it later.”</p><p>《人月神话》第二章（短引）</p></blockquote><p>这条定律成立，有三个条件：任务不能完全切分，新参与者需要获得上下文，最终产物必须被整合。人类团队如此，Agent 系统同样如此。十个 Agent 并不天然等于十倍吞吐，因为它们可能读到不同版本的需求、重复修改同一区域、基于不一致假设设计接口，并把冲突留给最后的集成者。</p><p>Agent 的“入职成本”看似比人低：给它仓库、指令和工具即可开工。但它的上下文不是稳定的长期理解，而是每次运行中被选择、压缩和重建的信息。更多并行任务意味着更多上下文切片、更多分支、更多测试占用，以及更多需要人工判断的候选变更。若系统边界模糊，Agent 会非常高效地扩大模糊。</p><p>因此，AI 时代的 Brooks 定律可以表述为：<strong>向一个已经失去概念边界的项目增加更多 Agent，通常只会更快地产生更多不可整合的局部正确。</strong> 解决办法不是拒绝并行，而是先提高任务可分解性：定义所有权、冻结接口、提供验收条件、限制写入范围、让每项变更独立验证，再决定并发度。</p><div class="table-wrap"><table><caption>人类扩编与 Agent 扩编的协调成本</caption><thead><tr><th>成本来源</th><th>人类团队</th><th>Agent 团队</th><th>工程对策</th></tr></thead><tbody><tr><td>上下文获取</td><td>培训、会议、代码阅读</td><td>检索、提示、上下文压缩</td><td>高信号项目地图与任务包</td></tr><tr><td>决策一致性</td><td>经验和理解差异</td><td>提示、模型和采样差异</td><td>ADR、契约、示例与不变量</td></tr><tr><td>写入冲突</td><td>多人修改同一模块</td><td>并行分支产生语义冲突</td><td>所有权边界与小批量合并</td></tr><tr><td>质量判断</td><td>评审者注意力有限</td><td>候选产出远快于验证</td><td>自动门禁加风险分级审阅</td></tr><tr><td>责任归属</td><td>角色与组织授权</td><td>Agent 不能承担上线责任</td><td>明确的人类批准者和回滚路径</td></tr></tbody></table></div><h2 id="The-Surgical-Team：Agent-是数字手术队吗"><span class="section-no">06</span><a href="#The-Surgical-Team：Agent-是数字手术队吗" class="headerlink" title="The Surgical Team：Agent 是数字手术队吗"></a>The Surgical Team：Agent 是数字手术队吗</h2><p>Brooks 借鉴 Harlan Mills 的“外科手术式团队”：由一位首席程序员保持设计与实现的智识统一，其他成员像麻醉师、器械师和助手一样提供专业支持。它的重点不是英雄主义，而是避免把同一个核心设计平均切给许多人，再期待它自行长成一个一致系统。</p><p>Coding Agent 让这个构想获得新的现实形态。一个负责人可以让不同 Agent 分别搜索历史、编写迁移脚本、补充测试、检查安全风险、更新文档；负责人保留问题定义、方案选择和最终合并权。OpenAI 在 2025 年介绍 Codex 时，就把它描述为可在隔离云环境中并行处理软件任务、运行测试并提出待审阅变更的工程 Agent；到 2026 年，产品界面进一步转向对多个长任务 Agent 的监督。<sup class="ref"><a href="#ref-24">[24]</a></sup><sup class="ref"><a href="#ref-25">[25]</a></sup></p><p>但“数字手术队”只有在主刀真正掌握系统时才成立。若负责人只负责分发模糊任务，没人维护整体模型，团队会退化为十支手术刀同时下刀。AI 不能填补缺席的设计权威；它只能放大现有的权威、规则与盲点。</p><p>现代版本也不应复制单一专家的所有缺陷。概念权威可以集中，证据与质疑必须分散：安全 Agent 可以挑战主方案，测试 Agent 可以生成反例，领域专家可以否决错误假设，重大决策仍通过团队评审。最好的结构不是“一个人永远正确”，而是“一条设计主线清晰，同时允许有组织的反证”。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-02-digital-surgical-team.webp?v=d56a31a4cdf1e66a" width="1672" height="941" loading="lazy" alt="Digital Surgical Team 架构图：人类 Tech Lead 位于概念完整性与最终责任中心，连接 Research、Implementation、Test、Security、Documentation 五类 Agent，所有产出汇入统一验证与合并门"><figcaption><p><strong>图 2 · Digital Surgical Team</strong>　人类 Tech Lead 保持概念完整性并承担最终责任，五类专业 Agent 提供研究、实现、测试、安全与文档能力；所有输出统一经过 Validation &amp; Merge Gate，形成可审阅的有效变更。</p></figcaption></figure><h2 id="概念完整性：AI-时代最稀缺的竞争力"><span class="section-no">07</span><a href="#概念完整性：AI-时代最稀缺的竞争力" class="headerlink" title="概念完整性：AI 时代最稀缺的竞争力"></a>概念完整性：AI 时代最稀缺的竞争力</h2><p>Brooks 把概念完整性视为系统设计最重要的品质。用户不关心组织图上有多少团队；他们感知的是同一个系统是否遵循一套可以预测的概念：相同的词是否指向相同的事物，相似操作是否有相似行为，错误是否以一致方式出现，权限与数据生命周期是否遵守同一原则。</p><p>概念完整性并不等于代码风格统一。格式化工具能统一缩进，却不能决定“客户”与“账户”是否是同一个边界概念；框架能统一控制器写法，却不能决定库存扣减发生在下单、付款还是出库。真正的完整性存在于语义和取舍中。</p><p>AI 会把这种差异放大。面对一个命名清晰、模块边界稳定、测试表达业务不变量的仓库，Agent 可以从大量一致例子中归纳正确模式；面对十年历史中并存五套架构的仓库，它无法知道哪一套代表未来。模型通常会选择局部最像的答案，于是历史偶然被复制为新规范。</p><p>这也是为什么领域驱动设计、架构决策记录（ADR）、C4 模型和演进式架构在 AI 时代重新重要。<sup class="ref"><a href="#ref-12">[12]</a></sup><sup class="ref"><a href="#ref-16">[16]</a></sup><sup class="ref"><a href="#ref-17">[17]</a></sup> 它们的共同作用，是把“我们为什么这样设计”变成可检索、可评审、可追踪的组织记忆。它们不是为了给模型喂更多文字，而是为了让人和模型共享同一套少而稳定的概念。</p><div class="callout"><p><strong>概念完整性可以被理解为一种语义压缩。</strong> 当少量原则能够解释大量局部决策，系统就容易学习和预测；当每个文件都需要单独解释，系统已经失去可压缩性。AI 最擅长放大前一种系统，也最容易在后一种系统中制造“看起来合理”的偏差。</p></div><h2 id="文档假说：未来的核心仓库是知识仓库"><span class="section-no">08</span><a href="#文档假说：未来的核心仓库是知识仓库" class="headerlink" title="文档假说：未来的核心仓库是知识仓库"></a>文档假说：未来的核心仓库是知识仓库</h2><p>Brooks 在“文档假说”中主张，项目需要少量关键文档来表达目标、约束、组织、预算、进度与接口。重点从来不是“文档越多越好”，而是用一组权威对象保持共同现实。在 AI 时代，这一原则比“代码即文档”更可靠。</p><p>当代码主要由人书写时，熟练开发者还可能从命名、提交历史和实现细节中还原意图；当大量代码由 Agent 快速生成，代码更像决策的沉积物，未必携带足够的理由。一个实现通过了当前测试，不代表后来者知道哪些行为是业务承诺，哪些只是临时选择，哪些变动需要迁移数据或通知客户。</p><p>真正有用的知识仓库至少包含六类内容：业务词汇与关键场景，系统地图与所有权，架构原则与 ADR，接口和数据契约，构建测试发布方法，以及事故、回滚和安全边界。提示词、Skill、项目规则、检索索引与 Agent Memory 可以成为访问层，但不能取代这些事实本身。</p><p>文档还必须具备生命周期。没有负责人、没有版本、无法被测试、与代码一起过期的文档，只会给 Agent 提供更有说服力的错误上下文。高质量做法是：权威来源唯一；决策与变更关联；契约尽可能机器校验；示例来自真实测试；过期内容有检测与删除机制。</p><div class="table-wrap"><table><caption>从 Code Repository 到 Knowledge Repository</caption><thead><tr><th>知识层</th><th>回答的问题</th><th>推荐载体</th><th>验证方式</th></tr></thead><tbody><tr><td>意图</td><td>为什么做、为谁创造价值</td><td>业务目标、场景、指标</td><td>用户反馈与结果指标</td></tr><tr><td>概念</td><td>系统中的词意味着什么</td><td>领域词汇、边界上下文</td><td>跨团队术语评审</td></tr><tr><td>决策</td><td>为何选择此方案</td><td>ADR、风险与替代方案</td><td>变更关联与定期复审</td></tr><tr><td>契约</td><td>什么行为不可破坏</td><td>Schema、API、策略、不变量</td><td>契约测试与静态规则</td></tr><tr><td>操作</td><td>如何构建、发布、恢复</td><td>Runbook、自动化脚本</td><td>演练与可观测性</td></tr><tr><td>Agent 层</td><td>如何让智能体正确行动</td><td>指令、Skill、工具权限、Memory</td><td>评测、轨迹审计、人工审批</td></tr></tbody></table></div><h2 id="巴别塔为何失败：共享语言仍是系统基础设施"><span class="section-no">09</span><a href="#巴别塔为何失败：共享语言仍是系统基础设施" class="headerlink" title="巴别塔为何失败：共享语言仍是系统基础设施"></a>巴别塔为何失败：共享语言仍是系统基础设施</h2><p>《人月神话》用巴别塔讨论沟通失败：项目并不只是因为技术困难而失败，也会因为参与者不再共享同一种语言和同一幅系统图景而失败。人数增加时，潜在沟通关系近似按平方增长；层级、模块与接口的意义，本就是为了减少必须发生的全连接沟通。</p><p>Agent 看似没有会议疲劳，却有另一种巴别塔问题。一个 Agent 读取产品文档，一个读取代码，一个只拿到任务描述；它们对“完成”的定义可能不同。上下文窗口再大，也不会自动解决来源冲突、时效性和权威性。Memory 甚至可能把旧判断稳定地带入新任务，让错误更连贯。</p><p>Model Context Protocol（MCP）与 Agent2Agent（A2A）等开放协议，分别尝试标准化模型连接外部工具/数据以及 Agent 之间的互操作。<sup class="ref"><a href="#ref-28">[28]</a></sup><sup class="ref"><a href="#ref-29">[29]</a></sup> 它们很重要，但协议只解决“能否交换”，不保证“交换内容的语义一致”。HTTP 让服务可以通信，并没有消除分布式系统中的契约错误；同样，Agent 能互相调用，并不代表它们拥有共享理解。</p><p>因此，上下文工程首先是信息架构，而不是把更多文本塞进窗口。需要明确来源优先级、时间戳、适用范围、版本和冲突处理；在交接时传递决策摘要、未决问题、证据与验证状态，而不只是全部聊天记录。共享语言必须被设计。</p><h2 id="第二系统效应：当功能的价格趋近于零"><span class="section-no">10</span><a href="#第二系统效应：当功能的价格趋近于零" class="headerlink" title="第二系统效应：当功能的价格趋近于零"></a>第二系统效应：当功能的价格趋近于零</h2><p>Brooks 观察到，设计第二个系统时，人们容易把第一个系统中被克制的所有想法一次性加入，结果得到臃肿、过度设计的作品。AI 让这种诱惑更强：过去因为开发昂贵而被否决的功能，现在几小时就能出现原型；过去需要慎重引入的抽象，现在一句“让它更通用”就会生成。</p><p>问题在于，生成功能的成本和拥有功能的成本不是同一个数。每个新增能力都会扩展测试矩阵、权限面、文档、监控、兼容承诺与用户选择。Agent 擅长完成可见的 happy path，但长期成本往往存在于失败路径：旧数据如何迁移，部分成功如何补偿，外部依赖超时如何降级，审计如何解释自动决策。</p><p>Vibe Coding 的风险并不是使用自然语言，而是把“能运行”误当作“可拥有”。原型阶段可以拥抱速度；一旦系统承载真实资金、数据或组织流程，就必须支付生产化税：威胁建模、可观测性、容量、恢复、数据治理和服务等级目标。AI 可以帮助支付这笔税，却不能宣布它不存在。</p><p>对抗第二系统效应，需要把删除能力与新增能力放在同一优先级：设置功能预算，要求每个新概念说明它替代了什么，对依赖和配置设上限，用产品结果而非生成速度判断价值。真正成熟的 AI 工程不是“什么都能做”，而是“知道什么不该生成”。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-03-complexity-rebound-curve.webp?v=06d8c04e09a87aae" width="1672" height="941" loading="lazy" alt="复杂性反弹曲线：随着 AI 自动化程度和生成规模提高，单项实现成本下降，功能数量、依赖数量和验证负担上升；缺乏约束时总拥有成本越过拐点后反弹，有约束时则保持较低水平"><figcaption><p><strong>图 3 · 复杂性反弹曲线</strong>　AI 降低单项实现成本，却同时刺激功能供给、依赖规模与验证负担增长。架构约束和验证能力不足时，局部效率红利会在复杂性拐点之后转化为总拥有成本反弹。</p></figcaption></figure><h2 id="Plan-to-Throw-One-Away：从“大重写”到可替换实验"><span class="section-no">11</span><a href="#Plan-to-Throw-One-Away：从“大重写”到可替换实验" class="headerlink" title="Plan to Throw One Away：从“大重写”到可替换实验"></a>Plan to Throw One Away：从“大重写”到可替换实验</h2><p>“准备抛弃一个版本”常被当作重写的浪漫口号。它原本提醒人们：在真正理解问题之前，第一个设计往往只是学习工具。AI 的确让探索性实现变便宜：团队可以快速比较数据模型、API 形态或迁移路径，以代码而非幻灯片暴露未知。</p><p>但 Brooks 在二十周年版中也反思了这一说法。他更认可渐进构建：系统在持续反馈中生长，而不是先制造一个完整废品，再整体替换。这个修正对今天尤其重要。AI 降低的是重新生成的成本，不是替换生产系统的成本。真实系统包含数据、客户行为、外部集成、审计记录和运维经验，这些都不能被一次 prompt 重新生成。</p><p>所以，现代工程策略应是“让实验可丢弃，让资产可迁移”。把高不确定部分隔离为 spike、沙箱或影子实现；在进入主干之前明确学习目标；通过契约测试保护外部行为；让数据库迁移可回滚；用绞杀者模式逐步替换旧能力。若一个原型意外成为生产系统，必须补做所有权和生产化审查，而不是因为它运行过一次就默认继承。</p><p>AI 还提供了另一种可能：同一需求生成多个候选方案，用评测和基准选择，而不是对第一份流畅输出产生情感依附。此时“抛弃一个”不再是失败，而是搜索过程的正常成本。不过，评测标准必须先于候选方案建立，否则我们只是从多个无法解释的答案中选择最顺眼的一个。</p><h2 id="No-Silver-Bullet：银弹神话为何总会回来"><span class="section-no">12</span><a href="#No-Silver-Bullet：银弹神话为何总会回来" class="headerlink" title="No Silver Bullet：银弹神话为何总会回来"></a>No Silver Bullet：银弹神话为何总会回来</h2><p>每一代软件技术都会短暂扮演银弹：第四代语言、面向对象、组件、低代码、微服务、云原生，如今是大模型。它们都产生了真实价值，也都在扩大应用边界后遇到新的复杂性。银弹神话反复出现，是因为人们倾向于把局部生产效率外推为系统交付效率。</p><p>AI 的特殊之处在于，它同时作用于多个阶段：需求表述、设计探索、编码、测试、运维与知识检索。它可能比过去任何单一工具影响更广。然而影响广仍不等于不受约束。只要软件需要映射一个不断变化的现实世界，模型就必须面对不完整需求、相互冲突的目标、组织权力与未知未来。</p><p>“没有银弹”也不应成为保守主义借口。Brooks 并没有说工具无用；他的判断是没有单项技术承诺在十年内把软件生产率、可靠性和简单性提高一个数量级。<sup class="ref"><a href="#ref-2">[2]</a></sup> 工程师应同时持有两种态度：积极利用 AI 消除重复劳动，严格拒绝把演示速度当成全生命周期证据。</p><p>真正可持续的提升往往来自组合：更小的系统边界、更清晰的领域模型、更短的反馈、更好的工具、更自动的验证、更安全的发布以及更健康的组织结构。AI 可以强化这套组合，但无法代替组合本身。</p><div class="table-wrap"><table><caption>Brooks 章节与 AI 时代问题的对应关系</caption><thead><tr><th>Brooks 的命题</th><th>AI 时代的对应问题</th><th>需要守住的原则</th></tr></thead><tbody><tr><td>The Tar Pit</td><td>生成容易，生产化与维护仍困难</td><td>以全生命周期而非 demo 衡量完成</td></tr><tr><td>The Mythical Man-Month</td><td>更多 Agent 带来上下文与集成税</td><td>先分解、再并行</td></tr><tr><td>The Surgical Team</td><td>一个负责人协调专门 Agent</td><td>概念权威集中，证据与反证分散</td></tr><tr><td>Aristocracy, Democracy…</td><td>设计主线与团队参与如何平衡</td><td>决策过程开放，最终语义一致</td></tr><tr><td>Second-System Effect</td><td>低成本生成功能导致范围爆炸</td><td>复杂性预算和删除机制</td></tr><tr><td>Passing the Word</td><td>规则、Skill、Memory 如何传递</td><td>权威来源、版本和适用范围</td></tr><tr><td>Why Did the Tower of Babel Fail?</td><td>多 Agent 上下文碎片化</td><td>共享语言与结构化交接</td></tr><tr><td>Calling the Shot</td><td>Agent 任务时长与成功率难估</td><td>历史数据、分位数和置信度</td></tr><tr><td>Ten Pounds in a Five-Pound Sack</td><td>上下文、算力、延迟和成本预算</td><td>选择信息，不迷信无限上下文</td></tr><tr><td>The Documentary Hypothesis</td><td>知识仓库成为生成控制面</td><td>少量、高信号、可验证文档</td></tr><tr><td>Plan to Throw One Away</td><td>快速生成多个实验实现</td><td>实验可丢弃，数据与契约可迁移</td></tr><tr><td>Sharp Tools</td><td>模型、MCP、沙箱、CI 工具链</td><td>最小权限、可复现、可审计</td></tr><tr><td>The Whole and the Parts</td><td>局部测试通过但系统行为错误</td><td>单元、契约、端到端与评测分层</td></tr><tr><td>Hatching a Catastrophe</td><td>大量小偏差在集成末期爆发</td><td>小批量、在制品限制和领先信号</td></tr><tr><td>The Other Face</td><td>AI 生成界面与解释影响用户信任</td><td>把可理解性视为产品契约</td></tr><tr><td>No Silver Bullet</td><td>把模型能力误当系统能力</td><td>区分任务基准、团队吞吐与业务结果</td></tr></tbody></table></div><p class="part-label">第三部分 · 从 AI Coding 到 Agent Engineering</p><h2 id="从代码资产到知识资产"><span class="section-no">13</span><a href="#从代码资产到知识资产" class="headerlink" title="从代码资产到知识资产"></a>从代码资产到知识资产</h2><p>传统软件组织把源代码视为核心资产，这是合理的，因为代码是机器执行的最终权威。但在 AI 生成能力普及后，代码的经济属性开始改变：许多实现可以根据规格、契约和示例重新生成。于是代码的一部分更像“编译结果”或“缓存”——重要、必须受控，却不再完整代表组织最稀缺的知识。</p><p>这里必须避免另一个夸张结论：代码绝不会变成可以随意删除的临时文件。生产代码承载经过验证的边界条件、性能优化、合规证据和事故修复；如果生成它的知识并不完整，代码本身就是唯一事实。所谓“代码像缓存”，是一种方向性判断：当规格和验证足够强时，更多实现细节将可再生；不是说今天已经可以抛弃源码。</p><p>未来更有价值的资产，是生成与判断背后的知识：领域模型、约束、策略、决策记录、评测集、失败案例、运维经验、工具能力和权限模型。它们决定 Agent 能产生什么，也决定哪些产出不得进入生产。TOGAF 所说的 Architecture Repository、DDD 的领域知识、SRE 的运行手册，在这里汇成同一个控制面。</p><p>知识资产与代码资产还有一个根本差异：知识不能只靠“存储”产生价值。它需要出处、责任人、适用边界、刷新周期和冲突解决。向量数据库可以找回一段文字，却不能判断它是否仍然代表组织决策。知识工程的核心不是检索率，而是治理事实。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-04-software-asset-center-migration.webp?v=4a2fe93eed894943" width="1672" height="941" loading="lazy" alt="软件资产重心迁移双轴图：以可再生性为横轴、治理价值为纵轴，资产从 Source Code 依次迁移到 Framework、Platform、Knowledge、Skill、Memory 和 Architecture Repository"><figcaption><p><strong>图 4 · 软件资产重心迁移</strong>　随着实现的可再生性提高，软件资产重心从代码、框架和平台，逐步上移到知识、Skill、Memory 与 Architecture Repository；后者通过版本化决策、约束和策略形成组织级治理控制面。</p></figcaption></figure><h2 id="Agent-Engineering：从提示词走向运行系统"><span class="section-no">14</span><a href="#Agent-Engineering：从提示词走向运行系统" class="headerlink" title="Agent Engineering：从提示词走向运行系统"></a>Agent Engineering：从提示词走向运行系统</h2><p>Prompt Engineering 关注单次输入如何获得更好的输出；Context Engineering 关注在正确时刻给模型提供正确的信息；Loop Engineering 进一步处理模型如何使用工具、观察结果、纠错与终止；Agent Engineering 则把模型放进一个可运行、可观测、可治理的系统。最后，Knowledge Engineering 负责这个系统所依赖事实的生产与生命周期。</p><p>这几个阶段不是相互替代，而是逐层包含。好的提示无法弥补错误数据；好的上下文无法弥补无边界工具权限；好的循环无法弥补错误目标；好的 Agent 架构也无法弥补组织没有权威知识源。工程成熟度越高，关注点越从“模型说了什么”转向“系统在什么条件下允许它做什么，以及如何证明结果”。</p><p>OpenAI 的 Agent 构建指南把模型、工具和指令视为基础，并区分单 Agent 与多 Agent 编排，同时强调 guardrails。Agents SDK 又把工具调用、handoff、会话、人工介入与 tracing 纳入运行时；轨迹可记录模型生成、工具调用、交接和防护事件。<sup class="ref"><a href="#ref-26">[26]</a></sup><sup class="ref"><a href="#ref-27">[27]</a></sup> Anthropic 对 Agent 的经验则强调从简单、可组合模式开始，只有在任务价值需要时才增加自主性和复杂度。<sup class="ref"><a href="#ref-30">[30]</a></sup></p><p>这些实践与 Brooks 的思想高度一致：少量清晰构件优于华丽框架；组织和接口比人数更重要；系统必须保留一条可理解的控制主线。所谓 Agent Engineering，不是把更多模型接在一起，而是设计一个能够安全委派、发现偏差、保留证据并在必要时停下来的执行组织。</p><div class="table-wrap"><table><caption>从 Prompt 到 Knowledge 的五层工程对象</caption><thead><tr><th>层次</th><th>核心问题</th><th>主要产物</th><th>典型失败</th></tr></thead><tbody><tr><td>Prompt</td><td>如何表达当前任务</td><td>目标、约束、输出格式</td><td>指令含糊、验收缺失</td></tr><tr><td>Context</td><td>需要哪些事实</td><td>检索、项目地图、状态摘要</td><td>信息过期、冲突、噪声过多</td></tr><tr><td>Loop</td><td>如何观察、行动与终止</td><td>工具调用、重试、预算、停止条件</td><td>死循环、过度调用、错误累积</td></tr><tr><td>Agent</td><td>如何委派与承担流程</td><td>角色、权限、handoff、guardrail、trace</td><td>责任模糊、越权、不可审计</td></tr><tr><td>Knowledge</td><td>事实如何产生与更新</td><td>领域模型、ADR、契约、评测集、Memory</td><td>知识腐化、来源不明、旧规则固化</td></tr></tbody></table></div><h2 id="多-Agent-不是免费并行，而是一种新组织设计"><span class="section-no">15</span><a href="#多-Agent-不是免费并行，而是一种新组织设计" class="headerlink" title="多 Agent 不是免费并行，而是一种新组织设计"></a>多 Agent 不是免费并行，而是一种新组织设计</h2><p>把 Agent 数量当成云实例数量，是最危险的类比之一。计算任务只要无共享状态就容易横向扩展，软件任务却经常围绕共享概念和共享文件。多 Agent 的价值存在于真正可分解的工作：独立模块、不同证据源、互不覆盖的验证角色，或可以通过明确契约重新组合的候选结果。</p><p>当任务高度耦合时，增加 Agent 会引入四种税。第一是分解税：人必须把问题切成可独立完成的单元。第二是上下文税：每个 Agent 都要获得足够而不矛盾的信息。第三是协调税：依赖、顺序和变更需要被调度。第四是验证税：所有局部结果最终必须在系统层面证明相容。</p><p>多 Agent 架构通常有两类基本形态。Manager 模式由一个中心 Agent 保留控制，调用专家 Agent 作为工具；handoff 模式把控制权交给新的专家。前者有利于保持主线，后者有利于长流程中的专业自治。没有一种形态普遍更好，选择取决于谁拥有最终上下文、错误是否可逆、交接是否需要用户参与。</p><p>最实用的原则仍然来自排队论和持续交付：限制在制品，缩短批量，尽早集成。与其同时启动二十个任务后在末尾处理冲突，不如维持少量高价值并行流，让每个变更持续通过构建、测试和契约门。Agent 速度越快，越需要 WIP 限制，否则验证队列会成为新的晚期项目。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-05-multi-agent-throughput-model.webp?v=1f6b1051b1111f4a" width="1672" height="941" loading="lazy" alt="多 Agent 吞吐模型：低耦合任务具有正并行收益，随着任务耦合度提高，分解税、上下文税、协调税和验证税持续增加，净边际吞吐收益穿过零收益线后转为负值"><figcaption><p><strong>图 5 · 多 Agent 吞吐模型</strong>　净吞吐收益并不等于 Agent 数量带来的理论并行收益，还必须扣除分解、上下文、协调和验证成本。任务耦合度越高，这些税负增长越快，边际收益最终可能转负。</p></figcaption></figure><h2 id="架构必须从“建议”变成可执行治理"><span class="section-no">16</span><a href="#架构必须从“建议”变成可执行治理" class="headerlink" title="架构必须从“建议”变成可执行治理"></a>架构必须从“建议”变成可执行治理</h2><p>过去的架构文档主要服务于人的阅读。Agent 加入后，架构原则还必须在执行路径上发挥作用。仅写“保持模块解耦”太抽象；更有效的表达是：哪些模块可以依赖哪些模块，哪些数据只能由哪个服务写入，哪些 API 需要幂等键，哪些目录不允许自动修改，哪些变更必须由安全负责人批准。</p><p>这意味着架构需要双重表示。一层是面向人的意图：原则、模型、权衡和例外理由；另一层是面向机器的约束：类型、Schema、静态分析规则、策略即代码、测试、CI 门禁、权限清单和部署检查。前者没有后者会沦为愿望，后者没有前者会成为无人理解的禁令。</p><p>Architecture Guardian 不应只是另一个会写评论的 Agent，而应是一套分层控制。低风险规则自动执行，中风险偏差要求解释，高风险动作需要人工批准；所有例外留下时限和责任人。Agent 的工具采用最小权限，读取和写入分离，生产操作默认不可逆时停下，运行轨迹可审计，敏感上下文有明确边界。</p><p>测试在这里也需要升级为评测。确定性代码可以用输入输出断言；包含模型的系统还要评估任务成功、工具选择、事实性、安全、成本、延迟与退化。评测集应来自真实失败和关键业务场景，并持续防止“模型升级后指标更好、业务边界却悄悄变化”。</p><div class="principles"><div class="principle"><strong>01 · 约束可定位</strong> — 每条规则说明来源、适用目录或系统边界，不把全局口号强加给所有任务。</div><div class="principle"><strong>02 · 证据可复现</strong> — Agent 交付的不只是补丁，还包括验证命令、输出摘要和未验证风险。</div><div class="principle"><strong>03 · 权限可收敛</strong> — 默认只授予完成任务所需的最小工具、网络、文件和环境权限。</div><div class="principle"><strong>04 · 例外可过期</strong> — 任何绕过门禁的决定都有责任人、原因、复审日期和自动提醒。</div><div class="principle"><strong>05 · 变更可回退</strong> — 把回滚、补偿和数据恢复设计为完成条件，而不是事故发生后的补丁。</div><div class="principle"><strong>06 · 轨迹可审计</strong> — 记录关键上下文、工具调用、审批和结果，同时避免无边界保存敏感内容。</div></div><h2 id="重新衡量生产力：代码更多，不等于价值更快"><span class="section-no">17</span><a href="#重新衡量生产力：代码更多，不等于价值更快" class="headerlink" title="重新衡量生产力：代码更多，不等于价值更快"></a>重新衡量生产力：代码更多，不等于价值更快</h2><p>AI 时代最糟糕的管理反应，是用代码行、提交数或 Agent 完成任务数证明投资回报。SPACE 框架早已提醒，开发者生产力至少涉及满意度与福祉、绩效、活动、沟通协作以及效率与流，不能由单一指标替代。<sup class="ref"><a href="#ref-21">[21]</a></sup> 当生成成本下降，活动指标与真实价值之间的距离只会更大。</p><p>经验数据也要求克制。METR 在 2025 年对 16 位熟悉成熟开源项目的开发者进行随机对照试验，共覆盖 246 个真实任务；在特定的早期 2025 工具和研究条件下，允许使用 AI 的组平均完成时间反而增加约 19%。研究者明确把它视为特定人群、工具和时间点的快照，而非 AI 永远降低效率的结论。<sup class="ref"><a href="#ref-32">[32]</a></sup> 它最重要的启示，是主观“感觉更快”不能代替测量。</p><p>另一边，2025 DORA 报告把成功采用 AI 描述为系统问题，而不是单纯工具问题，并强调价值流管理让局部提升转化为产品绩效。<sup class="ref"><a href="#ref-31">[31]</a></sup> 这正是 Brooks 视角：局部程序员效率不是项目吞吐，项目吞吐也不是业务结果。组织的架构、平台、流程与文化会调节工具效果。</p><p>一个可靠的度量组合应同时观察四层：任务层看完成时间、返工和评测通过率；工程系统层看变更前置时间、部署频率、失败率和恢复时间；团队层看认知负荷、审阅队列与知识扩散；业务层看用户结果、风险和总成本。还要区分绿地与遗留系统、熟悉与陌生代码库、短任务与长任务，不把平均值当作普遍规律。</p><div class="callout"><p><strong>建议的核心指标：</strong> 从“Agent 生成了多少”转向“一个经过验证、可回退、可维护的业务变更从提出到生效需要多久”。前者奖励库存，后者关注价值流。</p></div><h2 id="人的新位置：从代码作者到意图、边界与责任的设计者"><span class="section-no">18</span><a href="#人的新位置：从代码作者到意图、边界与责任的设计者" class="headerlink" title="人的新位置：从代码作者到意图、边界与责任的设计者"></a>人的新位置：从代码作者到意图、边界与责任的设计者</h2><p>“AI 放大架构师，而不是程序员”是一个有力量但不够准确的判断。优秀程序员从来不只是打字者，他们在代码层发现需求矛盾、性能边界和失败模式。AI 改变的不是“程序员消失、架构师胜利”，而是所有软件角色都要向更高杠杆的判断移动。</p><p>未来工程师的核心能力包括：把模糊问题转成可验证假设；识别领域边界和不变量；设计适合委派的任务；构造能够揭示错误的评测；理解安全、数据与运行后果；在模型给出流畅答案时保持反证意识。阅读和审阅的重要性可能超过亲手输入每一行代码。</p><p>架构师也不能退化为写规则的人。架构是一组持续被代码、指标和事故检验的决策。真正的架构工作需要进入价值流：观察 Agent 在哪里误解系统，哪些规则经常被绕过，哪些边界制造不必要协调，再据此简化系统。维护 AI 行为边界，与维护软件边界是同一件事。</p><p>责任尤其不能外包。Agent 可以提出迁移方案，批准停机窗口的人仍需理解风险；Agent 可以生成权限策略，签署合规责任的人仍需知道谁能访问数据。组织必须防止“模型建议”成为无人负责的被动语态。每一个不可逆决定，都应能回答：谁授权、依据什么、如何监控、如何撤销。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-06-human-work-center-migration.webp?v=749928c29b20ca62" width="1672" height="941" loading="lazy" alt="人的工作重心迁移：随着生成自动化程度提高，人类时间从 Typing 逐步转向 Reviewing、Framing、Governing 与 Learning；五类工作持续存在，表示重心迁移而非角色替代"><figcaption><p><strong>图 6 · 人的工作重心迁移</strong>　生成自动化提高后，Typing 仍然存在，但人类时间更多流向 Reviewing、Framing、Governing 与 Learning。变化的不是角色被逐层删除，而是判断、治理与反馈学习获得更高权重。</p></figcaption></figure><p class="part-label">第四部分 · 面向组织的工程路线</p><h2 id="从个人提效到组织能力：一条可落地的路径"><span class="section-no">19</span><a href="#从个人提效到组织能力：一条可落地的路径" class="headerlink" title="从个人提效到组织能力：一条可落地的路径"></a>从个人提效到组织能力：一条可落地的路径</h2><p>组织采用 Coding Agent，最常见的错误是先购买席位，再等待生产率自然出现。个人可以在没有治理的情况下获得局部收益，组织规模化却需要先建立可吸收能力。下面的路径并非成熟度认证，而是一种降低风险的实施顺序。</p><h3 id="阶段一：选择边界清楚、可验证的任务"><a href="#阶段一：选择边界清楚、可验证的任务" class="headerlink" title="阶段一：选择边界清楚、可验证的任务"></a>阶段一：选择边界清楚、可验证的任务</h3><p>从测试补充、文档同步、依赖升级、静态分析修复、内部脚手架等任务开始。每类任务必须有明确验收、稳定构建和回滚方式。记录基线时间与返工，不只收集主观满意度。高风险生产操作、关键权限与不可逆数据迁移暂不自治。</p><h3 id="阶段二：修复知识入口与工程反馈"><a href="#阶段二：修复知识入口与工程反馈" class="headerlink" title="阶段二：修复知识入口与工程反馈"></a>阶段二：修复知识入口与工程反馈</h3><p>为仓库建立一页式系统地图：如何构建、测试、运行，主要模块和所有权，关键约束与禁止事项。清理失效文档，补上高价值测试，缩短 CI 时间。Agent 不是绕过工程健康的捷径；脆弱测试和缓慢反馈会直接限制它的有效循环次数。</p><h3 id="阶段三：把架构规则机器化"><a href="#阶段三：把架构规则机器化" class="headerlink" title="阶段三：把架构规则机器化"></a>阶段三：把架构规则机器化</h3><p>选择最昂贵的三到五类偏差，例如跨层依赖、越权数据访问、API 不兼容、缺少迁移或敏感信息泄漏，把它们变为静态规则、契约测试或策略门禁。规则数量宁少勿滥，并为例外提供正式流程。</p><h3 id="阶段四：建立风险分级委派"><a href="#阶段四：建立风险分级委派" class="headerlink" title="阶段四：建立风险分级委派"></a>阶段四：建立风险分级委派</h3><p>按可逆性、数据敏感性、爆炸半径和用户影响分级。低风险变更可以自动生成并自动验证，中风险需要指定评审，高风险只允许 Agent 调研和提出方案。所有级别都保留轨迹与产物来源；权限随任务临时授予，而非永久开放。</p><h3 id="阶段五：再引入多-Agent-与长任务"><a href="#阶段五：再引入多-Agent-与长任务" class="headerlink" title="阶段五：再引入多 Agent 与长任务"></a>阶段五：再引入多 Agent 与长任务</h3><p>只有当单 Agent 流程的失败模式已被理解，才通过 Manager 或 handoff 引入专业分工。为交接定义结构化包：目标、当前状态、证据、修改范围、未决风险与下一步。限制在制品，给长任务设置预算、检查点和停止条件。</p><h3 id="阶段六：用事故和评测更新知识"><a href="#阶段六：用事故和评测更新知识" class="headerlink" title="阶段六：用事故和评测更新知识"></a>阶段六：用事故和评测更新知识</h3><p>把每次误生成、漏检、错误工具调用和人工接管转化为评测用例或更清晰的约束。定期删除无效规则和旧 Memory。成熟组织的优势不是从不出错，而是每次错误都让控制面更精确，而不是只让提示词更长。</p><div class="table-wrap"><table><caption>Agent 工程运行检查表</caption><thead><tr><th>层面</th><th>上线前必须回答</th><th>最小证据</th></tr></thead><tbody><tr><td>目标</td><td>任务的完成和不完成分别是什么</td><td>可执行验收条件</td></tr><tr><td>上下文</td><td>事实来自哪里，冲突以谁为准</td><td>来源、版本、时间戳</td></tr><tr><td>工具</td><td>Agent 可以读写什么，能否产生外部副作用</td><td>权限清单与沙箱策略</td></tr><tr><td>验证</td><td>谁证明局部与系统行为都正确</td><td>测试、评测、扫描与人工审阅</td></tr><tr><td>运行</td><td>超时、循环、部分失败如何处理</td><td>预算、重试、停止与补偿策略</td></tr><tr><td>责任</td><td>谁批准不可逆动作，谁接管异常</td><td>审批人与升级路径</td></tr><tr><td>学习</td><td>失败如何回流到知识和评测</td><td>复盘、用例和规则版本记录</td></tr></tbody></table></div><h2 id="软件工程下一站：管理可生成系统"><span class="section-no">20</span><a href="#软件工程下一站：管理可生成系统" class="headerlink" title="软件工程下一站：管理可生成系统"></a>软件工程下一站：管理可生成系统</h2><p>软件工程的下一站，不是“人人不再写代码”，而是越来越多系统同时包含确定性软件、概率性模型和能够采取行动的 Agent。它们的边界会比传统应用更动态：同一目标可能产生不同路径，工具和数据实时变化，长期 Memory 又把过去带入现在。工程的任务从管理静态制品，扩展为管理可生成行为。</p><p>第一项变化是<strong>规格重新成为一等资产</strong>。但这不是回到瀑布式大文档，而是建立可演进、可测试的意图：场景、契约、不变量、策略和评测。规格与实现之间的反馈会更短，二者甚至可以互相生成，但人必须保留对语义的裁决。</p><p>第二项变化是<strong>软件供应链扩展为知识供应链</strong>。组织不仅要追踪依赖包来自哪里，还要追踪 Agent 使用了哪些模型、指令、工具、知识源与评测版本。错误可能不在代码提交中，而在一次过期检索、一条被污染的 Memory 或一次权限配置变更中。</p><p>第三项变化是<strong>架构从结构设计扩展到行为治理</strong>。过去的图主要回答组件如何连接；未来还要回答谁可以代表谁行动、哪类决定必须征求批准、系统如何解释自己的证据、何时必须停止自治。这会让安全、合规、SRE、产品和架构更早汇合。</p><p>第四项变化是<strong>源代码不再是唯一的人机边界</strong>。自然语言、Schema、Policy、Skill、评测集与操作轨迹共同定义系统。工程团队需要像审查代码一样审查这些对象：版本化、测试、评审、发布和回滚。Prompt Review、Skill Review、Memory Review 不是 Code Review 的替代，而是新的审查面。</p><p>第五项变化是<strong>竞争优势来自反馈系统，而非某个模型</strong>。基础模型会更新，工具会趋同，真正难复制的是组织如何把领域知识编码为边界，把真实失败转为评测，把运行证据转为改进，再让 Agent 在这些约束内加速。这个闭环越快，AI 越像杠杆；闭环越弱，AI 越像复杂性放大器。</p><figure class="article-figure"><img src="/assets/articles/mythical-man-month-ai-era/figure-07-software-engineering-control-chain.webp?v=0cd96f97b9d686ca" width="1672" height="941" loading="lazy" alt="真正的软件工程控制链：Problem、Intent、Architecture、Knowledge、Agent、Code、Deployment、Evidence、Learning 依次连接，Evidence 反馈校准 Intent、更新 Knowledge 并扩充 Evaluation 评测"><figcaption><p><strong>图 7 · 真正的软件工程控制链</strong>　从 Problem 到 Learning 的主链跨越控制面、执行面和证据学习面；生产运行产生的 Evidence 持续校准 Intent、更新 Knowledge 并扩充评测，使软件工程成为闭环学习系统，而非单向代码生成流水线。</p></figcaption></figure><h3 id="结语：Brooks-没有说错，只是管理对象变了"><a href="#结语：Brooks-没有说错，只是管理对象变了" class="headerlink" title="结语：Brooks 没有说错，只是管理对象变了"></a>结语：Brooks 没有说错，只是管理对象变了</h3><p>1975 年，软件工程的显性问题是如何组织程序员完成前所未有的大系统；2026 年，问题扩展为如何组织人、模型、工具、知识与自动化共同演进系统。过去我们审查提交，未来还要审查 Agent 的上下文与行动轨迹；过去我们管理开发者之间的沟通，未来还要管理 Agent 之间的交接；过去架构约束主要靠人记住，未来它必须同时被人理解、被机器执行。</p><p>不变的是：软件仍然是对现实问题的模型，任何模型都需要取舍；复杂系统仍然需要概念完整性；沟通仍然消耗时间；新增参与者仍然增加协调；快速产出仍然不能替代正确判断；责任仍然必须落在人和组织上。</p><p>变化的是：代码不再是最稀缺的生产要素，知识与验证成为新的瓶颈；原型和候选方案变得便宜，选择与长期拥有变得更重要；架构师的影响力可以通过 Agent 被放大，架构错误也可以以同样速度扩散。</p><p>所以，《人月神话》在 AI 时代最大的启示，不是劝我们怀疑新工具，而是教我们把新工具放回系统。AI 可以让一支好团队更快验证、更快学习、更快交付；也可以让一个边界混乱的组织更快堆积难以解释的代码。决定两者差异的，从来不是生成速度本身，而是我们是否拥有清晰的意图、完整的概念、可靠的反馈和敢于承担后果的人。</p><p>当代码变得廉价，判断就变得昂贵；当智能体变得普遍，软件工程的核心将是设计它们必须服从的现实。</p><section class="references" id="references"><h2 data-no-number="true">参考文献与延伸阅读</h2><p class="note">英文书名与论文名保留原文。产品与研究资料以本文资料更新时间为界；链接均指向作者、出版机构、研究团队或官方项目页面。</p><ol><li id="ref-1">Brooks, Frederick P. Jr. <em>The Mythical Man-Month: Essays on Software Engineering</em>. Addison-Wesley, 1975; Anniversary Edition, 1995.</li><li id="ref-2">Brooks, Frederick P. Jr. “<a href="https://doi.org/10.1109/MC.1987.1663532">No Silver Bullet—Essence and Accidents of Software Engineering</a>.” <em>Computer</em>, 20(4), 1987.</li><li id="ref-3">IBM. “<a href="https://www.ibm.com/history/system-360">The IBM System/360</a>.” IBM History.</li><li id="ref-4">Parnas, David L. “<a href="https://doi.org/10.1145/361598.361623">On the Criteria To Be Used in Decomposing Systems into Modules</a>.” <em>Communications of the ACM</em>, 1972.</li><li id="ref-5">Conway, Melvin E. “<a href="https://www.melconway.com/Home/Committees_Paper.html">How Do Committees Invent?</a>” <em>Datamation</em>, 1968.</li><li id="ref-6">Dijkstra, Edsger W. “<a href="https://www.cs.utexas.edu/~EWD/transcriptions/EWD03xx/EWD340.html">The Humble Programmer</a>.” ACM Turing Lecture, 1972.</li><li id="ref-7">Royce, Winston W. “Managing the Development of Large Software Systems.” Proceedings of IEEE WESCON, 1970.</li><li id="ref-8">Boehm, Barry W. “<a href="https://doi.org/10.1109/2.59">A Spiral Model of Software Development and Enhancement</a>.” <em>Computer</em>, 1988.</li><li id="ref-9">Gamma, Erich, et al. <em>Design Patterns: Elements of Reusable Object-Oriented Software</em>. Addison-Wesley, 1994.</li><li id="ref-10">Beck, Kent, et al. “<a href="https://agilemanifesto.org/">Manifesto for Agile Software Development</a>.” 2001.</li><li id="ref-11">Fowler, Martin. “<a href="https://martinfowler.com/articles/continuousIntegration.html">Continuous Integration</a>.” 2006.</li><li id="ref-12">Evans, Eric. <em>Domain-Driven Design: Tackling Complexity in the Heart of Software</em>. Addison-Wesley, 2003.</li><li id="ref-13">Humble, Jez, and David Farley. <em>Continuous Delivery</em>. Addison-Wesley, 2010.</li><li id="ref-14">Beyer, Betsy, et al., eds. “<a href="https://sre.google/sre-book/table-of-contents/">Site Reliability Engineering</a>.” O’Reilly / Google, 2016.</li><li id="ref-15">Forsgren, Nicole, Jez Humble, and Gene Kim. <em>Accelerate</em>. IT Revolution, 2018.</li><li id="ref-16">Nygard, Michael. “<a href="https://www.cognitect.com/blog/2011/11/15/documenting-architecture-decisions">Documenting Architecture Decisions</a>.” 2011.</li><li id="ref-17">Brown, Simon. “<a href="https://c4model.com/">The C4 Model for Visualising Software Architecture</a>.”</li><li id="ref-18">Ford, Neal, Rebecca Parsons, and Patrick Kua. <em>Building Evolutionary Architectures</em>. O’Reilly, 2017.</li><li id="ref-19">Skelton, Matthew, and Manuel Pais. <em>Team Topologies</em>. IT Revolution, 2019.</li><li id="ref-20">The Open Group. “<a href="https://pubs.opengroup.org/togaf-standard/adm/chap07.html">TOGAF Standard: Architecture Repository</a>.”</li><li id="ref-21">Forsgren, Nicole, et al. “<a href="https://www.microsoft.com/en-us/research/publication/the-space-of-developer-productivity-theres-more-to-it-than-you-think/">The SPACE of Developer Productivity: There’s More to It Than You Think</a>.” <em>ACM Queue</em>, 2021.</li><li id="ref-22">Jimenez, Carlos E., et al. “<a href="https://arxiv.org/abs/2310.06770">SWE-bench: Can Language Models Resolve Real-World GitHub Issues?</a>” 2023.</li><li id="ref-23">NIST. “<a href="https://www.nist.gov/itl/ai-risk-management-framework">AI Risk Management Framework</a>.” 2023.</li><li id="ref-24">OpenAI. “<a href="https://openai.com/index/introducing-codex/">Introducing Codex</a>.” May 2025.</li><li id="ref-25">OpenAI. “<a href="https://openai.com/index/introducing-the-codex-app/">Introducing the Codex App</a>.” February 2026.</li><li id="ref-26">OpenAI. “<a href="https://openai.com/business/guides-and-resources/a-practical-guide-to-building-ai-agents/">A Practical Guide to Building Agents</a>.”</li><li id="ref-27">OpenAI. “<a href="https://openai.github.io/openai-agents-python/">OpenAI Agents SDK Documentation</a>”; see also <a href="https://openai.github.io/openai-agents-python/tracing/">Tracing</a>.</li><li id="ref-28">Anthropic. “<a href="https://www.anthropic.com/news/model-context-protocol">Introducing the Model Context Protocol</a>.” November 2024.</li><li id="ref-29">Google Developers Blog. “<a href="https://developers.googleblog.com/en/a2a-a-new-era-of-agent-interoperability/">Announcing the Agent2Agent Protocol</a>.” April 2025.</li><li id="ref-30">Anthropic. “<a href="https://www.anthropic.com/engineering/building-effective-agents">Building Effective Agents</a>.” December 2024.</li><li id="ref-31">DORA / Google Cloud. “<a href="https://cloud.google.com/resources/content/2025-dora-ai-assisted-software-development-report">2025 State of AI-assisted Software Development Report</a>.” 2025.</li><li id="ref-32">Becker, Joel, et al. “<a href="https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/">Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity</a>.” METR, 2025.</li><li id="ref-33">Anthropic. “<a href="https://www.anthropic.com/engineering/claude-code-best-practices">Claude Code: Best Practices for Agentic Coding</a>.” 2025.</li><li id="ref-34">Fowler, Martin. “<a href="https://martinfowler.com/articles/2025-nature-abstraction.html">The New Nature of Abstraction in Software Development</a>.” 2025.</li><li id="ref-35">Thoughtworks. “<a href="https://www.thoughtworks.com/radar">Technology Radar</a>.” Continuous series.</li><li id="ref-36">Allspaw, John, and Paul Hammond. “<a href="https://www.youtube.com/watch?v=LdOe18KhtT4">10+ Deploys Per Day: Dev and Ops Cooperation at Flickr</a>.” Velocity, 2009.</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/mythical-man-month-ai-era/</id>
    <link href="https://ryu.xin/zh/posts/mythical-man-month-ai-era/"/>
    <published>2026-07-23T16:00:00.000Z</published>
    <summary>从 Brooks 到 Agent Engineering：重读《人月神话》，讨论 AI 时代软件工程五十年的变化与不变。</summary>
    <title>重读《人月神话》：AI 时代的软件工程再思考</title>
    <updated>2026-07-23T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Reliability" scheme="https://ryu.xin/zh/tags/Reliability/"/>
    <category term="SRE" scheme="https://ryu.xin/zh/tags/SRE/"/>
    <content>
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>AI 辅助开发正在把功能实现压缩到分钟级，但生产系统并不只在理想条件下运行。数据库会中断，网络会超时，请求会重复，发布会停在中间状态，操作人员也会犯错。许多 AI 生成的系统因此呈现出同一种反差：功能上完整，运行上天真。</p><p>可靠性不是上线之后再补的一层基础设施，而是一组从需求阶段就必须写清楚的行为：失败如何被发现，影响如何被限制，服务如何降级，数据如何保持可恢复，人如何安全地介入。AI 有能力实现这些机制，但只有人先把失败定义为设计输入，它才更可能交付一个真正适合生产的系统。</p></header><p class="thesis">功能需求说明系统在顺利时应该做什么；可靠性需求说明系统在不顺利时仍然必须守住什么。</p><p class="part-label">第一部分 · 把失败放回设计之中</p><h2 id="功能完整，运行天真"><span class="section-no">01</span><a href="#功能完整，运行天真" class="headerlink" title="功能完整，运行天真"></a>功能完整，运行天真</h2><p class="lead dropcap">过去两年，AI 辅助开发深刻改变了软件构建的速度。过去需要数小时才能完成的接口、数据模型、前端组件和自动化测试，现在往往几分钟就能得到一份相当像样的实现。真正值得警惕的并不是这些代码不能工作，而是它们通常只证明了一件事：在我们预先安排好的正常路径上，它们能够工作。</p><p>生产环境不会长期停留在正常路径。数据库会短暂不可用，第三方接口会在最忙的时候变慢，同一个订单会因为客户端重试被提交两次，发布可能只完成一半，一次看似无害的配置变更也可能绕过所有代码测试。</p><p>于是，评审一个订单创建 API 时，真正有区分度的问题不再只是“请求能否写入数据库”，而是：</p><ul><li>客户端没有收到响应并再次提交时，会不会创建两个订单？</li><li>库存扣减成功、支付调用超时后，系统处于什么状态？</li><li>下游持续变慢时，线程、连接池和队列会不会被耗尽？</li><li>新版本只在部分实例上启动成功时，旧新数据结构能否共存？</li><li>值班人员如何知道故障发生在哪里，又如何安全恢复？</li></ul><p>这些不是“高级优化”，而是功能在真实世界里的另一半。一个系统若只定义成功路径，实际上还没有定义完整。</p><h2 id="可靠性不是几个-9"><span class="section-no">02</span><a href="#可靠性不是几个-9" class="headerlink" title="可靠性不是几个 9"></a>可靠性不是几个 9</h2><p>可用率是可靠性最常见的表达，却不是它的全部。99.9% 告诉我们某个时间窗口内允许多少失败，却没有单独回答：失败是否集中伤害了关键客户，数据有没有损坏，故障能否被快速发现，恢复是否依赖某位熟悉内幕的工程师。</p><p>更实用的观察方式，是同时看四个相互关联的问题：</p><div class="table-wrap"><table><caption>可靠性的四个观察面</caption><thead><tr><th>观察面</th><th>它追问什么</th><th>常见证据</th></tr></thead><tbody><tr><td>可用性</td><td>用户能否在承诺的时间与质量下访问服务</td><td>SLI、SLO、错误预算</td></tr><tr><td>韧性</td><td>局部故障发生时，系统能否继续或降级运行</td><td>故障隔离、限流、冗余、降级测试</td></tr><tr><td>可恢复性</td><td>超出韧性边界后，能否回到已知正确状态</td><td>MTTR、RTO、RPO、恢复演练</td></tr><tr><td>可维护性</td><td>团队能否理解、修改并安全操作系统</td><td>变更失败率、回滚能力、Runbook</td></tr></tbody></table></div><p>在一个简化的可修复系统模型中，可用性常被写成：</p><div class="equation"><p><strong>Availability ≈ MTBF ÷（MTBF + MTTR）</strong>　MTBF 关注故障间隔，MTTR 关注恢复速度。这个近似式最有价值的地方，不是计算一个漂亮数字，而是提醒我们：减少故障和加快恢复同样重要。</p></div><p>Google 的 SRE 实践还强调，可靠性不是无限追求 100%。不同业务流的失败代价不同，工程投入应当服从风险与用户体验，而不是服从“9”越多越好的抽象竞赛。对于部分可用的分布式系统，以成功请求比例观察可用性，也往往比只计算整站停机时间更接近用户实际感受。<sup class="ref"><a href="#ref-1">[1]</a></sup></p><h2 id="失败不是异常，而是输入条件"><span class="section-no">03</span><a href="#失败不是异常，而是输入条件" class="headerlink" title="失败不是异常，而是输入条件"></a>失败不是异常，而是输入条件</h2><p>墨菲定律之所以在工程里经久不衰，不是因为悲观，而是因为它迫使我们诚实面对规模：一件事即使单次发生概率很低，只要组件足够多、运行时间足够长，它终究会进入日常运营。</p><p>磁盘会损坏，进程会崩溃，证书会过期，网络会抖动，云服务会中断，外部接口会改变行为。人的操作也一样不可能永远正确。可靠性设计并不试图把这些事实从世界里删除，而是提前决定它们发生之后的系统行为。</p><div class="pullquote"><p>成熟的系统不是没有失败，而是失败发生时，结果仍然在设计之内。</p></div><p>这个视角会把问题从“如何阻止一切失败”改写为：什么必须继续工作，什么可以暂停，错误能扩散多远，哪些状态可以重建，谁拥有恢复决定。Azure Well-Architected Framework 也把业务要求、韧性、恢复、运行和简单性放在同一组可靠性原则里；它特别要求区分关键路径与可降级组件，并分析故障范围，而不是给所有组件堆上同样的保护。<sup class="ref"><a href="#ref-2">[2]</a></sup></p><p class="part-label">第二部分 · 把可靠性花在真正重要的地方</p><h2 id="先找到不能丢失的业务承诺"><span class="section-no">04</span><a href="#先找到不能丢失的业务承诺" class="headerlink" title="先找到不能丢失的业务承诺"></a>先找到不能丢失的业务承诺</h2><p>并不是所有组件都值得同样级别的保护。商品推荐暂时不可用，用户仍然可以下单；订单创建重复执行一次，却可能带来扣款、库存和客服成本。报表晚到十分钟通常可以接受，交易清算丢失一条记录则可能产生合规与资金风险。</p><p>可靠性的二八法则，不是机械地寻找 20% 的代码，而是识别少数不能被破坏的业务承诺：</p><div class="principles"><div class="principle"><strong>资金</strong> — 哪些失败会造成重复扣款、错误结算或无法对账？</div><div class="principle"><strong>信任</strong> — 哪些失败会让客户无法确认系统究竟做了什么？</div><div class="principle"><strong>合规</strong> — 哪些记录必须完整、可审计、可追溯？</div><div class="principle"><strong>数据</strong> — 哪些状态一旦损坏就无法从其他事实重建？</div><div class="principle"><strong>恢复</strong> — 哪些服务必须在明确时间内恢复，哪些可以延迟或降级？</div></div><p>只有先回答这些问题，冗余、审计、对账、补偿事务、跨区部署和增强监控才有成本依据。Google SRE 用不同数据的重要性说明同一个原则：关键隐私数据和可选体验数据不应被给予相同的存储保证。<sup class="ref"><a href="#ref-1">[1]</a></sup></p><figure class="article-figure"><img src="/assets/articles/reliability-by-design/figure-01-critical-path.webp?v=ca35af683a507aef" width="1672" height="941" loading="lazy" alt="一座由模块和连线组成的软件系统中，砖红色关键业务路径穿过被加固的桥梁、缓冲区和冗余节点，外围路径可以安全断开"><figcaption><p><strong>图 1 · 保护承诺，而不是平均保护组件。</strong> 砖红色路径代表必须守住的业务结果；缓冲、隔离与冗余围绕它部署，外围能力则允许在故障时有控制地降级。</p></figcaption></figure><h2 id="简单、依赖与故障边界"><span class="section-no">05</span><a href="#简单、依赖与故障边界" class="headerlink" title="简单、依赖与故障边界"></a>简单、依赖与故障边界</h2><p>AI 生成架构时很容易把“使用了更多模式”误认为“考虑得更完整”。事件驱动、CQRS、分布式工作流、多级缓存和 Service Mesh 都可能合理，但每新增一个活动部件，也会新增状态、契约、监控和恢复负担。</p><p>简单并不等于把所有东西塞进一个进程。它意味着：只为已经存在的约束引入复杂度，保持关键路径短，让故障模式能够被团队列举和演练。Azure 的可靠性指南同样把“保持简单”列为设计原则，同时提醒过度简化也可能制造单点故障。<sup class="ref"><a href="#ref-2">[2]</a></sup></p><p>依赖则需要被当作故障边界，而不只是集成接口。每接入一个数据库、队列、身份服务、支付网关或 AI API，都应该回答：</p><ul><li>调用多久之后必须放弃等待？</li><li>失败时是降级、排队、读取缓存，还是直接拒绝？</li><li>重试由哪一层负责，最多几次，是否带退避和抖动？</li><li>重复执行有没有副作用，幂等键保存多久？</li><li>延迟升高时，连接池、线程池和上游流量如何被隔离？</li><li>依赖长期不可用时，有没有替代路径或可恢复的积压？</li></ul><div class="callout"><p><strong>重试不是免费的可靠性。</strong> 无上限、无退避、在多层同时发生的重试，会把短暂故障放大成持续过载。Amazon 的工程实践把超时、有上限的重试、指数退避和随机抖动放在一起讨论；对于会产生副作用的调用，还必须先定义幂等语义。<sup class="ref"><a href="#ref-3">[3]</a></sup><sup class="ref"><a href="#ref-4">[4]</a></sup></p></div><p>Stripe 的 API 是一个具体例子：客户端为创建或更新操作提供幂等键，连接中断后便可以安全重试，而服务端用同一个键返回第一次执行的结果。<sup class="ref"><a href="#ref-5">[5]</a></sup> 关键不在于照搬某个字段，而在于把“不确定是否成功”从一次临时异常，变成协议明确处理的状态。</p><p>冗余也需要同样具体。两个共享同一电源、同一网络路径或同一错误配置的实例，并不构成真正独立的保护。有效冗余要说明它抵御哪一种故障、如何检测主路径失效、如何切换、数据怎样保持一致，以及故障解除后怎样回切。</p><h2 id="可靠性也关乎人"><span class="section-no">06</span><a href="#可靠性也关乎人" class="headerlink" title="可靠性也关乎人"></a>可靠性也关乎人</h2><p>严重事故并不只来自代码缺陷。错误配置、误删数据、权限范围过大、发布步骤遗漏和恢复命令使用不当，都可能把一个局部问题变成业务故障。把原因归结为“操作人员不够小心”，通常只是在回避系统为什么允许一次普通失误造成巨大影响。</p><p>好的运行界面和发布系统会主动缩小犯错空间：</p><ul><li>用清晰命名、类型约束和配置校验提前拒绝无效状态；</li><li>采用安全默认值，让高风险操作需要显式升级权限；</li><li>在删除或迁移前展示真实影响范围，而不是只弹出泛化确认框；</li><li>让变更分阶段进入生产，并设置可观测的停止条件；</li><li>让回滚、恢复和审计成为日常路径，而不是事故时临时拼装。</li></ul><p>这里的目标不是让人远离系统，而是让人的判断被用在真正需要判断的地方。自动化应当消除易错的重复步骤，同时保留清晰的控制权、证据和撤销路径。</p><p class="part-label">第三部分 · 从架构进入运行现场</p><h2 id="可靠性是一条闭环，而不是一张图"><span class="section-no">07</span><a href="#可靠性是一条闭环，而不是一张图" class="headerlink" title="可靠性是一条闭环，而不是一张图"></a>可靠性是一条闭环，而不是一张图</h2><p>架构图可以说明冗余和依赖，却不能证明团队真的能发现并恢复故障。一个成熟的可靠性生命周期，至少要形成下面这条闭环：</p><dl class="timeline"><dt>预防</dt><dd>识别关键路径、失败模式和高风险变更。</dd><dt>检测</dt><dd>用面向用户结果的信号发现异常，而不是等待客户投诉。</dd><dt>分析</dt><dd>判断影响范围、当前状态与最可能的触发因素。</dd><dt>隔离</dt><dd>限流、熔断、降级或停止发布，阻止故障继续扩散。</dd><dt>恢复</dt><dd>回滚、切换、重放、补偿或从备份恢复到已知状态。</dd><dt>修复</dt><dd>消除触发因素和允许它扩大影响的系统条件。</dd><dt>学习</dt><dd>通过复盘、演练和可验证行动项更新系统与流程。</dd></dl><p>这条链上任何一环缺失，可靠性都可能停留在纸面。没有检测，恢复能力不会及时启动；没有隔离，局部故障会在调查期间继续扩散；没有演练，Runbook 很可能只描述了一个从未被验证的愿望；没有行动项的复盘，则只是保存了一次事故故事。</p><p>Google 的事故响应实践强调提前建立指挥角色、记录调试与缓解过程，并定期演练；其复盘指南则要求用事实解释影响、恢复和根因，把行动项落实到明确负责人和可验证的结束状态。<sup class="ref"><a href="#ref-6">[6]</a></sup><sup class="ref"><a href="#ref-7">[7]</a></sup></p><figure class="article-figure"><img src="/assets/articles/reliability-by-design/figure-02-recovery-loop.webp?v=ef432c55d2d3c342" width="1672" height="941" loading="lazy" alt="工程团队围绕受损的软件模块形成闭环，通过观测仪表、隔离闸门、旁路、修复台和更新后的蓝图完成发现、限制、恢复与学习"><figcaption><p><strong>图 2 · 可靠性闭环。</strong> 故障检测只是起点。真正降低损失的是从信号到隔离、从恢复到学习的完整路径；AI 可以参与每个环节，但控制目标和验收证据必须先由团队定义。</p></figcaption></figure><h2 id="可观测性与恢复能力也是产品功能"><span class="section-no">08</span><a href="#可观测性与恢复能力也是产品功能" class="headerlink" title="可观测性与恢复能力也是产品功能"></a>可观测性与恢复能力也是产品功能</h2><p>许多团队在实现功能时投入充足，却把日志、指标、告警、恢复脚本和演练推迟到“上线之后”。结果往往是：系统已经失败，团队却只能从零散日志猜测用户是否受到影响；备份一直在生成，却从未证明能够在目标时间内恢复。</p><p>可靠性要求应该像接口行为一样可测试。对每条关键业务流，至少需要写清：</p><div class="diagnostic"><h3>关键路径的可靠性验收</h3><ol><li>成功、失败和性能下降分别由什么用户结果来定义？</li><li>哪些指标能在用户投诉之前发现偏离？</li><li>告警到达谁手里，收到后第一步做什么？</li><li>单个实例、区域、依赖或错误配置的最大影响范围是多少？</li><li>系统在降级状态下仍然保证什么，又明确放弃什么？</li><li>恢复依赖哪些数据、权限、工具和人工决定？</li><li>RTO 与 RPO 是否被真实演练验证，而不是只写在文档里？</li><li>新版本能否安全停止、回滚，并与旧版本短暂共存？</li></ol></div><p>能够回答这些问题，才意味着团队拥有一个可运行的服务，而不只是一个可部署的程序。</p><p class="part-label">第四部分 · 教 AI 思考失败</p><h2 id="从功能提示词升级为生产任务契约"><span class="section-no">09</span><a href="#从功能提示词升级为生产任务契约" class="headerlink" title="从功能提示词升级为生产任务契约"></a>从功能提示词升级为生产任务契约</h2><p>当前的编程助手通常会寻找从需求到可运行实现的最短路径。如果输入只是“实现一个订单处理服务”，Controller、Service、数据库访问、参数校验和单元测试自然会成为主要输出。超时、幂等、故障隔离和恢复流程没有出现，往往不是模型完全不知道这些概念，而是任务从未把它们列为完成条件。</p><p>比一串“请考虑可靠性”的提醒更有效的做法，是把失败行为写进任务契约：</p><figure class="highlight text"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line">实现一个订单处理服务。功能正确只是验收的一部分。</span><br><span class="line"></span><br><span class="line">先识别关键业务承诺和外部依赖。对每个重要失败模式说明：</span><br><span class="line">1. 触发场景与业务影响；</span><br><span class="line">2. 检测信号与告警条件；</span><br><span class="line">3. 超时、限流、隔离或降级策略；</span><br><span class="line">4. 重试位置、次数、退避方式与幂等语义；</span><br><span class="line">5. 数据一致性、补偿与人工介入边界；</span><br><span class="line">6. 恢复步骤、RTO/RPO 与回滚路径；</span><br><span class="line">7. 用什么测试或演练证明上述机制有效。</span><br><span class="line"></span><br><span class="line">交付物必须包含：实现、风险清单、可观测性、故障注入测试、</span><br><span class="line">发布与回滚方案，以及值班人员可执行的恢复说明。</span><br><span class="line">无法从现有需求确定的地方，请明确列为待决策项，不要自行假设。</span><br></pre></td></tr></tbody></table></div></figure><p>这个提示词的关键不是列出了多少术语，而是要求模型把每一种机制连接到故障场景、业务影响和验证证据。否则，“加入熔断器”很容易成为装饰性的架构建议，“增加监控”也可能只产生一堆没人行动的指标。</p><div class="callout"><p><strong>让 AI 交付证据，而不只是交付代码。</strong> 要求它展示重复请求、下游超时、部分发布、依赖过载和恢复演练的测试结果；对于无法证明的保证，明确标记未知，而不是用架构名词填补空白。</p></div><h2 id="AI-不能替代故障的所有权"><span class="section-no">10</span><a href="#AI-不能替代故障的所有权" class="headerlink" title="AI 不能替代故障的所有权"></a>AI 不能替代故障的所有权</h2><p>AI 可以帮助枚举失败模式、生成故障注入测试、检查配置、起草 Runbook，甚至在约束明确时执行部分恢复动作。它最适合扩展团队寻找反例和重复验证的能力。</p><p>但模型不知道一次结算延迟对这家公司的真实代价，也不能独自决定隐私、资金和客户信任之间的取舍。它看到的是需求、代码和可用上下文；工程师面对的则是承诺、组织能力和后果。</p><p>因此，人的职责不再只是逐行实现功能，而是建立可靠性的控制面：定义什么不能丢，决定风险预算，限制自动化权限，审查故障边界，要求验证证据，并确保有人能够在凌晨三点恢复系统。</p><h2 id="生而可靠"><span class="section-no">11</span><a href="#生而可靠" class="headerlink" title="生而可靠"></a>生而可靠</h2><p>软件行业花了几十年优化“如何写代码”，AI 又把这个过程推到了新的速度。但生产系统的基本规律没有改变：服务器仍然会失败，网络仍然会失败，人仍然会犯错，依赖仍然会在不合适的时候改变行为。</p><p>构建功能的能力正在迅速自动化。预判失败、决定损失边界并为恢复负责，反而因此变得更有价值。</p><p>“生而可靠”并不意味着第一次发布就拥有无限冗余，也不意味着系统永远不出故障。它意味着，从第一个需求开始，成功路径和失败路径就拥有同等真实的地位；从第一次上线开始，检测、隔离、恢复和学习就被当作产品的一部分。</p><div class="pullquote"><p>可靠性始于我们停止只问“系统能不能工作”，转而追问：“当它不能工作时，哪些承诺仍然必须成立？”</p></div><section class="references" id="references"><h2 data-no-number="true">参考资料与延伸阅读</h2><p class="note">本文以公开的工程实践校准可靠性、重试、幂等和事故响应等概念；具体架构仍需根据业务影响、成本和团队能力做取舍。</p><ol><li id="ref-1">Alvidrez, Marc. “<a href="https://sre.google/sre-book/embracing-risk/">Embracing Risk</a>.” <em>Site Reliability Engineering</em>, Google, 2016.</li><li id="ref-2">Microsoft. “<a href="https://learn.microsoft.com/en-us/azure/well-architected/reliability/principles">Reliability Design Principles</a>.” <em>Azure Well-Architected Framework</em>.</li><li id="ref-3">Brooker, Marc. “<a href="https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/">Timeouts, Retries, and Backoff with Jitter</a>.” <em>Amazon Builders’ Library</em>.</li><li id="ref-4">Featonby, Malcolm. “<a href="https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/">Making Retries Safe with Idempotent APIs</a>.” <em>Amazon Builders’ Library</em>.</li><li id="ref-5">Stripe. “<a href="https://docs.stripe.com/api/idempotent_requests">Idempotent Requests</a>.” <em>Stripe API Reference</em>.</li><li id="ref-6">Jones, Stephen, et al. “<a href="https://sre.google/workbook/incident-response/">Incident Response</a>.” <em>The Site Reliability Workbook</em>, Google, 2018.</li><li id="ref-7">Rogers, Daniel, et al. “<a href="https://sre.google/workbook/postmortem-culture/">Postmortem Culture: Learning from Failure</a>.” <em>The Site Reliability Workbook</em>, Google, 2018.</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/reliability-by-design/</id>
    <link href="https://ryu.xin/zh/posts/reliability-by-design/"/>
    <published>2026-06-20T16:00:00.000Z</published>
    <summary>AI 可以迅速生成完整功能，却很少默认设计失败路径。本文从关键业务流、故障边界、幂等性、可观测性与恢复流程出发，讨论怎样让生产系统生而可靠。</summary>
    <title>生而可靠：AI 在生产系统构建中仍然缺失的能力</title>
    <updated>2026-07-31T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="AI" scheme="https://ryu.xin/zh/tags/AI/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="DFX" scheme="https://ryu.xin/zh/tags/DFX/"/>
    <content>
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>过去几个月，我越来越多地使用 AI 编写真实的产品代码。我的感受有些复杂：它确实很快、很实用，有时甚至好得出人意料。但“功能做出来了”和“系统设计好了”，从来不是一回事。</p><p>问题通常不在于 AI 不会写代码，而在于我们只给了它功能需求，却把可靠性、可维护性、可观测性、可测试性、安全性和可运营性留在了工程师脑中。DFX，也就是 Design for X，正是把这些质量目标重新放回需求和设计。代码生成越便宜，这些约束反而越值钱。</p></header><p class="thesis">AI Coding 的目标不应该只是更快地产生更多代码，而应该是在更清晰的约束下，产生更好的代码。</p><p class="part-label">第一部分 · 功能能跑，系统呢？</p><h2 id="功能做完了，系统却越来越不敢碰"><span class="section-no">01</span><a href="#功能做完了，系统却越来越不敢碰" class="headerlink" title="功能做完了，系统却越来越不敢碰"></a>功能做完了，系统却越来越不敢碰</h2><p class="lead dropcap">过去几个月，我越来越多地让 AI 直接写代码。表面上看，它已经非常厉害：让它做一个页面、写一条 API、增加一个定时任务、连接数据库，或者修复一个小 Bug，它通常都能完成得不错。很多时候，结果不只是“勉强能用”，而是真的很快、很实用，偶尔还会让人惊喜。</p><p>但在真实产品代码里用了一段时间后，我逐渐注意到另一个问题：<strong>AI 很擅长实现功能，却不会自动替我们设计出一个好系统。</strong></p><p>一开始，一切看起来都很正常。功能能跑，API 返回了正确数据，前端也接通了，任务执行成功，日志里没有明显报错。随后需求又来了一条，再来一条，然后还有一条。经过几轮修改，代码开始变得异常熟悉：业务逻辑散落在各层，模块边界越来越模糊，相同检查重复出现，状态变化藏在分支里，异常处理各自为政，配置逻辑和执行逻辑纠缠在一起。</p><p>换句话说，功能完成了，系统却越来越难碰。</p><p>这并不只是“AI 会写烂代码”的问题。人类工程师同样会写出这样的代码。区别在于，AI 可以把这个过程加速很多倍。它能放大好的设计，也能放大缺失的边界、含糊的要求和一次次权宜之计。</p><p>2025 年 DORA 关于 AI 辅助软件开发的报告，把 AI 的主要作用概括为“放大器”：它会同时放大一个组织原有的优势和弱点，而不是替代工作背后的整个工程系统。<sup class="ref"><a href="#ref-1">[1]</a></sup> 这份研究讨论的是组织能力，但映射到代码库，我看到的是同样的现象：工程纪律清晰时，AI 会让它跑得更快；设计已经漂移时，AI 只会给漂移增加吞吐量。</p><p>真正的问题是，大多数时候，我们只给 AI 功能需求。我们告诉它系统要做什么，却没有明确告诉它：出错时应该怎样表现，未来应该怎样维护，运行状态怎样被看见，新的需求怎样扩展，又该怎样防止人犯下代价高昂的错误。</p><p>这就是为什么我认为，在 AI Coding 时代，DFX 只会变得更重要。</p><h2 id="只有功能需求，远远不够"><span class="section-no">02</span><a href="#只有功能需求，远远不够" class="headerlink" title="只有功能需求，远远不够"></a>只有功能需求，远远不够</h2><p>在软件设计中，我们通常会谈到两类需求。</p><p>功能需求描述系统“要做什么”：用户登录、创建订单、调度任务、生成报表、处理支付、发送通知或执行交易。这些需求很容易从外部观察。按钮有还是没有，API 能不能调用，流程是完成还是失败，一眼就能看见。</p><p>但真实系统的评价标准，从来不只是某个功能能否在理想条件下成功运行一次。系统还需要可靠、可维护、可观测、可测试、安全、可扩展、可运营。我们常把它们统称为“非功能需求”，这个名字听起来像是次要要求，实际上它们对架构的影响，往往比可见功能更深。</p><p>Fred Brooks 在《没有银弹》中区分了软件工作的“偶然困难”和“本质困难”：编程语言、工具和表达方式带来的摩擦可以被不断降低，但软件真正困难的部分，仍然是对复杂概念结构的定义、设计与验证。<sup class="ref"><a href="#ref-2">[2]</a></sup> 这篇论文比 AI Coding 早了几十年，把它用在今天是一种推论，但很贴切：AI 能显著降低“把想法写成代码”的成本，却不能替我们决定系统究竟意味着什么、边界在哪里，以及失败之后什么承诺仍然必须成立。</p><p>以一个简单的任务执行系统为例。如果只关心功能，实现非常直接：</p><ol><li>从数据库读取任务；</li><li>执行任务；</li><li>更新任务状态；</li><li>返回执行结果。</li></ol><p>AI 很快就能写完。但只要把可靠性放进来，设计立刻变得有意思。</p><p>如果进程执行到一半崩溃怎么办？同一个任务被两个 Worker 同时领取怎么办？外部 API 已经部分成功，却在返回响应前超时怎么办？业务操作成功后，数据库状态更新失败怎么办？任务该不该重试？操作是否幂等？用户能否安全地再点一次按钮？哪些状态必须持久化，哪些状态可以重新计算？</p><p>这些不是无关紧要的实现细节。在生产系统里，真正的事故往往就发生在这些地方。</p><div class="callout"><p><strong>一个简单的判断标准：</strong> 功能验收证明理想路径能跑通；工程验收则要定义，当这条路径被打断、重复、延迟、修改或误操作时，系统还必须守住什么。</p></div><p class="part-label">第二部分 · DFX 改变的不是名词，而是设计顺序</p><h2 id="DFX-在实践中究竟意味着什么"><span class="section-no">03</span><a href="#DFX-在实践中究竟意味着什么" class="headerlink" title="DFX 在实践中究竟意味着什么"></a>DFX 在实践中究竟意味着什么</h2><p>DFX 是 Design for X，也就是“为了某个目标而设计”。这个 X 可以代表许多不同的质量目标：</p><div class="principles"><div class="principle"><strong>面向可靠性和可用性设计</strong>：预期失败、限制影响范围，并能在不丢失关键承诺的前提下恢复。</div><div class="principle"><strong>面向可维护性和可扩展性设计</strong>：让边界和状态变化足够清楚，能够承受下一次需求修改。</div><div class="principle"><strong>面向可测试性设计</strong>：让成功与失败场景中的关键行为可以被控制、观察和验证。</div><div class="principle"><strong>面向可观测性设计</strong>：提供能够解释用户影响、当前状态和恢复进度的信号。</div><div class="principle"><strong>面向安全设计</strong>：限制权限、校验输入，让危险操作明确可见。</div><div class="principle"><strong>面向运营设计</strong>：把发布、回滚、诊断、人工介入和审计做成正常流程。</div><div class="principle"><strong>面向扩展性和成本设计</strong>：说清负载假设，以及系统为了履行承诺可以付出多少资源。</div></div><p>下面这张分类图来自更广义的产品设计语境。它把 DFX 分为产品交付、产品演进和产品运行三组，继续向下覆盖采购、供应链、部署、可靠性、可服务性、安全、兼容、复用等目标。<sup class="ref"><a href="#ref-3">[3]</a></sup> 软件团队未必使用完全相同的词汇，但核心思想是一致的：产品必须为功能完成之后的漫长生命周期而设计。</p><figure class="article-figure"><img src="/assets/articles/ai-coding-dfx/figure-01-dfx-taxonomy.webp?v=0346f30fa9764978" width="1200" height="675" loading="lazy" alt="DFX 分类树，将质量目标分为产品交付、产品演进和产品运行三组"><figcaption><p><strong>图 1 · DFX 贯穿交付、演进与运行。</strong> 功能完成只是产品生命周期中的一个瞬间。这张图的意义，在于让质量目标在实现之前就进入设计讨论。</p></figcaption></figure><p>这些话题听起来不如发布一个新功能兴奋，但它们决定了功能上线之后，系统还能不能活下去。一个功能可以在一个下午里写完，一套糟糕的架构却可能惩罚团队两年。</p><p>使用 AI 时，这个问题尤其明显。代码生成变便宜了，偶然复杂度也随之变得廉价。我们可以不断要求它：“就加一个判断”“再支持一个场景”“只修这一个 Bug”“先复用现有逻辑”。每一个指令单独看都很合理，整体设计却在持续恶化。</p><p>最后，没有人知道真正的业务边界在哪里，没有人知道哪个状态才是权威状态，也没有人知道一次重试是否安全、一次删除能否恢复、一个失败究竟是预期行为、被忽略的问题，还是即将爆炸的风险。</p><p>到了这一刻，代码就不再是资产，而开始变成负债。</p><h2 id="AI-为什么容易写出“意大利面代码”"><span class="section-no">04</span><a href="#AI-为什么容易写出“意大利面代码”" class="headerlink" title="AI 为什么容易写出“意大利面代码”"></a>AI 为什么容易写出“意大利面代码”</h2><p>我不认为 AI 写出意大利面代码，是因为它不懂编程。很多时候，它对语法、框架、常见模式，甚至一些架构概念都掌握得不错。问题在于，它默认优化的目标通常太窄。</p><p>如果你只说“实现这个功能”，它自然会优化“把当前功能做完”。它会选择一条最直接的路径，让眼前的需求先跑起来。对于一个小脚本或用完即弃的原型，这可能完全合理；但对于需要持续演进的产品，通往今天功能的最短路径，未必是通往可维护系统的最短路径。</p><p>代码的恶化通常并不戏剧化：</p><dl class="timeline"><dt>第一次修改</dt><dd>，为了方便，业务逻辑直接写进 Controller。</dd><dt>第二次修改</dt><dd>，为了省事，几个新条件继续堆进同一个 Service。</dd><dt>第三次修改</dt><dd>，因为改模型看起来太贵，一个新状态被塞进旧字段。</dd><dt>第四次修改</dt><dd>，因为要求只是“先让它跑起来”，异常被捕获后悄悄忽略。</dd></dl><p>每一个决定单独看都不算灾难，合在一起却形成了一个很难推理的系统。</p><figure class="article-figure"><img src="/assets/articles/ai-coding-dfx/figure-02-accidental-complexity.webp?v=c8c27e8d472017b8" width="1672" height="941" loading="lazy" alt="一个原本整洁的机械装置在一次次合理补丁之后，仍然能够运行，却被杂乱线路和重复控制器完全包围"><figcaption><p><strong>图 2 · 偶然复杂度，往往就是在“只再改一点”中累积起来的。</strong> 绿色指示灯依然亮着，功能也依然能跑。代价只是被转移给了下一个需求、下一次事故，以及那个必须解释哪根线才算权威状态的人。</p></figcaption></figure><p>Martin Fowler 的“设计耐力假说”描述了同一条曲线：忽略设计，早期也许能更快交付功能；但代码库会逐渐恶化，让每一次后续修改都更慢。好的设计让项目能够“更长时间地保持速度”。Fowler 很谨慎地把它称为假说，而不是已经得到客观证明的定律；设计从何时开始产生回报，也取决于具体场景。<sup class="ref"><a href="#ref-4">[4]</a></sup> AI 并没有让这条曲线失效。它只是让更多修改在更短时间内发生，因此我们会更早抵达曲线真正产生后果的部分。</p><p>这并不意味着，应该让 AI 在写第一行代码前先造一座宏大的架构。AI 同样会过度设计：层次太多、Helper 太多、配置太多，或者引入一个看起来优雅、产品却根本用不到的抽象。无论来自补丁还是模式，复杂度都不是免费的。</p><p>所以，正确的问题不再是“AI 能不能写代码”。它当然能。更好的问题是：<strong>在 AI 开始写之前，我们能不能先给它正确的工程约束？</strong></p><p class="part-label">第三部分 · 为失败设计，也为人设计</p><h2 id="可靠性：不要只设计-Happy-Path"><span class="section-no">05</span><a href="#可靠性：不要只设计-Happy-Path" class="headerlink" title="可靠性：不要只设计 Happy Path"></a>可靠性：不要只设计 Happy Path</h2><p>可靠性是最适合带入 AI Coding 的 DFX 视角之一。可靠的系统不是永远不会失败的系统，那不现实。可靠的系统会预期失败，限制故障影响范围，让失败能够被看见，并给团队留下恢复路径。</p><p>最重要的原则很简单：假设失败一定会发生。进程会崩溃，网络会抖动，磁盘会写满，第三方 API 会超时，用户会点错按钮，开发人员也会发布错误配置。一个只有在一切顺利时才能工作的系统，并不可靠，只是幸运。</p><p>所以，在让 AI 写代码之前，我更愿意先问下面这些问题：</p><div class="diagnostic"><h3>实现之前的 DFX 问题</h3><ol><li>这个流程可能在哪里失败？</li><li>每一种失败发生后，系统会处于什么状态？</li><li>哪些操作必须幂等？</li><li>哪些失败可以重试，重试应该由哪一层负责？</li><li>哪些失败应该告警，哪些必须人工介入？</li><li>为了事后理解事故，需要记录哪些日志和指标？</li><li>为了崩溃后恢复，必须持久化哪些状态？</li><li>用什么证据证明恢复已经完成？</li></ol></div><p>当 AI 先回答完这些问题，后面的实现通常会明显不同。状态变化会更加清晰，重试责任会更加谨慎，重要失败不会被悄悄隐藏，恢复也会从事后补救变成设计的一部分。</p><p>前面任务执行器里的超时问题，在 AWS 有一个几乎对应的例子。Malcolm Featonby 描述过一次 EC2 创建请求：服务可能已经创建了资源，但响应在返回途中丢失。如果调用方盲目重试，就可能再创建一台实例。AWS 的做法，是让调用方通过唯一请求标识明确表达意图，使重复请求能够被识别并按幂等语义处理。<sup class="ref"><a href="#ref-5">[5]</a></sup> 这里真正值得借鉴的不是“所有接口都要加一个幂等键”，而是：<strong>重试行为应该是 API 契约的一部分，而不是事故之后随手塞进 Catch 里的补丁。</strong></p><p>可靠性也不等于平均保护所有路径。Google SRE 把可靠性视为风险管理：服务的可靠性目标应该与业务愿意承担的风险对齐，而不是不计成本追求最高可用率。<sup class="ref"><a href="#ref-6">[6]</a></sup> 这也提醒我们，DFX 不能变成机械清单。营销报表晚十分钟、订单重复扣款和审计记录丢失，显然不应该获得相同的机制和预算。</p><p>另一个重要原则是保持简单。一个解决真实问题的简单设计，通常好过一个聪明却制造出五个新问题的设计。但“简单”也不能掩盖单点故障：如果关键流程依赖唯一的服务、唯一的 Job、唯一的配置、唯一的外部系统或唯一的人工步骤，这个风险必须被明确写出来。除非我们要求 AI 从可靠性角度审查设计，否则它未必会主动指出这些问题。</p><h2 id="人为失误，也是系统设计的一部分"><span class="section-no">06</span><a href="#人为失误，也是系统设计的一部分" class="headerlink" title="人为失误，也是系统设计的一部分"></a>人为失误，也是系统设计的一部分</h2><p>很多生产事故，并不是机器自己坏了，而是人在使用系统时，走进了设计没有防护的路径。</p><p>有人删错数据，有人发布到错误环境，有人在不了解影响时修改了配置，有人太快地点下危险按钮，也有人因为看不到进度而把同一个操作执行了两次。</p><p>责怪用户很容易，但好的系统设计应该主动降低这些错误发生的概率和代价。Don Norman 在《Human Error? No, Bad Design》中说得很直接：如果我们只盯着事故链条最后那个人的动作，就会忽略真正让错误容易发生的设备或流程设计。<sup class="ref"><a href="#ref-7">[7]</a></sup></p><p>映射到软件系统，这个观点会带来非常具体的设计要求：</p><ul><li>危险操作不能只弹出一句笼统的“你确定吗？”，还应展示真实影响，并根据风险提供二次确认、Dry Run、审批或回滚路径。</li><li>复杂配置不能照单全收。系统应该在生效前检查冲突、缺失依赖、非法范围和高风险组合。</li><li>删除不必总是立即永久删除。软删除、回收站、恢复窗口或延迟执行，通常更安全。</li><li>长时间运行的操作不能让用户猜测。进度、当前状态、日志、重试行为和取消语义，都是功能的一部分。</li></ul><p>这些不是功能之外的装饰，而是可靠性和可运营性本身。但很多 AI Coding 提示词只描述用户怎样完成正确操作，很少要求 AI 思考：用户可能怎样做错、怎样失去上下文、怎样重复执行，以及出错后怎样撤销。</p><p class="part-label">第四部分 · 与 AI 建立一份更完整的工程契约</p><h2 id="一种更好的-AI-Coding-使用方式"><span class="section-no">07</span><a href="#一种更好的-AI-Coding-使用方式" class="headerlink" title="一种更好的 AI Coding 使用方式"></a>一种更好的 AI Coding 使用方式</h2><p>对于任何不只是孤立小任务的功能，我现在都不认为第一步应该是让 AI 立刻写代码。更好的第一步，是先要求它从 DFX 角度分析需求。</p><p>例如：</p><figure class="highlight text"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line">在写代码之前，请从 DFX 角度分析这个需求。</span><br><span class="line">覆盖可靠性、可维护性、可观测性、可测试性、安全性和运营安全。</span><br><span class="line"></span><br><span class="line">识别主要失败场景、状态边界、幂等要求、重试行为、恢复策略、</span><br><span class="line">日志与指标、配置校验、人为失误风险，以及未来最可能变化的部分。</span><br><span class="line"></span><br><span class="line">然后提出模块结构、实现计划和验证证据。</span><br><span class="line">不要替我猜测业务取舍；把尚未决定的问题明确列出来。</span><br></pre></td></tr></tbody></table></div></figure><p>这听起来慢了一步，实际往往更省时间。当 AI 理解了质量目标之后，它就不再只是一个代码生成器，而更像一个工程助手。生成的代码通常更有结构，设计取舍也更容易被评审。</p><p>这段提示词不是魔法。你仍然需要质疑 AI 的假设、审查设计、理解自己的系统，并判断哪些风险值得付出成本。真正的变化在于，质量目标不再只存在于评审者脑中，而是正式成为任务的一部分。</p><p>为了让实现计划真正可执行，我会要求它至少在六个方面给出证据：</p><div class="table-wrap"><table><caption>AI 生成变更的 DFX 实用检查</caption><thead><tr><th>视角</th><th>计划必须回答的问题</th><th>发布前证据</th></tr></thead><tbody><tr><td>可靠性</td><td>哪里会失败、重复或部分成功？</td><td>失败测试、幂等语义、恢复步骤</td></tr><tr><td>可维护性</td><td>哪个边界拥有这条规则，哪里最可能变化？</td><td>模块图、状态模型、明确契约</td></tr><tr><td>可观测性</td><td>怎样知道用户结果和系统当前状态？</td><td>结构化日志、指标、追踪、可行动告警</td></tr><tr><td>可测试性</td><td>关键状态与依赖能否被控制？</td><td>成功、失败和重试的确定性测试</td></tr><tr><td>安全与运营</td><td>谁可以操作，如何限制影响，怎样撤销？</td><td>权限检查、校验、Dry Run、回滚、审计</td></tr><tr><td>扩展性与成本</td><td>设计基于什么负载和预算假设？</td><td>限流、容量测试、降级行为、成本信号</td></tr></tbody></table></div><p>AI Coding 的目标不应该只是更快地产生更多代码，而应该是在更清晰的约束下，产生更好的代码。</p><h2 id="当代码变便宜，架构反而更值钱"><span class="section-no">08</span><a href="#当代码变便宜，架构反而更值钱" class="headerlink" title="当代码变便宜，架构反而更值钱"></a>当代码变便宜，架构反而更值钱</h2><p>有些人认为，随着代码越来越容易生成，架构会变得不再重要。我的判断恰恰相反。</p><p>当写代码变得更便宜，决定什么代码值得写就变得更有价值；当实现速度越来越快，错误设计也更容易被放大；当几乎任何人都能生成一个可运行功能，真正拉开差距的，是增加许多功能之后，这个系统是否仍然能够被理解、修改、运营和信任。</p><p>AI 可以写代码，但它需要一个清晰的目标。</p><p>AI 可以重构代码，但它需要知道重构服务于哪个质量目标。</p><p>AI 可以修复 Bug，但它需要理解什么行为才是正确行为。</p><p>AI 可以生成抽象，但它并不总能判断这个抽象是否值得它带来的成本。</p><p>所以，DFX 并不是一个过时的架构话题。它可能恰恰是我们用好 AI Coding 最实用的方法之一。</p><p>未来我们问 AI 的问题，不应该停在：</p><blockquote><p>这个功能应该怎样实现？</p></blockquote><p>还应该继续追问：</p><blockquote><p>这个功能应该在什么质量约束下被实现？</p></blockquote><p>如果跳过第二个问题，AI 的确可以让我们在短期内跑得更快，同时也可能让系统越来越难改、越来越难运维、越来越难信任。代码依然能跑，绿色指示灯也依然亮着，但工程债务可能早已开始复利增长。</p><section class="references" id="references"><h2 data-no-number="true">参考资料与延伸阅读</h2><ol><li id="ref-1">DORA. “<a href="https://dora.dev/research/2025/dora-report/">State of AI-assisted Software Development 2025</a>.” Google Cloud，2025。</li><li id="ref-2">Brooks, Frederick P., Jr. “<a href="https://www.cs.unc.edu/techreports/86-020.pdf">No Silver Bullet: Essence and Accidents of Software Engineering</a>.” University of North Carolina at Chapel Hill，1986。</li><li id="ref-3">“<a href="https://pbs.twimg.com/media/HLEAGnuaEAAgbFU.jpg">DFX 分类图原图</a>.” 随 6 月 18 日原文提供的图片。</li><li id="ref-4">Fowler, Martin. “<a href="https://martinfowler.com/bliki/DesignStaminaHypothesis.html">Design Stamina Hypothesis</a>.” 2007。</li><li id="ref-5">Featonby, Malcolm. “<a href="https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-APIs/">Making Retries Safe with Idempotent APIs</a>.” <em>Amazon Builders’ Library</em>。</li><li id="ref-6">Alvidrez, Marc. “<a href="https://sre.google/sre-book/embracing-risk/">Embracing Risk</a>.” <em>Site Reliability Engineering</em>，Google，2016。</li><li id="ref-7">Norman, Don. “<a href="https://jnd.org/human-error-no-bad-design/">Human Error? No, Bad Design</a>.” 2014。</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/ai-coding-dfx/</id>
    <link href="https://ryu.xin/zh/posts/ai-coding-dfx/"/>
    <published>2026-06-18T16:00:00.000Z</published>
    <summary>AI 可以快速实现功能，却不会自动生成一个可靠、可维护、可观测、安全且易于运营的系统。DFX 的价值，就是把这些质量目标变成明确的设计约束。</summary>
    <title>AI Coding 时代，DFX 只会更重要</title>
    <updated>2026-08-09T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="软件工程" scheme="https://ryu.xin/zh/categories/software-engineering/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Lattice" scheme="https://ryu.xin/zh/tags/Lattice/"/>
    <category term="Architecture" scheme="https://ryu.xin/zh/tags/Architecture/"/>
    <category term="Clean Architecture" scheme="https://ryu.xin/zh/tags/Clean-Architecture/"/>
    <content>
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>2015 年初，我加入 A 公司不久，看到的交易平台已经处在一种矛盾的状态里：系统被拆得越来越细，平台开放的接口和扩展点越来越多，业务交付却没有因此变得更轻。人手总是不够，项目排期很长，延期并不罕见；每到周四的固定发布日，数十个分支汇在一起，任何一个业务的变化都可能要求其他业务陪着回归。</p><p>问题并不只是代码里有太多 <code>if/else</code>，也不只是传统 SPI 不够灵活。更深层的问题是，平台没有清楚回答几个问题：一段定制逻辑属于谁，只应该影响谁；一个业务场景如何跨越多个应用保持完整；多个规则同时生效时怎样组合；业务代码能否脱离平台独立演进。Lattice 就是围绕这些问题形成的开源业务扩展调用框架。它先分开业务与平台、业务与业务、逻辑业务架构与物理应用架构，再用业务身份、Ability、Use Case、垂直与水平组合以及 Reduce，把“到处修改平台”改造成“在明确边界内组装业务”。最后，我会说明自己如何在 Spark 中把这些判断整理成 AI 架构 Skill，使它们在设计、模块划分和代码生成时真正成为约束。</p></header><p class="thesis">高度可定制的平台，关键不是提供尽可能多的扩展点，而是让每次变化都有明确的归属、作用域、组合规则与发布边界。Lattice 要解决的不是“如何让业务插入一段代码”，而是“如何让业务变化不再污染整个平台”。</p><p class="part-label">第一部分 · 当平台开始追不上业务</p><h2 id="2015-年，我看到的不是一个技术问题"><span class="section-no">01</span><a href="#2015-年，我看到的不是一个技术问题" class="headerlink" title="2015 年，我看到的不是一个技术问题"></a>2015 年，我看到的不是一个技术问题</h2><p class="lead dropcap">2015 年初加入 A 公司后的前半年，我花了很多时间观察交易平台怎样承接业务。那时最直观的感受不是某个接口设计得不好，而是一种持续存在的疲惫：人手不够，加班严重，排期很长，项目经常延期；平台与业务采用共建方式协作，但团队越多，协同成本越高。大家都很努力，系统也拥有大量看起来先进的技术机制，可业务交付仍然越来越重。</p><p>这不是因为分布式架构本身做错了。A 公司早期的电商业务相对单一，一个系统可以包含商品发布、购物车、订单创建和履约等完整功能。随着业务量和团队规模增长，把单体拆成用户、商品、交易、店铺等职责更内聚的系统，是一次必要而且成功的演进。每个系统能够独立设计、承接需求和发布，研发效率与稳定性都曾因此提升。</p><p>但任何架构的收益都有适用尺度。业务继续扩张，行业越来越多，应用和服务数量进入数千量级之后，原本用于降低复杂度的拆分，开始制造另一种复杂度：一个完整的业务意图被切散在许多应用和团队里。</p><p>一个需求从提出到上线，可能要经过多个团队共同分析、设计、开发、联调，并按照特定顺序发布。更麻烦的是，没有人能有把握地说清楚它究竟会触及多少系统。主流程容易看见，异常分支和多年积累的旁路最容易在后期暴露。漏掉一个点，后面可能就是方案重评、返工和延期。</p><p>我们在架构层完成了应用解耦，却没有在业务层完成意图的重新聚合。</p><div class="pullquote"><p>系统可以被拆成一千个服务，但用户提出的仍然是一个完整需求。技术边界越多，越需要一种机制把业务意图重新组织起来。</p></div><h2 id="从-API-开放到业务方共建"><span class="section-no">02</span><a href="#从-API-开放到业务方共建" class="headerlink" title="从 API 开放到业务方共建"></a>从 API 开放到业务方共建</h2><p>平台早期最重要的开放方式是 API。平台定义稳定的服务接口，业务系统通过远程调用复用商品、交易、营销等能力。这种方式适合表达相对稳定的功能，却很难穷举不同行业的业务差异。</p><p>当差异越来越多，接口参数中开始出现 <code>Map</code>。调用方可以往里面放平台模型没有预先定义的上下文，但一个不认识这些参数的平台，也很难真正理解它们对应的业务语义。再往后，Java SPI 被引入：平台定义接口，业务团队实现接口，把特定业务逻辑放进平台执行路径。这种“业务方共建”一度释放了很大的生产力。</p><p>它的问题也逐渐显现。平台没有提供足够强的业务—平台分离机制，业务代码和平台代码仍在同一个代码库里纠缠。业务定制不能独立发布，必须跟随平台排期进入统一窗口。我印象很深的是，每到周四的固定发布日，需要合并四五十个分支。每个分支单独看都有自己的理由，合在一起却形成一次巨大的全网回归：A 业务上线，B 业务也要担心自己被影响。</p><p>平台的代码质量和隔离性，主要依赖开发者足够谨慎，而不是一种可以被验证的结构。人数少、业务少时，经验和评审也许能够兜住；规模扩大后，“大家小心一点”从来不是可靠的架构。</p><h2 id="一段减库存代码如何慢慢腐化"><span class="section-no">03</span><a href="#一段减库存代码如何慢慢腐化" class="headerlink" title="一段减库存代码如何慢慢腐化"></a>一段减库存代码如何慢慢腐化</h2><p>减库存策略是一个很小、却足够典型的例子。以下代码只为说明问题，和任何生产代码都没有关系。</p><p>最初，平台统一采用“拍下减库存”。后来，大家电商品价格高、库存少，容易遭遇拍下不付款造成的库存占用，于是业务希望改成“付款后减库存”：</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="keyword">public</span> ReduceType <span class="title function_">getInventoryReducePolicy</span><span class="params">(OrderLine orderLine)</span> {</span><br><span class="line">    <span class="keyword">if</span> (orderLine.getProduct().hasTag(<span class="number">9527</span>)) {</span><br><span class="line">        <span class="keyword">return</span> ReduceType.AFTER_PAYMENT;</span><br><span class="line">    }</span><br><span class="line">    <span class="keyword">return</span> ReduceType.BEFORE_PAYMENT;</span><br><span class="line">}</span><br></pre></td></tr></tbody></table></div></figure><p>虚拟商品出现后，有些商品根本不需要扣库存，于是前面又多了一个判断。再后来，大家电支持门店自提：交付给用户的是虚拟提货码，背后对应的实物库存却仍然必须扣减。“虚拟商品不减库存”与“大家电付款后减库存”发生了交叉，判断顺序开始影响结果。</p><p>接着，大家电内部也不再统一。单价高于某个值采用付款后减库存，低于这个值仍然拍下减库存。一开始清楚的默认规则，逐渐变成由商品类型、行业标签、交付方式与价格共同决定的分支树。</p><p>这样的腐化不是某一天由某个糟糕的程序员制造出来的。恰恰相反，每一次改动都解决了一个真实需求，每一次局部判断也可能是当时最经济的选择。几年以后，一个方法可以长到数千行。后来的人面对新需求，只能小心地寻找一个“看起来合适”的位置加入自己的分支，然后祈祷没有改变其他业务。</p><p>这段历史让我意识到，所谓遗留代码，很多时候不是缺少重构，而是缺少业务变化的所有权模型。代码不知道哪条规则属于哪个业务，也不知道规则之间应该隔离、覆盖还是合并，只能让执行顺序替组织做决定。</p><h2 id="SPI-清理了代码，却没有消除耦合"><span class="section-no">04</span><a href="#SPI-清理了代码，却没有消除耦合" class="headerlink" title="SPI 清理了代码，却没有消除耦合"></a>SPI 清理了代码，却没有消除耦合</h2><p>很自然地，团队会把这些分支抽成 SPI：每个实现提供 <code>filter</code> 与 <code>execute</code>，平台遍历实现列表，找到第一个满足条件的策略。</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">interface</span> <span class="title class_">InventoryReducePolicySpi</span> {</span><br><span class="line">    <span class="type">boolean</span> <span class="title function_">filter</span><span class="params">(ReducePolicyRequest request)</span>;</span><br><span class="line">    ReduceType <span class="title function_">execute</span><span class="params">(ReducePolicyRequest request)</span>;</span><br><span class="line">}</span><br></pre></td></tr></tbody></table></div></figure><p>当实现类不多时，这种设计很有效。一个几千行的方法被拆成多个职责更清楚的类，局部代码可读性和测试性都提高了。但规模继续增长，新的问题只是换了一种形态：</p><ul><li>新需求应该修改已有实现，还是注册一个新实现？</li><li>新实现放在列表第几个，才不会被前面的规则截获？</li><li>它的 <code>filter</code> 是否与已有几十个实现重叠？</li><li>调整顺序后，哪些业务会悄悄改变行为？</li></ul><p>更复杂时，<code>filter</code> 里还会调用规则引擎或远程服务。此时即使逐个阅读代码，也很难静态判断某个实现何时生效。在我接触过的复杂系统里，类似 SPI 可以接近千个，每个接口又可能有几十个实现。全局遍历和“第一个命中”使所有业务共享同一棵隐形的决策树。</p><p>表面上，平台消灭了 <code>if/else</code>；本质上，条件分支被搬到了注册顺序和过滤逻辑里。业务之间依然耦合，而且耦合变得更难看见。</p><div class="diagnostic"><h3></h3><ul><li><strong>症状</strong> — 核心方法分支膨胀，修改时不敢确定影响范围。</li><li><strong>第一次修复</strong> — 把分支抽成 SPI 实现，以列表顺序和 <code>filter</code> 决定谁生效。</li><li><strong>新的失败</strong> — 条件与顺序形成全局决策树，业务之间仍然互相竞争。</li><li><strong>根因</strong> — 扩展机制没有业务身份、作用域、组合语义和独立发布边界。</li></ul></div><figure class="article-figure"><img src="/assets/articles/lattice-clean-architecture-practice/figure-01-platform-coupling.webp?v=a40fb0605e895ded" width="1672" height="941" loading="lazy" alt="大量应用、业务分支与发布链路纠缠在共享平台周围，局部改动沿着看不见的依赖向外扩散"><figcaption><p><strong>图 1 · 当扩展机制失去作用域。</strong> 服务拆分降低了单个应用的复杂度，却没有自动保留完整业务意图；全局 SPI、共享代码库和统一发布窗口，又把已经分散的变化重新耦合在一起。</p></figcaption></figure><h2 id="应用视角不是业务视角"><span class="section-no">05</span><a href="#应用视角不是业务视角" class="headerlink" title="应用视角不是业务视角"></a>应用视角不是业务视角</h2><p>另一个更隐蔽的问题，是平台把扩展点按照应用来开放，而业务方是按照场景来思考的。</p><p>在 A 公司当时的体量下，各类业务能力已经被拆分到超过 2000 个微服务中。这个数字的意义不在于系统规模有多大，而在于它已经超过任何一个人能够完整记忆、评估和掌控的范围。没有人可以只凭个人经验画出完整的依赖关系，也很难在需求刚提出时就准确回答：它会经过哪些应用，涉及哪些团队，改变哪些扩展点，又有哪些不在主链路上的入口会被遗漏。</p><p>这并不是说一个需求会修改 2000 个服务，也不是说微服务拆分本身错了。真正的问题是，当完整的业务意图被切散到如此多的技术边界之后，影响评估仍然依赖人去逐个发现和拼接。评估会变成一轮轮人员召集、链路追踪和经验确认；只要少找到一个系统或一个旁路，分析结论就可能是不完整的。</p><p>假设某个业务不允许商品通过购物车购买。从业务语言看，它只有一条规则：“这个业务不支持购物车购买”。但在应用视角里，业务团队可能要完成一串分散的定制：商品详情页隐藏加入购物车按钮；购物车接口拒绝绕过页面直接加入；订单创建服务拒绝伪造购物车渠道下单；其他旁路入口也要做一致校验。</p><p>每个应用提供的扩展点单独看都可能是合理的，可完整性责任被推给了业务交付团队。开发者不仅要理解自己的行业，还要从两千多个微服务中识别与当前场景有关的那一小部分，理解它们开放了什么能力、彼此有什么关系，并证明自己没有漏掉关键入口。应用拆得越细，单个系统的职责越清楚，跨系统的业务评估却可能越困难。</p><p>所以，当时真正要解决的并不是“再设计一种更强的 SPI”，而是把扩展的组织单位从应用和技术处理点，重新提升到业务与场景。平台需要让开发者先看见一个完整业务要完成什么，再由场景去组织它所依赖的能力，而不是要求每个业务团队重新遍历一次庞大的应用地图。</p><p class="part-label">第二部分 · 先重新定义问题，再设计框架</p><h2 id="我们需要回答的六个问题"><span class="section-no">06</span><a href="#我们需要回答的六个问题" class="headerlink" title="我们需要回答的六个问题"></a>我们需要回答的六个问题</h2><p>在几次设计研讨中，我请团队不要先讨论类图和框架，而是完成一句话：“如果平台能做到……就好了，这样我们就可以……”。这种方式帮助我们从技术偏好回到实际阻力。</p><p>大家期待的并不神秘：特定业务的订约与履约方式可以快速构建成业务包；业务包与平台解耦，也与其他业务隔离；业务可以按真实流程选择和组合已有能力；产品与开发能够看见平台提供了什么、当前业务用了什么；业务不必等待平台统一发布窗口；同一套逻辑架构还可以适应不同部署形态。</p><p>把这些诉求继续收敛，可以得到六个必须被框架明确回答的问题：</p><div class="table-wrap"><table><caption>从平台症状到架构问题</caption><thead><tr><th>平台症状</th><th>真正需要回答的问题</th></tr></thead><tbody><tr><td>业务代码混入平台仓库</td><td>变化属于谁，代码边界在哪里？</td></tr><tr><td>A 业务修改可能影响 B 业务</td><td>一段规则的作用域如何确定？</td></tr><tr><td>需求散落在多个应用</td><td>如何按完整场景组织和复用能力？</td></tr><tr><td>扩展点埋在物理应用中</td><td>如何形成不依赖应用拓扑的统一业务视图？</td></tr><tr><td>多个 SPI 同时命中</td><td>规则如何组合，冲突由谁裁决？</td></tr><tr><td>数十个分支统一发布</td><td>业务能否独立开发、测试和交付？</td></tr></tbody></table></div><p>这六个问题决定了 Lattice 的形状。框架里的注解、接口和运行时只是实现手段；如果忘了这些问题，Lattice 也很容易被误用成另一套 SPI 工具。</p><h2 id="重读《干净的架构》：核心不是画同心圆"><span class="section-no">07</span><a href="#重读《干净的架构》：核心不是画同心圆" class="headerlink" title="重读《干净的架构》：核心不是画同心圆"></a>重读《干净的架构》：核心不是画同心圆</h2><p>后来再读 Robert C. Martin 的《干净的架构》，我对它最深的体会不是 Entities、Use Cases、Interface Adapters 和 Frameworks 应该分别放在哪个工程目录，而是“变化应该沿什么方向传播”。</p><p>书中最著名的是依赖规则：源码依赖只能指向更内层。外层是容易变化的机制，内层是更稳定、更接近业务目的的策略。Web、数据库和框架都应该服务于业务规则，而不是让业务规则反过来适应这些技术细节。一个典型用例会调度实体完成业务目标，再通过边界与外部系统交换数据；跨越边界的依赖仍然朝内。<sup class="ref"><a href="#ref-1">[1]</a></sup><sup class="ref"><a href="#ref-2">[2]</a></sup></p><p>但在大型业务平台里，仅仅让数据库依赖领域接口还不够。<strong>业务定制本身也是一种外部变化。</strong> 某个行业的库存策略、某个营销玩法的限购规则、某种履约方式的核销要求，都不应该反向侵入所有业务共享的核心。</p><p>这使我对依赖规则有了一个更具体的理解：架构的内外，不只按技术层划分，也要按政策的适用范围划分。共享实体规则、场景规则、垂直行业规则和横向能力规则，稳定程度与作用范围不同。我们需要让它们通过明确边界协作，而不是在同一个全局列表里互相猜测。</p><p>《干净的架构》还强调独立开发、独立部署、插件边界，以及架构应该直接表达系统用途，而非首先暴露所用框架。<sup class="ref"><a href="#ref-1">[1]</a></sup> 这些观点给了我一套更准确的语言，去解释当年那些从实践中逼出来的判断：</p><ul><li>业务与平台分离，不只是代码整洁，而是在控制变化方向；</li><li>逻辑业务视图与物理应用拓扑分离，不只是方便检索，而是在恢复完整业务意图；</li><li>按用例组织扩展，不只是目录调整，而是在让架构说业务语言；</li><li>插件独立交付，不只是发布提速，而是在兑现边界；</li><li>运行时只执行已确定的组合，不只是性能优化，而是在把隐含冲突变成显式政策。</li></ul><div class="callout"><p><strong>我的读书体会：</strong> 干净并不意味着代码少、层次多或接口多。所谓“干净”，是高层业务政策不会被低层机制和局部定制拖着走；当变化发生时，我们知道它应当停在哪条边界上。</p></div><p class="part-label">第三部分 · Lattice 如何逐一解决这些问题</p><h2 id="为什么叫-Lattice"><span class="section-no">08</span><a href="#为什么叫-Lattice" class="headerlink" title="为什么叫 Lattice"></a>为什么叫 Lattice</h2><p>Lattice 在英文里是格子、网格的意思。我们观察业务时，会看到两个相互交织的维度：一个是彼此隔离的垂直业务，另一个是可以被选择和叠加的水平能力。纵向与横向交织，形状很像格子。当然还有一个不那么严肃的原因：程序员喜欢穿格子衫。</p><p>因此，这个业务扩展调用框架被命名为 Lattice。它不是为了给传统 SPI 换一个新名字，而是要把业务身份和能力组合变成框架的一等概念。开源仓库位于 <a href="https://github.com/hiforce/lattice">hiforce/lattice</a>，本文最近一次更新时主分支版本为 <code>1.0.21</code>。<sup class="ref"><a href="#ref-3">[3]</a></sup></p><h2 id="Lattice-的解法，先从三个分离开始"><span class="section-no">09</span><a href="#Lattice-的解法，先从三个分离开始" class="headerlink" title="Lattice 的解法，先从三个分离开始"></a>Lattice 的解法，先从三个分离开始</h2><p>前面的问题看起来很多，根上却是三种边界同时消失了：业务代码进入平台核心，不同业务进入同一个全局判断空间，完整业务流程又被物理应用切碎。Lattice 的第一步不是增加更多扩展接口，而是先恢复三个分离。</p><div class="table-wrap"><table><caption>Lattice 的三个分离</caption><thead><tr><th>分离</th><th>要隔开的对象</th><th>建立边界的机制</th><th>直接解决的问题</th></tr></thead><tbody><tr><td>业务与平台分离</td><td>平台稳定能力与业务定制</td><td>稳定契约、业务插件、独立代码库</td><td>业务代码不再污染平台核心</td></tr><tr><td>业务与业务分离</td><td>不同业务的规则与实现</td><td>业务身份、定向加载、调用链上下文</td><td>一个业务的变化默认不会进入另一个业务</td></tr><tr><td>逻辑架构与物理架构分离</td><td>业务流程与应用、服务部署拓扑</td><td>注解元数据、统一上报、业务管理视图</td><td>设计者按场景发现能力，不必遍历应用地图</td></tr></tbody></table></div><p>这三个分离不是三项互不相关的功能。第一层回答代码应该放在哪里，第二层回答运行时应该进入哪个规则空间，第三层回答人在设计需求时应该看见什么。缺少任何一层，另外两层都会被削弱：只有插件而没有业务身份，插件仍可能互相误命中；只有身份而没有代码边界，业务仍要跟随平台一起构建发布；只有运行时隔离而没有逻辑视图，需求评估仍会在两千多个服务之间艰难搜索。</p><figure class="article-figure"><img src="/assets/articles/lattice-clean-architecture-practice/figure-02-three-separations.webp?v=e7db09c1f97bfcaa" width="1672" height="941" loading="lazy" alt="平台核心与业务插件通过契约连接，不同业务身份各自处于隔离通道，统一业务流程位于分散的物理应用拓扑之上"><figcaption><p><strong>图 2 · Lattice 的三个分离。</strong> 左侧把业务变化挡在平台核心之外，中间先以业务身份选择唯一规则空间，右侧再把散落在许多应用中的能力还原成一个可供设计和评估的逻辑业务视图。</p></figcaption></figure><h2 id="第一个分离：业务代码与平台代码"><span class="section-no">10</span><a href="#第一个分离：业务代码与平台代码" class="headerlink" title="第一个分离：业务代码与平台代码"></a>第一个分离：业务代码与平台代码</h2><p>过去的“业务共建”，是平台定义 SPI，业务团队把实现直接提交进平台工程。它在早期很有效，因为业务可以快速进入主流程；但随着参与方增多，平台仓库里逐渐同时存在稳定机制和大量局部政策。平台修改要担心业务实现，业务修改也要跟随平台分支、回归和发布，最终形成“你中有我、我中有你”的代码与交付关系。</p><p>Lattice 要求平台仓库只保留稳定的实体、用例、Ability、扩展契约和默认实现，具体业务规则只存在于业务自己的插件包和代码库中。运行容器通过注册与插件加载机制把二者连接起来：平台负责定义“这里允许改变什么”，业务插件负责回答“我的业务在这里如何处理”。依赖关系指向平台提供的稳定契约，而不是让平台核心反向依赖某个具体业务。<sup class="ref"><a href="#ref-3">[3]</a></sup></p><p>于是，三组边界可以尽量对齐：</p><ul><li><strong>代码边界</strong> — 业务定制不进入平台核心仓库；</li><li><strong>测试边界</strong> — 业务插件可以围绕自己的规则与所选能力独立验证；</li><li><strong>发布边界</strong> — 业务变化不再天然绑定平台统一版本和所有业务的回归窗口。</li></ul><p>插件化不等于自动实现独立发布。共享数据库、契约兼容、运行容器和组织流程仍然可能形成耦合。但它至少从源代码结构上切断了最危险的反向依赖，使独立构建、验证与交付成为架构真正支持的选项。</p><h2 id="第二个分离：一个业务与另一个业务"><span class="section-no">11</span><a href="#第二个分离：一个业务与另一个业务" class="headerlink" title="第二个分离：一个业务与另一个业务"></a>第二个分离：一个业务与另一个业务</h2><p>传统 SPI 通常问：“当前请求满足哪个实现的过滤条件？”Lattice 先问：“当前请求属于哪个业务？”</p><p>这两种问题看起来接近，后果却完全不同。传统 SPI 的每个实现都用 <code>filter</code> 猜测自己是否适用于当前请求，所有业务的实现因而被放进同一个候选集合。一旦某个条件少写一个限制、多覆盖一个渠道，或者几个条件发生重叠，原本属于 A 业务的规则就可能在 B 业务中生效。判断正确与否分散在每个实现里，业务越多、组合越复杂，想证明所有过滤条件互斥就越不现实。</p><p>Lattice 把顺序倒过来：<strong>每个业务场景进入调用链时，第一件事就是确定业务身份。</strong> 身份一旦确定，运行时便获得一个明确坐标，只加载这个业务身份对应的插件包和实现；其他业务的代码根本不进入候选集合。业务规则的隔离因此不再依赖每位开发者都写出脆弱但永远正确的过滤条件，而成为框架执行模型的一部分。</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="meta">@Business(code = "business.a", name = "Business A")</span></span><br><span class="line"><span class="keyword">public</span> <span class="keyword">class</span> <span class="title class_">BusinessA</span> <span class="keyword">extends</span> <span class="title class_">BusinessTemplate</span> {</span><br><span class="line">}</span><br><span class="line"></span><br><span class="line"><span class="meta">@Realization(codes = "business.a")</span></span><br><span class="line"><span class="keyword">public</span> <span class="keyword">class</span> <span class="title class_">BusinessAExt</span> <span class="keyword">extends</span> <span class="title class_">BlankOrderLinePriceExt</span> {</span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="keyword">public</span> Long <span class="title function_">getCustomUnitPrice</span><span class="params">(OrderLine orderLine)</span> {</span><br><span class="line">        <span class="keyword">return</span> <span class="number">2000L</span>;</span><br><span class="line">    }</span><br><span class="line">}</span><br></pre></td></tr></tbody></table></div></figure><p><code>@Business</code> 声明业务，<code>@Realization</code> 声明这段实现属于哪个业务。调用链携带统一业务编码，运行时按业务身份定位插件与实现。这里最重要的不是注解语法，而是所有权从隐含条件变成了显式声明：先确定“我是谁”，再寻找“我有哪些规则”。</p><p>统一业务身份还必须贯穿调用链。如果入口知道当前业务，进入下游服务后却丢失了身份，隔离就只停留在一个进程里。Lattice 将业务编码作为扩展调用的基本上下文，使同一业务的规则能够在不同能力调用中保持一致。</p><p>至此，前两个分离解决了代码归属和运行作用域。要完成第三个分离，还需要先把平台能力从零散接口提升为可发现的业务语义，并把这些能力重新组织进完整 Use Case。下面的 Ability、业务二维模型、Reduce 与 Use Case，正是构建逻辑业务视图所需的语言。</p><h2 id="Ability-让平台能力变得可发现、可调用"><span class="section-no">12</span><a href="#Ability-让平台能力变得可发现、可调用" class="headerlink" title="Ability 让平台能力变得可发现、可调用"></a>Ability 让平台能力变得可发现、可调用</h2><p>业务身份回答“谁的规则”，Ability 回答“平台在这个载体上提供什么能力”。</p><p>在 Lattice 中，一个能力围绕特定载体聚合一组可扩展行为。比如订单明细是载体，价格计算是能力，“自定义商品单价”是其中一个扩展点。能力负责加载当前业务的实现，并用明确的归并策略得到结果；业务方只实现自己需要改变的部分。</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">interface</span> <span class="title class_">OrderLinePriceExt</span> <span class="keyword">extends</span> <span class="title class_">IBusinessExt</span> {</span><br><span class="line">    <span class="type">String</span> <span class="variable">EXT_ORDER_LINE_CUSTOM_UNIT_PRICE</span> <span class="operator">=</span></span><br><span class="line">        <span class="string">"OrderLinePriceExt.EXT_ORDER_LINE_CUSTOM_UNIT_PRICE"</span>;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Extension(</span></span><br><span class="line"><span class="meta">        code = EXT_ORDER_LINE_CUSTOM_UNIT_PRICE,</span></span><br><span class="line"><span class="meta">        name = "Custom the Item's unit price of OrderLine",</span></span><br><span class="line"><span class="meta">        reduceType = ReduceType.FIRST</span></span><br><span class="line"><span class="meta">    )</span></span><br><span class="line">    Long <span class="title function_">getCustomUnitPrice</span><span class="params">(OrderLine orderLine)</span>;</span><br><span class="line">}</span><br><span class="line"></span><br><span class="line"><span class="meta">@Ability(name = "OrderLine's Price Ability")</span></span><br><span class="line"><span class="keyword">public</span> <span class="keyword">class</span> <span class="title class_">OrderLinePriceAbility</span></span><br><span class="line">        <span class="keyword">extends</span> <span class="title class_">BaseLatticeAbility</span>&lt;OrderLinePriceExt&gt; {</span><br><span class="line"></span><br><span class="line">    <span class="keyword">public</span> <span class="title function_">OrderLinePriceAbility</span><span class="params">(OrderLine orderLine)</span> {</span><br><span class="line">        <span class="built_in">super</span>(orderLine);</span><br><span class="line">    }</span><br><span class="line"></span><br><span class="line">    <span class="keyword">public</span> Long <span class="title function_">getCustomUnitPrice</span><span class="params">(OrderLine orderLine)</span> {</span><br><span class="line">        <span class="keyword">return</span> Optional.ofNullable(reduceExecute(</span><br><span class="line">                ext -&gt; ext.getCustomUnitPrice(orderLine),</span><br><span class="line">                Reducers.firstOf(Objects::nonNull)))</span><br><span class="line">            .orElse(orderLine.getUnitPrice());</span><br><span class="line">    }</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Override</span></span><br><span class="line">    <span class="keyword">public</span> BlankOrderLinePriceExt <span class="title function_">getDefaultRealization</span><span class="params">()</span> {</span><br><span class="line">        <span class="keyword">return</span> <span class="keyword">new</span> <span class="title class_">BlankOrderLinePriceExt</span>();</span><br><span class="line">    }</span><br><span class="line">}</span><br></pre></td></tr></tbody></table></div></figure><p>这种组织方式带来三个变化。第一，平台能力可以被发现，开发者不必在数千个应用中搜索零散 SPI。第二，默认行为仍然由平台提供，没有定制的业务自然回落到默认值。第三，扩展结果怎样归并不再由实现列表的偶然顺序决定，而是由能力定义的语义决定。</p><p>这里需要克制。Ability 不是把每个方法都包装一层的新名词。只有那些具有稳定业务语义、确实允许不同业务做出不同选择的行为，才值得成为能力或扩展点。否则，接口越多，平台并不会越灵活，只会多出另一套需要维护的表面积。</p><h2 id="在讨论两个维度之前，先回答什么是业务"><span class="section-no">13</span><a href="#在讨论两个维度之前，先回答什么是业务" class="headerlink" title="在讨论两个维度之前，先回答什么是业务"></a>在讨论两个维度之前，先回答什么是业务</h2><p>“业务”是一个很容易被泛化的词。有人把自己负责的任何工作都叫业务，也有人把业务直接等同于组织架构中的某个部门。为了让后面的模型可以落到代码上，本文需要一个更可操作的定义：<strong>业务是围绕产品或服务完成价值交付，并通过收入增长或成本下降形成可持续经营结果的一组活动、决策与规则。</strong></p><p>这个定义同时包含增收与降本。企业在组织上常把部门分为利润中心与成本中心：前者更多承担市场、产品、经营模式和产业链的创新，直接寻找收入与利润；后者更多通过平台复用、流程优化和效率提升降低成本。两者关注点不同，但最终都要回答同一个经营问题：如何让价值持续产生，并让收入与成本之间留下健康空间。</p><p>映射到软件平台，经营变化会稳定地形成两类规则。第一类规则通常围绕一个具体行业，描述这个行业如何定价、交易、履约和承担风险；它们共同组成一个完整经营模式。第二类规则来自与行业无关的通用玩法或平台能力，通过改变某一段交易方式，为多个行业增加销量、效率或用户价值。前者需要自治，后者需要复用；前者回答“这是哪个行业的生意”，后者回答“这个行业选择了哪些通用玩法”。</p><p>这就是垂直与水平两个维度的来源。它们不是为了画一张整齐的架构图而发明的分类，而是企业经营责任与平台复用方式在规则层面的投影。</p><h2 id="为什么业务会形成垂直与水平两个维度"><span class="section-no">14</span><a href="#为什么业务会形成垂直与水平两个维度" class="headerlink" title="为什么业务会形成垂直与水平两个维度"></a>为什么业务会形成垂直与水平两个维度</h2><p><strong>垂直业务通常就是行业。</strong> 它是一个拥有完整经营责任的业务空间，例如汽车金融、即时配送、电影票。它不仅拥有几个差异化配置，还要对这个行业里的客户、收入、履约、风险和最终经营结果负责。因此，垂直业务的规则必须彼此隔离：汽车金融的资格校验、预授权超时和无物流履约，不应该进入即时配送；即时配送的计价、配送范围与 SLA，也不应该成为电影票业务的默认规则。</p><p>即使两个垂直业务今天恰好把付款超时都设置为十分钟，也应在各自业务空间里独立声明。可以复用的是“付款超时”这项能力及其实现机制，而不是把一个业务做出的十分钟决策直接借给另一个业务。否则其中一个明天把配置改成十五分钟，另一个会在没有参与决策的情况下被改变。<strong>垂直维度解决的是所有权与隔离：一个经营主体的规则，不能因为代码相似就变成另一个经营主体的规则。</strong></p><p><strong>水平业务通常是与行业无关的通用玩法或平台。</strong> 它也可以称为平台业务或水平能力。它不拥有一套完整的行业经营模型，而是先把某种可以跨行业创造价值的玩法沉淀成可复用规则。例如，电子凭证的核心是发码、核销与退款，它并不关心使用者是电影票、景区门票还是汽车保养；营销活动可以改变不同行业的购买入口、价格与销量统计；货到付款可以改变不同行业的付款时点、收银台行为和现金零头处理。</p><p>水平业务的定义不依赖任何一个具体垂直业务，但它可以被许多垂直业务选择。电影票和汽车保养可以共同使用电子凭证，却选择不同的核销次数；一个业务可以同时安装电子凭证与预售，也可以再叠加营销活动。垂直业务愿意接受这些规则变化，是因为水平能力能够扩大可交易范围、促进成交、降低成本或改善体验。<strong>水平维度解决的是复用与增量：它不是替代垂直业务，而是对垂直业务基线的一组可选择修改。</strong></p><p>两类业务还有一个决定性的差异：<strong>垂直行业相对可数、稳定，水平玩法则开放、近乎不可穷举，而且变化频繁。</strong> 这里的“可数”与“不可数”不是集合论概念，而是工程上的稳定性判断。一个企业当前经营汽车金融、即时配送还是电影票，通常可以列出清单；新增一个行业意味着明确而低频的经营决策，因此适合获得长期稳定的业务身份。水平玩法却没有一张能够提前写完的清单：新的营销方式、履约方式、支付方式、会员权益与风控规则会持续出现，还会彼此组合。</p><p>如果把每一种“行业 × 水平玩法组合”都建模成一个新的业务类型，假设有 <code>|V|</code> 个垂直行业、<code>|H|</code> 个可独立选择的水平玩法，理论组合上限会接近 <code>|V| × 2^|H|</code>。每增加一个水平玩法，组合空间就可能翻倍。把这些组合写成继承层次、业务编码或全局 SPI 条件，只会让类型数量和判断分支一起爆炸。</p><p>Lattice 选择了相反的建模方向：把相对可数、稳定的垂直行业作为坐标原点和业务身份，再为这个身份选择 <code>N</code> 个开放变化的水平业务。一次请求先锚定唯一的垂直身份，获得它的默认规则与所有权边界；运行时再沿水平方向加载这个业务已经选择的能力与实现。新增一个水平玩法，相当于增加一列可选能力，不需要重新定义所有垂直行业；某个行业改变自己的选择，也不会改写其他行业的基线。<strong>稳定的身份承载开放的组合，这才使高频业务定制保持稳定。</strong></p><p>由此还可以推出两个边界。第一，如果一个流程跨越多个垂直行业，就应拆成多个带有明确身份的业务上下文协作，而不是让一条请求同时属于多个垂直空间。第二，在每个垂直基线上，可以选择零个、一个或多个水平能力，<code>N</code> 因而可以为零，也可以随着商业创新持续增长。</p><p>因此，一个业务真正生效的完整规则集可以表达为：</p><div class="equation"><p>完整业务规则集 = 1 个垂直业务基线 + N 个水平业务增量（N ≥ 0）</p></div><p>这里的“1”确立唯一、稳定的经营所有权与默认规则，“N”表达开放、可复用、可叠加的业务增强。它不是类继承关系，也不是把几份配置简单拼接在一起，而是一个有作用域、有顺序、有归并语义的稀疏组合：每个垂直业务只选择自己需要的那些水平能力。传统 SPI 只有一个扁平的全局实现列表；Lattice 则先确定垂直业务空间，再解析这个空间选择了哪些水平能力，最后处理它们在同一扩展点上的组合。</p><figure class="article-figure"><img src="/assets/articles/lattice-clean-architecture-practice/figure-03-business-lattice.webp?v=f8d92ca9286a3192" width="1672" height="941" loading="lazy" alt="多个彼此隔离的垂直业务与可跨业务复用的水平能力交织成规则网格，每个交点表示一个业务对能力的选择或定制"><figcaption><p><strong>图 3 · Lattice 的两个业务维度。</strong> 垂直业务保持经营规则的所有权与隔离，水平能力提供跨行业复用；一个交点不是全局条件偶然命中，而是某个垂直业务对一项水平能力的明确选择。</p></figcaption></figure><h2 id="Reduce-不替业务决策，却能让冲突显式"><span class="section-no">15</span><a href="#Reduce-不替业务决策，却能让冲突显式" class="headerlink" title="Reduce 不替业务决策，却能让冲突显式"></a>Reduce 不替业务决策，却能让冲突显式</h2><p>一旦完整规则被定义为“一个垂直基线 + N 个水平增量”，冲突就不再是偶发异常，而是组合模型必须正面回答的问题。多个水平能力可能修改同一个业务点，垂直基线也可能对这个点已有自己的判断。框架不仅要找到这些规则，还要说明它们能否共存，以及共存时怎样得到一个最终结果。</p><p>有些规则可以归并。例如可购买数量：垂直业务要求不能超过库存；电子凭证一次最多购买 250 份；某个营销活动限制为 10 件。这三条规则表达的是不同来源的上限，没有谁需要覆盖谁。取最小值即可让三者同时成立，因此适合 <code>MIN</code> 一类的 Reduce 策略。</p><p>另一些规则具有排他性。例如平台营销活动默认不统计销量，但某个垂直业务经过双方 Owner 协商，要求自己的销量规则优先。两个布尔结论不能通过取最小值或合并集合解决，这时需要显式的冲突优先级，说明究竟由垂直业务还是水平业务做最终决定。</p><p>所以，Lattice 对组合冲突的处理包含两个不同问题：<strong>Reduce 算法回答“多个结果如何归并”，冲突优先级回答“无法归并时谁拥有裁决权”。</strong> 前者可以取第一个非空值、合并集合、求最小值或执行其他有业务含义的算法；后者必须由相关业务 Owner 协商并声明。技术框架不能替业务负责人决定政策，但它可以要求这个决定被明确表达，而不是藏在实现注册顺序里。</p><div class="equation"><p>最终业务规则 = Reduce（垂直业务基线，水平业务增量 1…N，冲突优先级）</p></div><div class="table-wrap"><table><caption>从传统 SPI 到 Lattice 扩展调用</caption><thead><tr><th>维度</th><th>传统 SPI</th><th>Lattice</th></tr></thead><tbody><tr><td>实现归属</td><td>由 <code>filter</code> 间接推断</td><td>由业务身份显式声明</td></tr><tr><td>候选范围</td><td>全局实现列表</td><td>当前业务及其选定能力</td></tr><tr><td>多实现冲突</td><td>注册顺序或第一个命中</td><td>Reduce 与优先级策略</td></tr><tr><td>业务复用</td><td>复制实现或共享隐含条件</td><td>水平能力按业务组合</td></tr><tr><td>影响评估</td><td>阅读所有过滤逻辑</td><td>检查业务空间与组合关系</td></tr></tbody></table></div><h2 id="Use-Case-让架构重新说业务语言"><span class="section-no">16</span><a href="#Use-Case-让架构重新说业务语言" class="headerlink" title="Use Case 让架构重新说业务语言"></a>Use Case 让架构重新说业务语言</h2><p>能力解决的是可扩展行为怎样组织，但业务人员讨论的通常不是某个实体的某个方法，而是“买家下单”“卖家履约”“买家退款”这样的场景。《干净的架构》把 Use Case 放在实体之外：它引导数据在实体之间流动，编排实体完成一个特定应用目标。<sup class="ref"><a href="#ref-2">[2]</a></sup></p><p>这对交易平台特别重要。一个电子凭证场景会跨越订单、凭证、通知和核销等多个实体与系统；如果只开放实体级 SPI，业务仍然要自己拼出完整流程。Lattice 因此支持在用例层沉淀可复用业务资产，并按业务活动组织场景级 SDK。</p><p>以电子凭证为例，平台可以提供生成凭证、发码、核销、退款等完整场景能力，只把有真实差异的政策开放出来：</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="keyword">public</span> <span class="keyword">interface</span> <span class="title class_">ETicketTradeSDK</span> <span class="keyword">extends</span> <span class="title class_">IBusinessExt</span> {</span><br><span class="line">    <span class="meta">@Extension(reduceType = ReduceType.NONE)</span></span><br><span class="line">    Boolean <span class="title function_">isVoucherSupportMultiWriteOff</span><span class="params">()</span>;</span><br><span class="line">}</span><br></pre></td></tr></tbody></table></div></figure><p>电影票业务可以声明单次核销，包含十二次洗车的汽车保养套餐可以声明多次核销。业务开发者面对的是“凭证是否支持多次核销”这句业务语言，不必理解底层订单把它存在哪个 K/V 字段，也不必分别在每个应用里寻找技术扩展点。</p><p>场景层负责把有语义的规则映射到底层实体。例如电子凭证用例可以在订单保存时，把“是否允许多次核销”转换为订单属性。实体层只知道如何可靠保存属性，不需要知道电影票、洗车券或未来出现的新行业。依赖关系由场景指向实体，实体不会反向依赖具体场景，这正是依赖规则在业务扩展中的一次具体落地。</p><p>更重要的是，场景资产可以组合。一个电影票业务可以同时使用电子凭证与预售：电子凭证决定核销方式，预售决定定金比例。业务不是继承一个越来越庞大的“电影票平台”，而是在自己的业务空间里安装两个相对独立的场景能力。</p><h2 id="第三个分离：逻辑业务架构与物理应用架构"><span class="section-no">17</span><a href="#第三个分离：逻辑业务架构与物理应用架构" class="headerlink" title="第三个分离：逻辑业务架构与物理应用架构"></a>第三个分离：逻辑业务架构与物理应用架构</h2><p>前两个分离解决代码放在哪里、运行时进入哪个规则空间；Ability 与 Use Case 又补齐了描述业务能力和完整场景的语言。以此为基础，第三个分离解决的是设计者从哪里理解平台。传统平台按照物理应用开放扩展点：商品应用提供一组 SPI，购物车、交易、履约应用再各自提供一组。这样的目录忠实反映了系统怎样部署，却无法直接回答一个业务场景怎样完成。面对两千多个微服务，要求任何人先掌握应用拓扑再设计业务，本身就是不可能完成的影响分析。</p><p>Lattice 让平台通过 <code>@Ability</code>、<code>@Extension</code> 等注解显式声明能力、扩展点、默认行为和归并语义，也让 <code>@Business</code>、<code>@Realization</code> 声明业务及其实现归属。这些元数据可以由运行容器统一发现并上报到业务管理平台。上报后的组织单位不再是“某应用里的某个 Java 接口”，而是下单、履约、退款、核销等业务流程，以及流程中允许变化的业务政策。</p><p>业务人员或设计师由此可以从逻辑视图开始需求分析：沿着完整流程查看平台已经提供哪些能力、当前业务安装了哪些水平玩法、哪些扩展点已有实现、同一点采用什么 Reduce 策略。对本次需求能复用的部分，可以直接选择和组合；对感觉缺失的部分，可以形成一张具体的差距清单，再与平台设计者讨论是否应该增加一个稳定扩展点。沟通从“我猜某个系统可能要改”变成“这个业务步骤缺少哪项可复用政策”，平台能力的增强也就更有方向和节奏。</p><p>这套管理视图不能只是一个扁平的扩展点注册表。为了真正支持设计与影响评估，每个扩展点还需要保留业务语义、所属场景、输入输出、默认行为、Reduce 策略、Owner、版本兼容和当前使用方等信息；同时保留从逻辑节点追溯到物理应用、接口和运行实例的映射。<strong>逻辑架构与物理架构分离，不是把物理世界藏起来，而是不再让物理拓扑成为业务设计的起点。</strong></p><p>注解也不会自动产生正确的业务模型。如果平台把过细的内部方法全部上报，只会把两千多个服务换成另一张庞大的接口清单。平台设计者仍然要识别稳定业务语义、组织 Use Case 与 Ability，并为契约演进负责；Lattice 提供的是一条从代码声明、统一上报、业务设计到运行执行的闭环，而不是替代建模本身。</p><p>这也呼应了我对《干净的架构》中“框架是细节”的理解。Lattice 自己应该待在合适的位置：它提供业务身份解析、扩展调用、实现加载、元数据发现和结果归并机制，但真正有价值的业务规则仍然属于业务与用例。</p><figure class="article-figure"><img src="/assets/articles/lattice-clean-architecture-practice/figure-04-clean-boundaries.webp?v=b8bb1efb1d824116" width="1672" height="941" loading="lazy" alt="稳定实体与用例位于架构中心，业务插件和外部基础设施处在边界之外，所有依赖朝向内层业务政策"><figcaption><p><strong>图 4 · Lattice 在干净架构中的位置。</strong> Lattice 负责让外部业务插件越过稳定契约参与扩展，但依赖方向仍指向实体与用例；框架、数据库和插件都是机制，不应成为业务政策的中心。</p></figcaption></figure><h2 id="能在运行前确定的，不留给运行时猜"><span class="section-no">18</span><a href="#能在运行前确定的，不留给运行时猜" class="headerlink" title="能在运行前确定的，不留给运行时猜"></a>能在运行前确定的，不留给运行时猜</h2><p>传统 SPI 的很多风险来自运行时动态猜测：遍历所有实现、执行任意 <code>filter</code>，直到某个实现命中。结果依赖当时的数据、远程调用乃至实现顺序，影响范围难以提前说明。</p><p>Lattice 的设计倾向，是把业务使用哪些能力、规则如何叠加、发生冲突时如何裁决，尽可能在管理和配置阶段确定；运行时严格执行已经形成的业务规则与冲突策略。官方仓库也把“管理域与运行域分离”列为核心设计之一。<sup class="ref"><a href="#ref-3">[3]</a></sup></p><p>这并不意味着业务运行时没有动态条件，而是要区分两类信息：<strong>哪些规则属于这个业务</strong> 应该尽量静态、可见、可审计；至于规则如何处理本次订单，才根据运行数据计算。前者不应每次请求都重新猜测。</p><p>当组合关系能够在运行前呈现，产品和开发才有机会共同做影响分析：当前业务安装了哪些场景，覆盖了哪些扩展点，同一个点有哪些实现，使用什么 Reduce 策略。架构从只存在于代码阅读者脑中，变成可以被管理的业务模型。</p><p class="part-label">第四部分 · 从一个最小样例看完整闭环</p><h2 id="业务-A-定制价格，业务-B-保持默认"><span class="section-no">19</span><a href="#业务-A-定制价格，业务-B-保持默认" class="headerlink" title="业务 A 定制价格，业务 B 保持默认"></a>业务 A 定制价格，业务 B 保持默认</h2><p>Lattice 的最小闭环并不复杂。平台定义“自定义订单明细单价”扩展点与价格能力；业务 A 声明自己的业务身份，并实现该扩展点返回 <code>2000L</code>；业务 B 不做定制。两次调用的订单默认单价都是 <code>1000L</code>。</p><figure class="highlight java"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line"><span class="type">OrderLine</span> <span class="variable">orderLine</span> <span class="operator">=</span> <span class="keyword">new</span> <span class="title class_">OrderLine</span>();</span><br><span class="line">orderLine.setUnitPrice(<span class="number">1000L</span>);</span><br><span class="line">orderLine.setBizCode(<span class="string">"business.a"</span>);</span><br><span class="line"></span><br><span class="line"><span class="type">OrderLinePriceAbility</span> <span class="variable">ability</span> <span class="operator">=</span> <span class="keyword">new</span> <span class="title class_">OrderLinePriceAbility</span>(orderLine);</span><br><span class="line"><span class="type">Long</span> <span class="variable">unitPrice</span> <span class="operator">=</span> ability.getCustomUnitPrice(orderLine);</span><br></pre></td></tr></tbody></table></div></figure><p>业务 A 的结果是 <code>2000L</code>，业务 B 的结果仍是 <code>1000L</code>。这个例子看起来像普通的策略模式，但关键差异在于：实现由业务身份定位，默认策略由能力管理，调用结果按扩展点契约归并。完整 Quick Start 与更多场景样例可以在 <a href="https://github.com/hiforce/lattice-sample">lattice-sample</a> 中查看。<sup class="ref"><a href="#ref-4">[4]</a></sup></p><p>本文最近一次更新时，sample 仓库主分支仍把 Lattice 依赖设为 <code>1.0.19</code>。我将其临时切换到 <code>1.0.21</code> 后，重新编译了 Quick Start 与 Use Case 两个模块；两者均通过，下面电子凭证叠加预售的控制台结果也由 <code>1.0.21</code> 实际运行得到。这个验证很朴素，却能避免长文里的代码只停留在“看起来合理”。</p><p>当扩展规模从两个实现增长到成百上千时，这些“多出来的概念”才显示价值。它们为每一段变化补齐了过去缺失的信息：属于哪个业务、扩展哪种能力、以什么方式组合、没有实现时如何回退。</p><h2 id="电子凭证叠加预售"><span class="section-no">20</span><a href="#电子凭证叠加预售" class="headerlink" title="电子凭证叠加预售"></a>电子凭证叠加预售</h2><p>再回到更接近真实业务的组合。电影票业务安装电子凭证场景，声明凭证只允许单次核销；同时安装预售场景，声明定金比例为 40%。下单用例调用两个场景能力，并将需要持久化的业务信息映射到订单实体。</p><figure class="highlight text"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line">[UseCase]PreSaleTrade load custom down payment ratio: .40</span><br><span class="line">[UseCase]ETicketTrade is support multiple write-off: false</span><br><span class="line">Save OrderLine id: 1, bizCode: hi.movie</span><br><span class="line">-- Total Pay Price: 4000</span><br><span class="line">-- Order Attributes: [e_multi_write_off:0]</span><br></pre></td></tr></tbody></table></div></figure><p>这段输出背后有四层清晰分工：业务插件声明电影票的差异；预售和电子凭证用例封装可复用场景；订单实体负责稳定的数据与生命周期；Lattice 运行时根据业务身份连接实现，并归并扩展结果。</p><p>如果未来增加汽车保养业务，它可以复用同一个电子凭证场景，只把核销方式改成多次；如果又使用预售，也可以独立配置定金比例。原有电影票规则不需要修改，新业务也不用加入一个全局 SPI 排序队列。</p><h2 id="问题与解法的完整对应"><span class="section-no">21</span><a href="#问题与解法的完整对应" class="headerlink" title="问题与解法的完整对应"></a>问题与解法的完整对应</h2><div class="table-wrap"><table><caption>Lattice 对平台挑战的逐项回应</caption><thead><tr><th>当年的挑战</th><th>Lattice 的机制</th><th>直接改变</th></tr></thead><tbody><tr><td>业务与平台代码纠缠</td><td>业务插件、独立代码边界</td><td>定制逻辑不进入平台核心</td></tr><tr><td>业务之间互相影响</td><td>统一业务身份</td><td>实现先按业务空间隔离</td></tr><tr><td>扩展点散落在应用中</td><td>Ability 与场景级 SDK</td><td>从应用语言回到业务语言</td></tr><tr><td>业务流程被物理拓扑切碎</td><td>注解元数据、统一上报与管理视图</td><td>按完整场景发现能力并形成差距清单</td></tr><tr><td>水平能力难以复用</td><td>垂直业务 + 水平能力组合</td><td>场景资产可选择、可叠加</td></tr><tr><td>多实现顺序决定结果</td><td>Reduce 与冲突优先级</td><td>组合语义由契约明确表达</td></tr><tr><td>运行时过滤难以评估</td><td>管理决策与运行执行分离</td><td>组合关系可提前检查</td></tr><tr><td>统一发布、全网回归</td><td>插件加载与发布边界</td><td>为业务独立交付创造条件</td></tr></tbody></table></div><p>这张表也是全文最想保留的部分。一个框架是否值得采用，不应先看它有多少注解和扩展策略，而应看每个机制是否对应一个真实且反复出现的问题。</p><p class="part-label">第五部分 · 重读之后，我更在意 Lattice 的边界</p><h2 id="Lattice-没有消灭业务复杂性"><span class="section-no">22</span><a href="#Lattice-没有消灭业务复杂性" class="headerlink" title="Lattice 没有消灭业务复杂性"></a>Lattice 没有消灭业务复杂性</h2><p>《干净的架构》容易被误读成只要分层正确，系统就会自然保持整洁；扩展框架也容易被误读成只要插件化，任何业务都可以零成本定制。我现在更愿意强调相反的一面：Lattice 不会消灭业务复杂性，它只是尝试让复杂性各归其位。</p><p>垂直业务之间是否应该隔离，需要业务建模判断；一个水平能力是否值得复用，需要真实场景验证；两个规则冲突时谁优先，仍然需要 Owner 做出决定；一个扩展点设计得太细、太底层，业务团队照样会陷入技术细节。框架能把决定显式化，却不能替人做出正确决定。</p><p>有几类误用尤其值得警惕：</p><ul><li><strong>把所有方法都开放为扩展点。</strong> 这会暴露平台内部结构，使契约数量失控。</li><li><strong>用业务编码替代领域建模。</strong> <code>bizCode</code> 解决作用域，不负责解释业务本身。</li><li><strong>把 Reduce 当成冲突逃生舱。</strong> 没有业务语义的归并算法，只会掩盖规则矛盾。</li><li><strong>只有运行时，没有管理视图。</strong> 如果没人能看见当前组合，影响评估仍然困难。</li><li><strong>插件物理分离，数据仍然强耦合。</strong> 代码边界不能自动解决共享数据与接口演进。</li></ul><p>因此，使用 Lattice 之前，我会先问三个问题：这是否是一个稳定、可命名的业务差异点？它的所有者和作用范围是否清楚？两个实现同时生效时，是否存在可解释的组合语义？如果三个问题都答不出来，先增加一个扩展点通常只是在推迟建模。</p><h2 id="重读《干净的架构》后，我留下的七条工程判断"><span class="section-no">23</span><a href="#重读《干净的架构》后，我留下的七条工程判断" class="headerlink" title="重读《干净的架构》后，我留下的七条工程判断"></a>重读《干净的架构》后，我留下的七条工程判断</h2><p>多年后再回看这段实践，我不再把读书体会停在“实体、用例、适配器应该放在哪一层”。同心圆、模块名和接口都只是表达，真正要检验的是变化成本：加入一个新业务需要多少不相关团队参与，多少既有业务必须回归，错误能否停在清楚的范围内，未来是否仍保留替换机制和部署方式的选择权。</p><p>把这些理解与 Lattice 的实践放在一起，我最终留下七条工程判断。它们不是前文之外突然出现的第二套总结，而是把业务身份、Use Case、Reduce、插件边界和管理视图压缩成一张可以用于设计评审的检查表。</p><div class="principles"><div class="principle"><strong>01 · 用变化总成本检验架构</strong> — 不以层数和接口数量证明先进，而看一次变化需要惊动谁、回归谁，故障能否被限制。</div><div class="principle"><strong>02 · 先划作用域，再做扩展</strong> — 明确规则属于哪个业务，不让全局过滤器替代所有权。</div><div class="principle"><strong>03 · 先说业务语言，再定技术接口</strong> — 用 Use Case 与稳定政策组织代码，而不是把物理应用步骤直接暴露成契约。</div><div class="principle"><strong>04 · 组合必须有语义</strong> — 多个实现同时生效时，Reduce、顺序与冲突优先级必须成为契约的一部分。</div><div class="principle"><strong>05 · 逻辑边界要有物理支撑</strong> — 仓库、插件、测试与发布方式应尽量对齐；独立构建和验证是边界是否真实的压力测试。</div><div class="principle"><strong>06 · 业务设计先于应用拓扑，管理决策先于运行猜测</strong> — 先按流程发现和审计能力，再追溯到应用；能提前确定的组合，不留给每次请求重新判断。</div><div class="principle"><strong>07 · 框架永远是细节，并为未来保留选择权</strong> — Lattice 服务业务规则；稳定核心政策，把机制、插件和部署形态留在可替换的外层。</div></div><p>第一条说明架构最终要优化什么，第二到第六条说明变化应该经过哪些边界，第七条提醒我们不要让解决方案本身反过来支配业务。到这里，这些判断仍然主要依赖人去阅读和记忆。进入 AI 编程时代，下一步是让它们成为编码代理每次动手前都会执行的工作流。</p><h2 id="从交易平台到-Spark：在-AI-编程时代把架构做成-Skill"><span class="section-no">24</span><a href="#从交易平台到-Spark：在-AI-编程时代把架构做成-Skill" class="headerlink" title="从交易平台到 Spark：在 AI 编程时代把架构做成 Skill"></a>从交易平台到 Spark：在 AI 编程时代把架构做成 Skill</h2><p>交易平台的经历告诉我边界为何重要，后来在 Spark 的实践则让我面对一个更现实的问题：AI 可以在几分钟内跨模块生成大量代码，但它看到的通常是当前任务和附近文件，不会天然知道一个仓库多年形成的依赖方向、模块责任和失败教训。只在提示词里说一句“请遵循干净架构”，得到的往往仍是局部正确、整体越界的实现。</p><p>所以，我开始把架构知识分成四层。<code>docs/principle/01.clean_architect_with_lattice.md</code> 保存完整背景，解释为什么需要这些边界；<code>docs/principle/02.ai-clean-architecture-lattice-guidelines.md</code> 把背景压缩成可以检查的放置规则、Session Scope 规则和 Process / Activity / Result 规则；仓库根目录的 <code>AGENTS.md</code> 负责说明哪些任务必须先读取它们；架构 Skill 则把“读取—审视—设计—编码—复核”变成 AI 必须执行的步骤。</p><div class="table-wrap"><table><caption>从架构知识到 AI 编码约束</caption><thead><tr><th>层次</th><th>作用</th><th>回答的问题</th></tr></thead><tbody><tr><td>背景原则</td><td>保存案例、推理与取舍</td><td>为什么要这样设计？</td></tr><tr><td>可执行规则</td><td>列出允许、禁止与检查项</td><td>什么代码可以放在哪里？</td></tr><tr><td>仓库触发规则</td><td>根据任务类型要求 AI 先读指定原则</td><td>什么时候必须进行架构审视？</td></tr><tr><td>架构 Skill</td><td>固化审视顺序和输出格式</td><td>AI 在写代码前后必须做什么？</td></tr></tbody></table></div><p>Skill 不是架构真相的唯一副本。长期规则仍应留在仓库中，让 Codex、Claude 以及人类开发者都能读取；Skill 更像一个执行适配器，负责在合适时机加载这些事实，并阻止 AI 跳过架构设计直接生成代码。根据 Spark 的真实规则裁剪后，它的核心可以写成下面这样：</p><figure class="highlight markdown"><div class="table-wrap"><table><tbody><tr><td class="code"><pre><span class="line">---</span><br><span class="line">name: spark-clean-architecture-review</span><br><span class="line"><span class="section">description: 在 Spark 后端设计、模块调整或 Lattice 扩展开发前执行架构审视。</span></span><br><span class="line"><span class="section">---</span></span><br><span class="line"></span><br><span class="line"><span class="section"># Workflow</span></span><br><span class="line"><span class="bullet">1.</span> 先判断变更属于 Entity、Use Case、Adapter 还是 Plugin。</span><br><span class="line"><span class="bullet">2.</span> 给出模块、包路径和依赖方向；SDK 中禁止出现 DO、Repository 和插件客户端。</span><br><span class="line"><span class="bullet">3.</span> 如果平台主流程按集群、语言或云厂商增加 if/switch，改为稳定业务身份和插件实现。</span><br><span class="line"><span class="bullet">4.</span> 在场景入口只建立一次 Session Scope，内部 Process 和 Activity 继续传递同一身份。</span><br><span class="line"><span class="bullet">5.</span> 复杂 Use Case 使用统一 Request / Result；副作用收口到 Process 末端。</span><br><span class="line"></span><br><span class="line"><span class="section"># Required output</span></span><br><span class="line"><span class="bullet">-</span> 业务身份与作用域入口</span><br><span class="line"><span class="bullet">-</span> 模块划分与依赖方向</span><br><span class="line"><span class="bullet">-</span> Ability / Extension / Reduce 设计</span><br><span class="line"><span class="bullet">-</span> Use Case / Process / Activity / Result 设计</span><br><span class="line"><span class="bullet">-</span> 违反规则的现有代码与验证计划</span><br></pre></td></tr></tbody></table></div></figure><p>真正使用时，我不会直接对 AI 说“帮我把功能写完”，而是先让 Skill 迫使它给出架构答案。例如，要为 Spark 增加 Kubernetes 上的 Python 构建能力，对话可以是这样：</p><blockquote><p><strong>我：</strong> 为 Spark Flow 增加 Kubernetes Python 构建能力。先执行架构 Skill，不要写代码；给出业务身份、模块边界、依赖方向、扩展点和验证方案。</p><p><strong>AI：</strong> 业务身份使用 <code>build.k8s.python</code>。稳定 Context、Result、Extension、Ability 与默认实现进入 <code>spark-console-sdk</code>；构建流程编排留在 <code>spark-pipeline</code>；Kubernetes Python 的具体实现进入 <code>spark-k8s-plugin</code>。插件只接收平台准备的源码、构建参数和凭据引用，通过 Result / Observation 返回镜像、日志与状态，不读取平台业务表。场景入口建立一次 Session Scope，Pipeline 内部不再按 <code>PYTHON</code> 增加分支。</p><p><strong>我：</strong> 先检查这个划分是否违反依赖规则；通过后再按模块逐步编码，每完成一层都报告对应规则和测试证据。</p><p><strong>AI：</strong> 我会依次完成 SDK 叶子扩展契约与默认实现、Ability、插件 <code>@Realization</code>、平台调用与测试；提交前再次检查平台是否依赖插件、SDK 是否混入实现对象、内部是否重复识别业务身份。</p></blockquote><p>这段对话最重要的不是 AI 是否准确说出了几个模块名，而是它被要求在写代码前先暴露自己的架构模型。人可以在成本最低的时候纠正业务身份、模块归属和依赖方向，而不是等几千行代码生成后再做结构性返工。代码写完后，同一个 Skill 还要反向审计实现：Controller 是否偷偷承担了编排，SDK 是否混入 DO，插件是否绕过 Context 读库，Session Scope 是否在内部被重复打开，Activity 是否各自写数据库和索引。</p><p>对于创建任务、任务流转、批量操作这类复杂场景，Skill 还会要求 AI 先定义统一 Request 与 Result，再由 Process 编排多个 Activity。每个 Activity 只把校验、权限、分配、持久化计划和事件计划累积到同一个 Result，最后在流程末端统一完成数据库、索引和事件副作用。这样，AI 生成的不只是“能运行的若干类”，而是一条仍然保持概念完整性的 Use Case。</p><figure class="article-figure"><img src="/assets/articles/lattice-clean-architecture-practice/figure-05-executable-principles.webp?v=404ea1f6087c6aef" width="1672" height="941" loading="lazy" alt="架构 Skill 先审视业务身份、模块边界和依赖方向，再约束 AI 将一个用例编排为共享统一结果的活动链，并在流程末端产生受控副作用"><figcaption><p><strong>图 5 · 当架构原则成为 AI 编程的执行规则。</strong> 背景文档保存原因，可执行规则提供约束，Skill 在编码前输出架构方案、在编码后审计越界；身份在入口确定，活动共享统一 Result，插件通过契约交换材料，副作用在流程末端收口。</p></figcaption></figure><p>这改变了我对架构文档的看法。过去，文档常常是代码完成后的解释；AI 编程时代的架构文档既是知识，也是控制输入。它需要同时包含原因、允许项、禁止项、触发条件和验证证据。AI 不会自动带来干净架构，但它给了我们一个机会：把过去依赖资深工程师口口相传的判断，变成每一次设计和编码都可重复执行的架构审视。</p><p>从这个角度看，Lattice 的价值也不只是在运行时找到一个扩展实现。业务身份、Context、Result、Ability 与插件契约共同构成了一种人和 AI 都能理解的变化协议：谁可以改变什么，代码应该放在哪里，通过什么材料进入，返回什么证据，影响应该止于哪里。</p><h2 id="结语：让变化停在它应该停下的地方"><span class="section-no">25</span><a href="#结语：让变化停在它应该停下的地方" class="headerlink" title="结语：让变化停在它应该停下的地方"></a>结语：让变化停在它应该停下的地方</h2><p>2015 年我面对的交易平台，技术上并不缺少接口、服务和扩展机制。真正稀缺的是边界：业务与平台的边界，业务与业务的边界，逻辑业务流程与物理应用拓扑的边界，静态决策与运行执行的边界。</p><p>没有这些边界，增加 API 会产生更多上下文参数，增加 SPI 会产生更大的全局实现树，拆出更多应用会产生更重的协调。每一种局部正确的技术，都会在规模扩大后把成本转移到别处。</p><p>Lattice 的出发点，是把这些被转移、被隐藏的成本重新放到架构里：用业务插件分开业务与平台，用业务身份分开业务与业务，用注解上报和管理视图分开逻辑架构与物理拓扑；再以 Ability 组织可扩展行为，以垂直与水平两个维度表达隔离和复用，用 Reduce 说明规则怎样组合，用 Use Case 恢复完整业务语言。三个分离建立边界，后面的机制则让边界可以被设计、执行和验证。</p><p>重读《干净的架构》后，我更确定这件事的价值不在于创造了多少概念。好的架构并不承诺业务从此不再复杂；它只是让一个新变化到来时，我们能说清楚它属于哪里、依赖什么、会影响谁，以及应该在哪里停下来。</p><p>在 AI 也参与设计和编码的今天，这些边界不能只存在于少数人的经验里。它们需要同时成为仓库中的知识、Skill 中的执行步骤和交付前的验证证据，才能在代码生成速度不断提高时，仍然守住变化的方向。</p><p>这也是我理解的“干净”：不是没有变化，而是变化不再四处流淌。</p><section class="references" id="references"><h2 data-no-number="true">参考资料与延伸阅读</h2><ol><li id="ref-1">Robert C. Martin. <a href="https://www.informit.com/store/clean-architecture-a-craftsmans-guide-to-software-structure-9780134494319"><em>Clean Architecture: A Craftsman’s Guide to Software Structure and Design</em></a>. Pearson / Addison-Wesley, 2017.</li><li id="ref-2">Robert C. Martin. “<a href="https://www.informit.com/articles/article.aspx?p=2832399">The Clean Architecture Dependency Rule</a>.” <em>InformIT</em>, 2017.</li><li id="ref-3">HiForce. “<a href="https://github.com/hiforce/lattice">Lattice Framework</a>.” GitHub；本文最近一次更新时主分支 <code>pom.xml</code> 版本为 <code>1.0.21</code>。</li><li id="ref-4">HiForce. “<a href="https://github.com/hiforce/lattice-sample">Lattice Sample</a>.” GitHub，包含 Quick Start、Use Case 与多能力组合样例。</li><li id="ref-5">HiForce. “<a href="https://github.com/hiforce/lattice-clean-arch-practice-sample">Lattice Clean Architecture Practice Sample</a>.” GitHub，展示实体、用例、接口适配器与业务插件的工程组织。</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/lattice-clean-architecture-practice/</id>
    <link href="https://ryu.xin/zh/posts/lattice-clean-architecture-practice/"/>
    <published>2026-03-15T16:00:00.000Z</published>
    <summary>从 2015 年 A 公司交易平台的真实问题出发，复盘 Lattice 如何解决大规模业务定制，并在 AI 编程时代把架构原则变成可执行 Skill。</summary>
    <title>让商业创新更敏捷：Lattice 与《干净的架构》的工程实践</title>
    <updated>2026-08-01T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>Rocky Yu</name>
    </author>
    <category term="组织" scheme="https://ryu.xin/zh/categories/organizations/"/>
    <category term="Software Engineering" scheme="https://ryu.xin/zh/tags/Software-Engineering/"/>
    <category term="Career" scheme="https://ryu.xin/zh/tags/Career/"/>
    <category term="Leadership" scheme="https://ryu.xin/zh/tags/Leadership/"/>
    <content>
      <![CDATA[<header class="abstract"><h2 data-no-number="true">摘要</h2><p>这篇文章最初写于 2018 年 4 月。那时我在阿里巴巴带一个技术团队，刚好在做年度绩效沟通。几位同学不约而同地问起晋升、技术影响力和未来方向，我也因此第一次认真尝试回答：一个技术人，究竟应该用什么衡量自己的成长？</p><p>八年足够让一套热门技术栈变成时代注脚，也足够让当年一本正经写下的职业建议出现一些“版本兼容性问题”。今天再看，文中的年限划分、Java 书单和组织视角都未必还跟得上时代。这次重新整理，我保留了 2018 年的立场和语境，只让语言更自然、结构更清楚，并删除已经失效的链接；它不是用今天的答案改写过去。</p><p>至于 AI 已经进入日常开发之后，技术人的成长又该如何衡量——这显然值得另写一篇。等这篇旧文安顿好，我会再用今天的经验，认真回答一次同样的问题。</p></header><p class="thesis">晋升是一种组织结果，却不是职业成长唯一的刻度。真正值得长期衡量的，是你能解决什么问题、能够影响谁、能否让团队更容易成功，以及在复杂和不确定面前是否形成了自己的判断。</p><p class="part-label">第一部分 · 晋升之外，我们还需要一把尺子</p><h2 id="一次绩效沟通里，大家真正想问的是什么"><span class="section-no">01</span><a href="#一次绩效沟通里，大家真正想问的是什么" class="headerlink" title="一次绩效沟通里，大家真正想问的是什么"></a>一次绩效沟通里，大家真正想问的是什么</h2><p class="lead dropcap">音乐剧《吉屋出租》提出过一个很动人的问题：人的一年应该怎样衡量？用时间、旅程，还是那些真正重要的时刻？到了职场，我们给出的答案往往现实得多——用薪资、职级和晋升。</p><p>2018 年做年度绩效沟通时，我和团队里的几位同学聊到了职业发展。有人希望继续在技术方向积累，有人想尝试管理，也有人希望自己的技术判断能被更多人采用，能够真正影响一个产品或一群人。</p><p>他们说的方向各不相同，语气里却有一种相似的焦虑：我怎么知道自己正在进步？如果今年没有晋升，这一年是不是就算不上成功？</p><p>于是我没有立即给建议，而是反过来问了几个问题：</p><ul><li>你说想继续积累技术，具体想往哪里走？一年以后，希望自己能做到什么现在做不到的事？</li><li>你希望拥有技术影响力，那么这种影响力从哪里来？一定要先得到一个岗位任命吗？</li><li>如果今年没有晋升，但你独立解决了过去解决不了的问题，这算不算成长？</li><li>如果明年晋升了，却只是更熟练地重复同样的工作，这又算不算成功？</li></ul><p>谈话忽然安静下来。并不是大家没有上进心，而是除了晋升，很少有人认真建立过另一套可以观察、记录和解释成长的尺度。</p><h2 id="晋升是一枚迟到的印章，不是一把每天可用的尺子"><span class="section-no">02</span><a href="#晋升是一枚迟到的印章，不是一把每天可用的尺子" class="headerlink" title="晋升是一枚迟到的印章，不是一把每天可用的尺子"></a>晋升是一枚迟到的印章，不是一把每天可用的尺子</h2><p>晋升当然重要。它意味着组织认可，也会带来更大的职责、更好的回报和新的机会。但晋升通常是许多因素共同作用后的结果：岗位是否空缺、团队结构是否变化、业务是否处在上升期，以及一个人的能力是否已经被持续看见。它天然有延迟，也不完全由个人控制。</p><p>如果把全部成就感都押在这一个结果上，职业生活就会变成一段很长的等待。平时做成的事情似乎都不算数，只有宣布结果的那一天才像真正发生了什么。</p><p>更可持续的方式，是把晋升看作一枚迟到的印章：它可以确认一段成长，却不负责制造成长。日常真正值得记录的，可能是第一次把一个模糊需求说清楚，第一次独立处理线上事故，第一次让一项设计被团队理解并长期采用，也可能是第一次承认自己的方案错了，然后带着大家把它改回来。</p><div class="callout"><p><strong>一份更诚实的成就清单。</strong> 这一年，我是否扩大了解决问题的范围？是否留下了可复用的代码、方法或知识？是否帮助过别人做出更好的判断？是否能对一个结果负责，而不仅是完成分配给我的任务？</p></div><p class="part-label">第二部分 · 先把自己练成可靠的职业人</p><h2 id="头三到五年，成长往往发生得很响亮"><span class="section-no">03</span><a href="#头三到五年，成长往往发生得很响亮" class="headerlink" title="头三到五年，成长往往发生得很响亮"></a>头三到五年，成长往往发生得很响亮</h2><p>刚开始做 Java 应用开发时，进步是很容易被听见的。昨天还看不懂的异常栈，今天突然知道该从哪一层查起；第一次把代码部署到生产，第一次遇到数据库慢查询，第一次发现“能运行”和“写得好”原来是两回事。几乎每隔一段时间，都会有一个清晰的“原来如此”。</p><p>从校园里的新手变成一个可以被信任的职业人，通常需要几年的学习和真实项目历练。当时我粗略地把毕业后的头三到五年称为第一阶段。这个阶段最重要的，不是尽快获得一个漂亮头衔，而是建立一套足够扎实的基本功。</p><div class="table-wrap"><table><caption>第一阶段需要逐步补齐的四层基本功</caption><thead><tr><th>层次</th><th>要解决的问题</th><th>当时常见的学习入口</th></tr></thead><tbody><tr><td>语言与代码</td><td>能否写出正确、清晰、便于修改的程序</td><td>Java 基础、Effective Java、重构、代码质量</td></tr><tr><td>框架与数据</td><td>能否理解应用真正如何运行</td><td>Spring、Hibernate、数据库、缓存、NoSQL、日志</td></tr><tr><td>设计与算法</td><td>能否越过局部实现，看见结构与约束</td><td>设计模式、面向对象分析、UML、算法与系统设计</td></tr><tr><td>工程习惯</td><td>能否持续交付，而不是偶尔灵光一现</td><td>调试、测试、代码评审、文档、生产问题复盘</td></tr></tbody></table></div><p>这份清单带着非常明显的 2018 年痕迹。那时 SSH 仍是很多 Java 项目的共同语言，遇到问题会在官方文档、技术博客和 Stack Overflow 之间来回搜索。但清单背后的意思并没有那么依赖具体技术：你需要把一门手艺练到足以应付现实，而不是只够完成教程里的例子。</p><h2 id="最先需要学会管理的资源，是自己"><span class="section-no">04</span><a href="#最先需要学会管理的资源，是自己" class="headerlink" title="最先需要学会管理的资源，是自己"></a>最先需要学会管理的资源，是自己</h2><p>在这个阶段，天赋带来的差距常常没有想象中那么不可追赶。有人毕业三年已经承担复杂项目，有人需要五六年才到达相近的位置。两三年的差距看起来很大，放到一段更长的职业生涯里，却经常可以通过有针对性的学习、足够困难的项目和持续复盘慢慢补上。</p><p>真正拉开差距的，往往不是谁更早知道某个框架的 API，而是谁能稳定地管理自己：答应的事情能否按质量完成，遇到陌生问题会不会主动补课，项目结束后是否把经验留下来，同一种错误是否还会反复发生。</p><p>有人会严格执行学习计划；有人恰好较早进入一个痛苦但重要的项目，被迫在压力里完成成长；也有人并不显眼，却一直把每一次交付做得比上一次更扎实。路径可以不同，共同点是他们没有把自己当成等待组织安排的零件，而是当成一项需要长期经营的专业能力。</p><figure class="article-figure"><img src="/assets/articles/measuring-a-programmers-year/figure-01-building-the-craft.webp?v=bb54fd7424a36396" width="1672" height="941" loading="lazy" alt="一名年轻工程师在安静的工作台前组装软件模块，散乱零件逐渐形成稳定结构，书籍、工具和测试装置环绕在周围"><figcaption><p><strong>图 1 · 把手艺练到可以被信任。</strong> 第一阶段的成长并不神秘：学习、实践、犯错、修正，再把偶然完成变成稳定交付。真正的分水岭，是能否逐渐成为那个“事情交给他会有结果”的人。</p></figcaption></figure><div class="pullquote"><p>职业生涯最初的杠杆，常常不是管理更多人，而是先学会可靠地管理自己的时间、注意力、承诺和学习。</p></div><p class="part-label">第三部分 · 从个人产出走向团队结果</p><h2 id="工作十年，经验不会自动变成能力"><span class="section-no">05</span><a href="#工作十年，经验不会自动变成能力" class="headerlink" title="工作十年，经验不会自动变成能力"></a>工作十年，经验不会自动变成能力</h2><p>到了毕业五到十年这个阶段，很多人的不安会换一种形式出现。技术继续更新，更年轻的同事不断加入，自己已经很熟练，却隐约感觉仅靠熟练还不够。三十多岁时常被讨论的“竞争力问题”，表面上像年龄焦虑，背后其实是组织对资深专业人员的期待已经发生变化。</p><p>一个刚入行的工程师，首先需要证明自己能够完成任务。一个有多年经验的人，则会被追问更多：你能否定义任务？能否在信息不完整时做取舍？能否发现团队正在解决错误的问题？当结果不好时，你能否承担责任并组织修正？</p><p>年限只会让经历变多，不会自动把经历加工成判断。十年里做过十类不同的问题，与把同一个熟悉问题重复十年，虽然简历上的数字相同，形成的能力可能完全不同。</p><h2 id="影响力不是一纸任命"><span class="section-no">06</span><a href="#影响力不是一纸任命" class="headerlink" title="影响力不是一纸任命"></a>影响力不是一纸任命</h2><p>当年团队里有同学说，希望自己能够做技术决策、影响更多人。我问他：是不是一定要先得到一个架构师或技术负责人的任命，才可能拥有影响力？</p><p>岗位会赋予决策权，却不会自动赋予可信度。真正持久的技术影响力，通常来自更朴素的积累：你是否比别人更早看见风险，能否把复杂问题解释清楚，提出的方案是否经得住运行，出了问题是否愿意站出来修正。团队愿意听取一个人的意见，常常不是因为他的名片，而是因为过去几次关键判断没有辜负大家的信任。</p><p>影响力也不只是“让别人接受我的方案”。更成熟的影响，是让一群人拥有更好的共同判断：把隐含知识写下来，把设计原则讲清楚，让不同意见安全地出现，帮助年轻同事理解为什么，而不是只告诉他们怎么做。</p><h2 id="团队负责人必须看见代码之外的世界"><span class="section-no">07</span><a href="#团队负责人必须看见代码之外的世界" class="headerlink" title="团队负责人必须看见代码之外的世界"></a>团队负责人必须看见代码之外的世界</h2><p>在 2018 年的文章里，我把第二阶段的人称为“团队贡献者”。他可能是带人的 TL，也可能是不直接管理人的架构师或资深工程师。共同之处是，他的价值不再只等于自己完成了多少代码，而在于能否让一组人围绕正确的问题产生可靠结果。</p><p>这意味着视线必须越过代码仓库。一个负责人至少要逐步理解四个方向：</p><div class="table-wrap"><table><caption>从个人贡献走向团队结果</caption><thead><tr><th>方向</th><th>需要回答的问题</th><th>能力表现</th></tr></thead><tbody><tr><td>业务与市场</td><td>我们所在的领域如何变化，真正的约束是什么</td><td>洞察、取舍、业务规划</td></tr><tr><td>客户与用户</td><td>谁在使用结果，他们为什么痛苦</td><td>需求发现、同理心、问题定义</td></tr><tr><td>团队与组织</td><td>怎样让不同角色理解同一件事并一起完成</td><td>沟通、协作、资源争取、人才发展</td></tr><tr><td>技术与交付</td><td>怎样把业务意图变成可演进、可运行的系统</td><td>建模、架构、项目管理、质量控制</td></tr></tbody></table></div><p>你可能需要向老板或投资人解释一个尚不确定的方向，争取资金和人；也可能需要把市场变化和客户痛点转成产品、设计和技术都能理解的模型。业务设计完成后，还要带领团队经历技术方案、接口设计、编码、测试和上线。任何一层说不清楚，压力最终都会以返工、冲突或事故的形式回到团队。</p><p>从经营视角看，管理者当然要关心团队创造的价值是否配得上组织投入。但人不是一行成本数字，价值也不只发生在一个季度。真正困难的是同时守住短期结果、长期能力与团队健康，而不是简单地催促每个人产出更多。</p><figure class="article-figure"><img src="/assets/articles/measuring-a-programmers-year/figure-02-expanding-responsibility.webp?v=e50bb5276b8d1650" width="1672" height="941" loading="lazy" alt="一名资深技术人员站在共享设计桌前，连接客户场景、团队协作空间和软件架构城市，多个角色沿清晰路径共同工作"><figcaption><p><strong>图 2 · 责任范围扩大，工作的中心也随之移动。</strong> 从个人贡献者到团队贡献者，变化不只是任务更多，而是必须同时理解客户、组织与系统，并让这些原本分离的世界形成一条可以交付结果的路径。</p></figcaption></figure><p class="part-label">第四部分 · 那些无法临时补课的能力</p><h2 id="书单只是地图，实践才会留下地形感"><span class="section-no">08</span><a href="#书单只是地图，实践才会留下地形感" class="headerlink" title="书单只是地图，实践才会留下地形感"></a>书单只是地图，实践才会留下地形感</h2><div class="note"><p><strong>2026 年批注。</strong> 我在原文里列了很长的书单。回头看，那既是当时的真诚建议，也多少暴露了一种技术人的习惯：面对复杂问题，总想先找到一份完整目录，仿佛按顺序读完，能力就会自动安装成功。</p><p>这份清单的问题并不在于书选错了。许多书今天依然值得读。真正需要修正的，是我当时把职业成长写得太像一门有固定先修课程的专业：先学完 Java，再学框架，然后设计、架构、管理，仿佛顺着目录走到最后，就自然会成为一个成熟的技术负责人。现实远没有这么整齐。人通常是在项目先把问题扔到面前之后，才带着疼痛回去寻找那本真正需要的书。</p></div><p>为了保留 2018 年原文的样子，下面把当时提到的书和方法完整列出来。旧版中的购买链接、内网图片和已经失效的网页地址不再保留。</p><h3 id="2018-年原文书单"><a href="#2018-年原文书单" class="headerlink" title="2018 年原文书单"></a>2018 年原文书单</h3><ol><li><strong>Java 与编程基础：</strong> Bruce Eckel《Java 编程思想》；Joshua Bloch《Effective Java》。</li><li><strong>代码质量：</strong> Martin Fowler《重构：改善既有代码的设计》；Steve McConnell《代码大全》；Jon Bentley《编程珠玑》。</li><li><strong>应用框架与数据：</strong> 《Spring 实战》《Spring Boot 实战》《Hibernate 实战》；以及数据库调优、缓存框架、NoSQL 数据库和日志系统等主题。</li><li><strong>系统设计与算法：</strong> 《系统分析与设计方法》《设计模式》《需求分析与系统设计》《面向对象分析与设计》《UML 用户指南》《算法导论》。</li><li><strong>问题发现与技术领导：</strong> Gerald M. Weinberg《咨询的奥秘》《探索需求》《系统化思维导论》《成为技术领导者》。</li><li><strong>业务、沟通与影响：</strong> TOGAF、NGOSS、ITIL 等方法体系；Barbara Minto《金字塔原理》；Drew Fudenberg、Jean Tirole《博弈论》；Robert B. Cialdini《影响力》。</li><li><strong>领域建模与架构：</strong> Eric Evans《领域驱动设计》；Vaughn Vernon《实现领域驱动设计》；Martin Fowler《企业应用架构模式》；George Fairbanks《恰如其分的软件架构》。</li><li><strong>项目、团队与软件中的人：</strong> 《PMBOK 指南》《敏捷软件开发》；Frederick P. Brooks Jr.《人月神话》；Gerald M. Weinberg《程序开发心理学》。</li></ol><p>书当然有用。《咨询的奥秘》《探索需求》和《系统化思维导论》帮助人理解问题；《金字塔原理》和《影响力》训练表达与沟通；领域驱动设计、企业应用架构和软件架构相关著作帮助团队把业务变成结构；《人月神话》《敏捷软件开发》和《程序开发心理学》则提醒我们，软件从来不只是代码问题。</p><p>把这份书单重新摆出来，并不是重新给年轻工程师布置八组作业。更合适的用法，是先从自己真正承担的问题出发：代码已经难以修改，再回去读重构；团队对业务概念争论不休，再去理解领域建模；项目不断延期，再重读《人月神话》。带着问题阅读，书里的概念才不容易停留在漂亮术语上。</p><p>书只能提供概念。真正的能力要在现场形成：你试着说服别人，发现自己的论证有漏洞；你做了一个漂亮架构，半年后发现团队维护不起；你以为客户要的是更多功能，后来才明白他们只是想少犯一次错。读书让人获得语言，实践让人知道这些语言何时成立、何时不成立。等你再回到同一本书，过去随手划过的一句话，可能突然变成了只有亲自走过那段路才看得懂的地形标记。</p><h2 id="身体、挫折和那些不太体面的经历"><span class="section-no">09</span><a href="#身体、挫折和那些不太体面的经历" class="headerlink" title="身体、挫折和那些不太体面的经历"></a>身体、挫折和那些不太体面的经历</h2><p>职业规划很容易只写知识和技能，却忽略一个朴素事实：所有计划最后都要由一个具体的人来执行。到了三十多岁，身体会用比绩效系统更直接的方式给出反馈。睡眠不足、长期不运动和持续高压，不会因为项目重要就暂时失效。</p><p>我以前也常对自己说：“等忙完这一阵，就去锻炼。”后来才发现，忙完这一阵，通常还有下一阵。越是忙的时候，越需要保留让身体恢复的时间，因为清醒、耐心和稳定情绪，本来就是判断力的一部分。</p><p>工作十年还会留下另一种资产：那些不太适合写进成功案例的经历。团队磨合失败、技术方案争执、平台优先还是业务优先的拉扯、士气低落、个人低谷，以及一个自己曾经极力坚持、最后被证明错误的决定。</p><p>经历本身不会自动产生价值。只有当一个人愿意回看：当时发生了什么，我忽略了谁的信号，下一次怎样更早发现——失败才会慢慢沉淀为判断。等你成为团队里需要给出方向的人，大家真正期待的不是你从未遇到过困难，而是遇到相似困难时，你不会只剩下慌乱。</p><h2 id="提前准备的意义，不是提前制造焦虑"><span class="section-no">10</span><a href="#提前准备的意义，不是提前制造焦虑" class="headerlink" title="提前准备的意义，不是提前制造焦虑"></a>提前准备的意义，不是提前制造焦虑</h2><p>我曾见过一些准备得很早的同学。他们希望在毕业第七年左右，就开始承担通常在第十年才会面对的职责。于是他们不只列学习计划，还主动争取复杂项目，练习带人、沟通和业务判断，有人甚至通过创业经历理解资源、现金流和结果责任。</p><p>等他们真正走到第十年时，那些所谓“高阶能力”已经练习了三年。差距不再只是多读几本书，而是多经历了几个完整的判断—行动—反馈循环。这样的差距，很难靠晋升前几个月突击补齐。</p><p>但提前准备不是把职业生涯变成一张令人窒息的倒排计划。计划的意义，是提醒我们为重要但不紧急的成长保留位置：不要等到必须带团队时才第一次学习倾听，不要等到负责业务时才第一次关心客户，也不要等身体发出警报时才想起健康。</p><p class="part-label">第五部分 · 回到那把衡量一年的尺子</p><h2 id="如果不用晋升衡量，这一年究竟留下了什么"><span class="section-no">11</span><a href="#如果不用晋升衡量，这一年究竟留下了什么" class="headerlink" title="如果不用晋升衡量，这一年究竟留下了什么"></a>如果不用晋升衡量，这一年究竟留下了什么</h2><p>回到最初的问题：一个技术人，应该怎样衡量自己的一年？</p><p>2018 年的我不会否认职级和薪资的现实意义。它们影响机会，也影响生活。但如果一年只剩下一次绩效结果，很多真正重要的变化就会从视野里消失。</p><p>或许可以在年底给自己留出一个安静的下午，重新回答这些问题：</p><ul><li><strong>问题：</strong> 我今年能够处理的问题，比去年更复杂、更接近真实吗？</li><li><strong>手艺：</strong> 我的输出是否更可靠、更容易维护，也更经得住时间？</li><li><strong>影响：</strong> 是否有人因为我的解释、支持或示范，做出了更好的工作？</li><li><strong>判断：</strong> 我是否从一次失败中改变了后来的决定，而不是只多了一个故事？</li><li><strong>生活：</strong> 我是否还能以健康、清醒和不耗尽自己的方式继续走下去？</li></ul><p>这些问题没有统一分数，也不一定能写进晋升材料。但它们能让成长从一次遥远的裁决，变成每天可以观察的事实。当你清楚自己正在获得什么、还缺少什么，来自上级和同事的反馈也不再是对自我价值的最终宣判，而只是校准方向的一组信号。</p><div class="callout"><p><strong>来自 2026 年的小注。</strong> 八年后的软件世界已经变化太多，今天的我不会再原样画出这条职业路线。特别是 AI 改变了代码生产、学习方式和团队协作以后，许多旧刻度都需要重新讨论。不过这一次，先让 2018 年的答案留在它自己的时间里；新的答案，下一篇再写。</p></div><p>人的一年当然无法被一张表完整衡量。它存在于那些你终于能承担的困难里，也存在于你帮助别人少走的一段弯路里；存在于一次可靠交付、一次诚实认错、一次没有透支自己的坚持里。</p><p>晋升会记录其中一部分。剩下的部分，需要我们自己看见。</p><section class="references" id="references"><h2 data-no-number="true">版本说明</h2><ol><li id="ref-1">Rocky Yu，《关于技术人员的职业发展规划的思考和建议》，初稿发布于 2018 年 4 月 30 日；本版于 2026 年 7 月重新整理语言、结构与配图。</li></ol></section>]]>
    </content>
    <id>https://ryu.xin/zh/posts/measuring-a-programmers-year/</id>
    <link href="https://ryu.xin/zh/posts/measuring-a-programmers-year/"/>
    <published>2018-04-30T22:49:20.000Z</published>
    <summary>一篇写于 2018 年 4 月的职业发展旧文：从一次绩效沟通出发，讨论技术人如何越过晋升这把单一刻度，看见能力、影响力、判断力与长期积累。</summary>
    <title>技术人的一年，应该怎样衡量？</title>
    <updated>2026-07-31T16:00:00.000Z</updated>
  </entry>
</feed>